跳到正文
AI NEWS JOURNAL
AI, IN PERSPECTIVE

搜索 AI 资讯

检索标题、摘要与正文,把分散的信息连起来。

按发布时间排序

2026年最受关注的AI可穿戴设备盘点:Bee、Friend、Limitless等十余款新品集中亮相

TechCrunch于2026年10月25日发布综述,汇总Bee、Friend、Limitless、Muse Charm、Nirva、Omi、Plaud NotePin、Rabbit R1、Stream环等十余款AI可穿戴设备,涵盖价格、功能定位、上市状态及隐私争议。

The hottest AI wearables and gadgets you should know about

推荐理由:该报道系权威科技媒体TechCrunch在2026年10月25日发布的年度新品 roundup,覆盖当前主流AI硬件厂商与初创公司,信息维度完整(价格、形态、核心功能、上市节奏、争议点),且所有陈述均基于材料中明确出现的事实,无推测或引申。
事件进展与其他报道

Anthropic推出免费AI漏洞扫描器OSS Scanner,面向关键开源项目

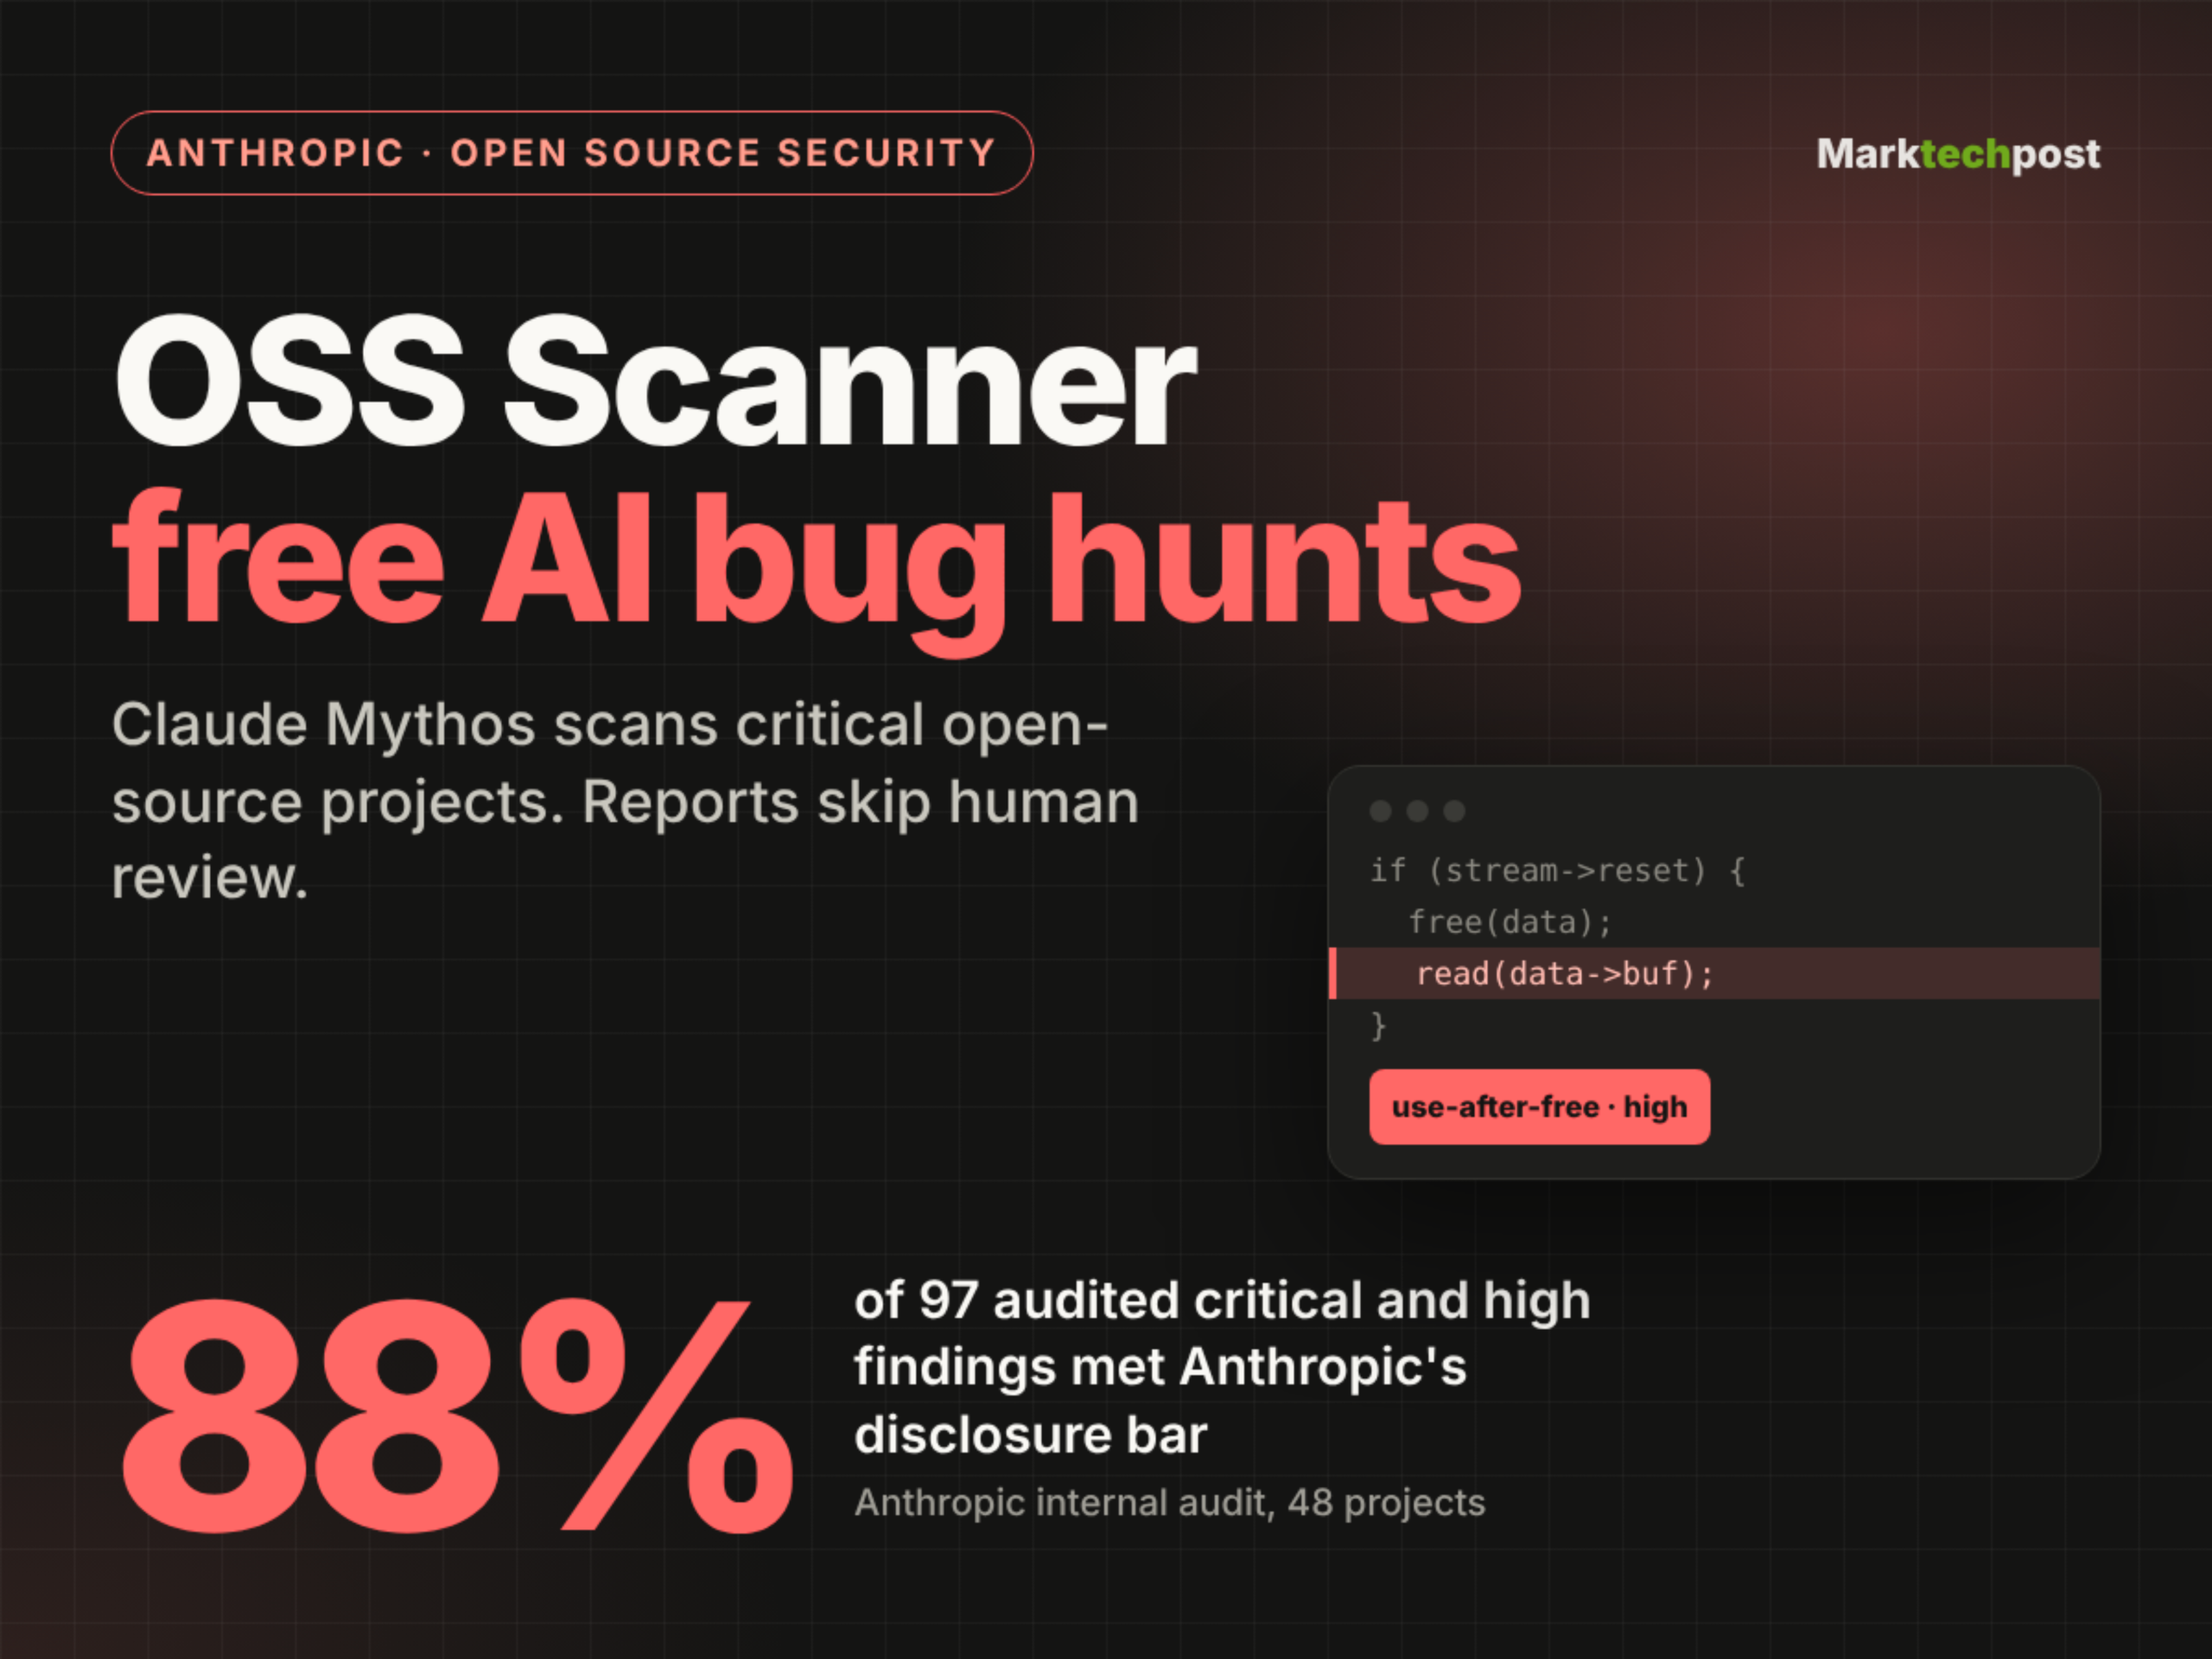
Anthropic于2026年10月8日推出OSS Scanner——一款基于Claude Mythos等强模型的免费、可选加入式AI漏洞扫描工具,专为关键开源项目设计;截至10月19日,已接收114个项目,11天内报告77个严重级和803个高级别漏洞(模型评级),88%的抽样审计结果符合其披露标准。

Anthropic Launches OSS Scanner, a Free AI Vulnerability Scanner

推荐理由:该工具代表LLM在开源安全领域的规模化落地实践,以零成本、全自动、离线审计为特点,但跳过人工审核环节带来误报与重复问题风险;其精度数据(88%有效率、1%假阳性)和真实项目反馈(如wolfSSL、curl)提供了当前AI驱动漏洞发现能力的实证基准。

事件进展与其他报道

Kimi发布K3.1 Pro:终端任务能力跃居榜首,仿真调试与多模态编程展现具身智能雏形

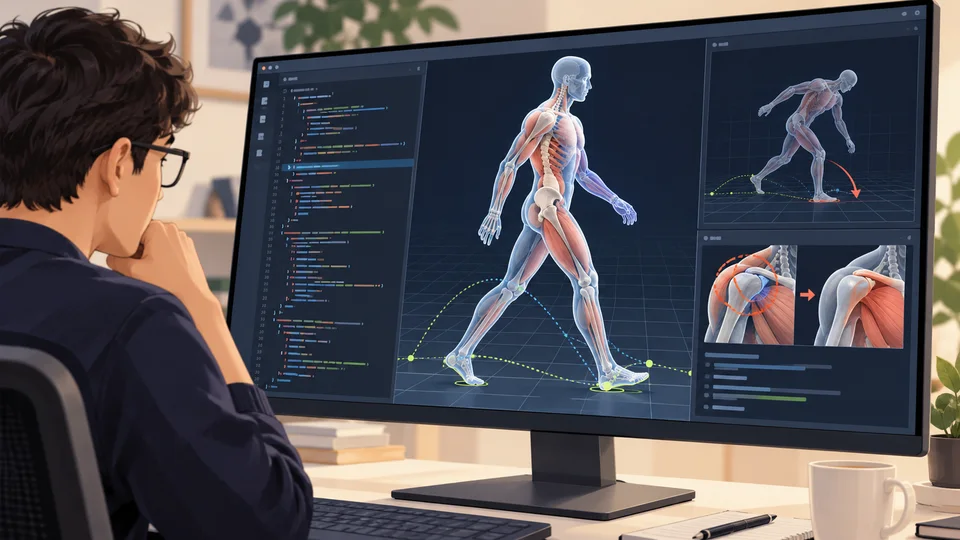
Kimi于2026年10月25日发布K3.1 Pro模型,在Terminal-Bench 4.0终端任务测试中以67.2%成功率位列第一;其自主修复仿真器错误、完成物理模拟、音频分析、3D场景构建及视频剪辑等多任务能力,指向具身智能技术路径探索。

根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

推荐理由:材料基于钛媒体授权发布的实测报告,涵盖权威第三方评测数据(Artificial Analysis、Terminal-Bench 4.0等)、官方自测结果及作者多场景功能验证,聚焦K3.1 Pro在执行能力、仿真闭环、多模态编程上的实质性进步,同时明确标注性能局限与未公开信息(如Flash/Ultra尚未发布),符合事实核查与信源标注要求。

事件进展与其他报道

面板厂商集体涨价应对AI引发的上游成本挤压,但下游接受度低、终端品控承压

2026年9月起,TCL华星、京东方、惠科等面板厂商密集发布涨价函,主因AI大模型发展导致HBM需求激增,挤占成熟制程芯片产能,推高驱动IC、PCB、玻璃基板等关键物料价格;康宁等上游供应商同步提价。尽管成本端压力明确,但下游电视/显示器品牌采购价未普涨,终端用户投诉过热、黑点等品控问题频发,涨价尚未转化为实际成交与体验升级。

AI大模型狂飙,面板行业也扛不住了

推荐理由:材料系统揭示了AI产业对非直接关联硬件行业的跨链传导机制——非因AI拉动面板需求,而是通过晶圆产能再分配引发全链条成本重定价;同时呈现涨价行为与市场真实反馈(价格僵持、出货下滑、用户投诉)之间的显著落差,凸显产业议价权与产品力不匹配的深层矛盾。

事件进展与其他报道

拉上英伟达硬刚苹果,微软的高端AI PC赌局

微软以采用NVIDIA RTX Spark的Surface Laptop Ultra争取本地AI开发者与高端创作者。硬件把大容量统一内存、CUDA和RTX图形能力带入便携设备,但能否形成对Mac的持续竞争,仍取决于应用适配、智能体体验和真实工作流。

推荐理由:这场竞争最终要回答的,是本地AI能否切实改善创作和开发效率,以及用户为此承担的设备、软件与迁移成本是否值得。硬件提供了新的可能性,生态和实际体验决定这种可能性能够覆盖多少用户。

事件进展与其他报道

苹果首款折叠屏iPhone Duo开售即现集中性屏幕开裂问题

多名用户反馈苹果首款折叠屏手机iPhone Duo开箱后短时间内出现铰链正上方屏幕爆线、开裂,故障高度集中;澳洲及国内均有案例,疑似铰链装配公差所致;苹果官方尚未回应,售后判定结果将决定是否免费更换或高额自费维修。

推荐理由:事件涉及新机大规模早期质量异常,直击消费者权益与企业责任边界,且叠加三包法规适用性、AppleCare+服务定位等公共议题,具有典型警示意义和维权参考价值。

事件进展与其他报道

Sebastian Raschka发布八视频课程《从零构建推理模型》

Sebastian Raschka于2026年10月24日在Ahead of AI杂志(magazine.sebastianraschka.com)发布一套共八讲、超11小时的Python与PyTorch实操视频课程,系统讲解推理模型的评估、推理时扩展、强化学习(RLVR)与知识蒸馏,基于预训练Qwen3-0.6B模型实现全部方法。

推荐理由:该课程是作者继《从零构建大语言模型》后推出的进阶技术教育内容,聚焦当前主流LLM的核心演进方向——推理能力增强,覆盖从基础环境搭建到GRPO强化学习、自蒸馏等完整技术链,且明确声明所有实现均‘从零手写’、可复现,具备强教学性与工程参考价值。

事件进展与其他报道

Anthropic开源OS级沙箱sandbox-runtime:为AI代理提供无容器的文件与网络隔离

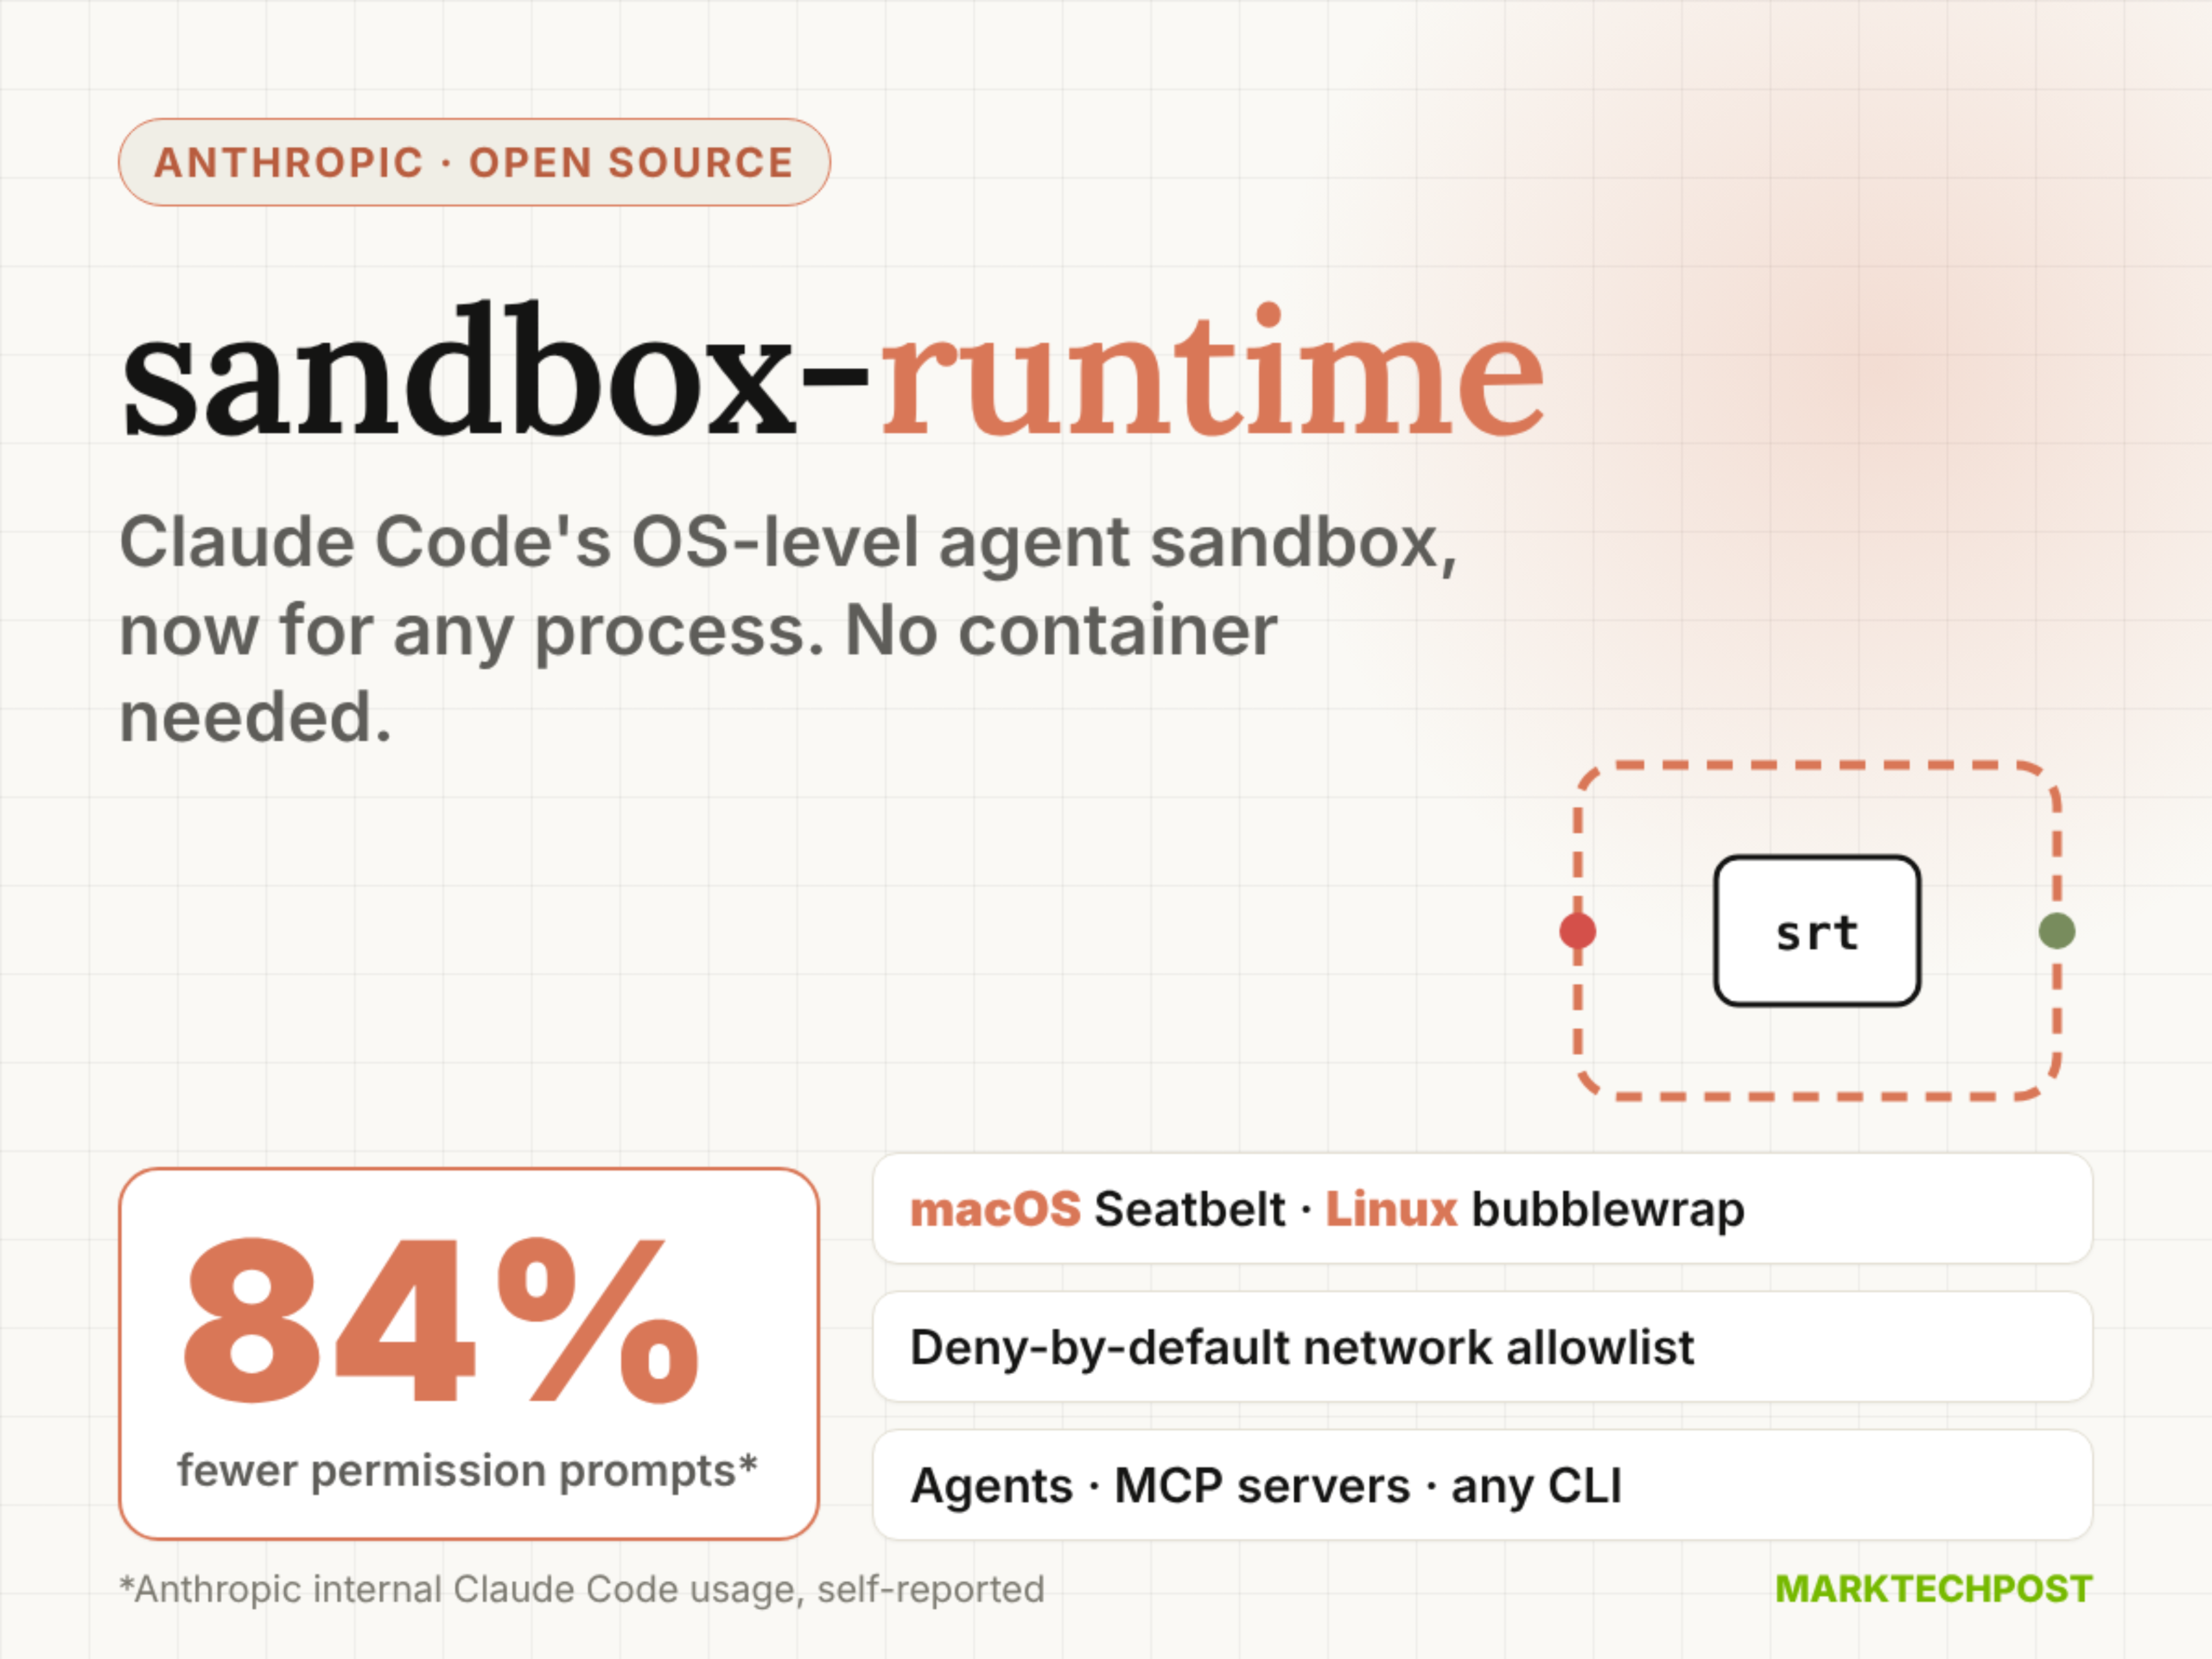
Anthropic于2026年10月24日开源sandbox-runtime(srt),一款不依赖容器的OS级沙箱工具,用于限制AI代理、MCP服务器及CLI工具的文件读写与网络访问权限;支持macOS(Seatbelt)、Linux(bubblewrap)及Windows(alpha),npm包v0.0.81,Apache-2.0许可。

Meet Anthropic’s sandbox-runtime: OS-Level Sandboxing for AI Agents, No Containers

推荐理由:该工具代表AI安全基础设施的重要演进——通过操作系统原生隔离机制实现细粒度、进程树全覆盖的沙箱控制,直面提示注入与权限泛滥风险,且已投入Claude Code内部使用验证效果。

事件进展与其他报道

TRIAD发布:首个面向全模态歧义消解的多模态大模型评测基准

2026年10月24日,研究者在arXiv发布论文arXiv:2610.30841v1,正式推出TRIAD基准——专用于评估文本、图像与音频三模态协同歧义消解能力的新评测框架。该基准含327个手工构建的三模态样本,覆盖86个场景组和18类跨模态歧义类型。

TRIAD: Benchmarking Omni-Modal Ambiguity in Multimodal Large Language Models

推荐理由:该成果直击当前多模态大模型评测的核心盲区:现有基准多聚焦确定性输入下的感知或推理,而TRIAD首次系统性地以‘模态互补消歧’为评测目标,通过严格设计的留一模态反事实测试,揭示模型(尤其对音频)利用不足、场景级鲁棒性薄弱等关键缺陷,为下一代全模态模型评估提供可复现的诊断协议与分类法。

事件进展与其他报道

TutorCaseBench发布:首个面向特殊教育场景的LLM家教评估基准

2026年10月24日,研究者在arXiv(编号2610.30828v1)发布TutorCaseBench——一个基于教育学、教育心理学与特殊教育真实案例构建的LLM家教评估基准,聚焦支持存在学习与行为困难学生的能力。该基准含923段对话、覆盖5类挑战行为,采用开放式生成(1560题)与多选题(2537题)双轨评估;11个前沿大模型中表现最优者仅在55.8%的开放题中满足评估标准。

TutorCaseBench: A Case-Grounded Benchmark for Evaluating LLM Tutors in Supporting Students with Challenging Behaviors

推荐理由:该研究填补了现有AI教育评估忽视特殊需求学生行为复杂性的关键空白,方法论强调证据溯源(qualitative case studies + source-grounded rubrics),数据全部开源,具备可复现性与教育实践相关性;结果明确揭示当前LLM在情境化响应生成上的显著短板,对教育AI落地具警示与指导价值。

事件进展与其他报道

临床医生主导构建可验证安全守则:为心理健康聊天机器人设置可追溯的守卫层

2026年10月24日,arXiv发布论文arXiv:2610.30690v1,提出一种由两名临床医生主导定义、定稿与裁决的四条安全检查规则库,经形式化验证后作为守卫层应用于心理健康场景下的大语言模型(LLM)输出。该守卫层所有判断均可从一条命名规则和十六个事实复现,旨在提升安全性判断的可解释性与可检验性。

From Clinical Judgment to Checkable Rules: Clinician-Led Guardrails for Mental-Health Chatbots

推荐理由:该研究提供了一种区别于主流prompt工程、LLM-as-a-Judge或Constitutional AI的安全增强路径,其核心创新在于将临床决策结构化、形式化并全程留痕;所有关键主张(如规则数量、验证方式、事实基数、对比实验数据及成本测量)均来自原文明确陈述,且发布时间(2026-10-24)与当前UTC日期(2026-10-25)一致,具备时效性与可信基础。

事件进展与其他报道

研究提出自评估强化学习框架SARL,提升检索增强大模型的搜索状态感知能力

2026年10月24日,arXiv发布论文arXiv:2610.30435v1,提出Self-Assessment Reinforcement Learning(SARL)框架,旨在解决现有检索增强大语言模型中搜索代理缺乏搜索状态感知能力的问题。

Self-Assessment Reinforcement Learning for Search-State Awareness in Retrieval-Augmented Large Language Models

推荐理由:该研究针对检索增强型大语言模型在复杂任务中因无法识别已获/缺失信息而导致幻觉推理和过早终止搜索的关键缺陷,提出无需测试时额外评估的端到端强化学习方案,并在多跳推理与深度研究基准上取得显著性能提升。

事件进展与其他报道

研究发现词长可直接提示普通话同音词身份:arXiv新论文揭示词频与发音时长的认知关联

2026年10月24日,arXiv发布题为《通过词长直接提示词身份:来自普通话同音词的证据》的新论文(arXiv:2610.30682v1),报告实验表明,在缺乏其他语音线索或高噪声条件下,普通话母语者能依据双音节同音词的发音时长差异判断其词频高低,较短发音倾向被识别为高频词,提示词长可能作为语音细节被存入心理词典并参与口语词识别。

Direct cueing of word identity through word duration: evidence from Mandarin homophones

推荐理由:该研究以汉语丰富的双音节同音词为切入点,采用同音词排序任务,控制词频变量,在严苛听觉条件下验证词长的功能性作用;结果为‘词频效应’提供了跨语言语音实现机制的新证据,并挑战了词长仅属副语言现象的传统观点,具有心理语言学与言语感知理论双重意义。

事件进展与其他报道

Lighthouse:首个面向美国民权运动史的可信数字助手发布

论文arXiv:2610.30158v1于2026年10月24日发布,介绍名为Lighthouse的首个专用于探索美国民权运动时期历史(基于南卡罗来纳州档案数据)的数字助手。其核心创新在于以可信内容与用户伤害减缓为设计原则,采用神经符号混合架构,融合大语言模型与规则化符号求解。

Lighthouse: On Building a Trustworthy Digital Assistant for Exploring History with Civil Rights Archives

推荐理由:该研究首次将AI辅助历史探索聚焦于民权运动这一敏感而关键的历史阶段,并明确提出‘可信性’与‘伤害建模’双重约束,区别于通用聊天机器人;其方法论(神经符号结合)、评估方式(含专家共识构建的主观题金标准)及数据规模(超1.8万份原始档案)均具学术示范价值。

事件进展与其他报道

SIM-UT:面向医疗分诊聊天机器人的用户行为模拟评估框架

研究者提出SIM-UT(Simulation of User Behaviour for Triage),一种多轮次、基于真实用户行为模拟的评估方法,用于识别大语言模型(LLM)驱动的医疗分诊聊天机器人在低收入和中等收入国家(LMICs)实际场景中的生态有效失败模式。

SIM-UT: A User Simulation based Evaluation Framework for Medical Triage Chatbots

推荐理由:该框架突破了现有单轮次、英语为主的评测局限,通过5000+轮多语种模拟对话,覆盖印度、南非、肯尼亚三地真实WhatsApp健康项目,首次系统揭示‘临床危险性降级’(de-escalation risk)这一关键失效行为,具有方法论创新性与临床安全警示价值。

事件进展与其他报道