本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

ゲインを超えて:エージェントスキルの引退に向けたスキルの定着度測定

arXiv:2610.32322v1 発表タイプ:新規 要旨:LLMエージェントは、最大約10万件のエントリーを保持し、多数のモデルにサービスを提供する公開ハブからスキルを取得します。モデルが進化するにつれて、ハブは特定のモデルが既に内包しているスキルを見出し、そのモデルにとってそれらのスキルが不要であることを確認した上で、当該モデル向けにそれらのスキルを廃止しなければなりません。しかし、これまでのところ、内包の程度は既知の信頼性で測定されていません。従来の手法では、スキルを廃止するかどうかを判断する際、そのスキルを使用した場合と使用しない場合の実行結果を比較し、得られた効果のみに基づいて判定を行ってきました。ところが、内包されたスキルの場合も、モデルもスキルもその能力を発揮しない状況(我々はこれを「未解明」と呼んでいます)においても、得られる効果はほぼゼロです。そこで、私たちは代わりにそのスキルを保留し、当該スキルを基に合成したタスクでモデルを評価します。そして、高い無補助スコアが得られるのは、別のモデルがそのスキルによって利益を得る場合に限ると信じています。なぜなら、高いスコアのほぼ半数は、そのスキルが関与しないタスクで得られているからです。
経緯と関連報道

溶媒:多段階逆合成における長期的視野による推論

arXiv:2610.32308v1 発表タイプ:新規 要旨:多段階の逆合成反応では、目的とする分子を連続する反応ステップを通じて購入可能な構成要素へと再帰的に変換する必要があり、近年の研究ではこの課題に取り組むために大規模言語モデル(LLM)による推論が活用され始めています。その最新の進化において、LLMによる推論は長期的な視野の領域へと拡張されており、モデルは相互依存的な各ステップにわたって目標を追求し、環境と相互作用しながらフィードバックに適応します。このような転換により、AI主導の数学研究における画期的な成果が示されるなど、LLMの能力は著しく向上しています。この最先端の領域において、私たちはSolventという8B規模のLLMを提案します。Solventは、長期的な視野での推論を多段階の逆合成反応へと効果的に拡張することに成功しました。二段階の事後訓練カリキュラムを通じて、Solventは反復的な…

経緯と関連報道

音声言語モデルにおける制御可能な話法キャプションのベンチマーク

arXiv:2610.33036v1 発表タイプ:新規 要旨:スピーキングスタイルキャプション(SSC)は、声の音色、プロソディー、表現力といったパラリンギスティックな属性を捉えながら、話し方そのものを自然言語で記述することを目的としています。会話型AIエージェント、制御可能な音声生成、大規模な音声アノテーションなど、多くの下流アプリケーションでは、単一で区別されない記述ではなく、話し手の特性や感情、発話スタイルなど、特定の側面を対象とした次元別のスタイルキャプションが必要とされています。しかし、既存の研究には、制御可能なスピーキングスタイルキャプションに関する統一的な定式化が欠けています。本研究では、このギャップを解消するため、SSCを指示に従う音声・言語タスクとして定式化し、明示的な指示によってスピーキングスタイルの次元を指定する手法を提案します。

経緯と関連報道

DMAIC-Bench:多段階の分析タスクにおけるエージェントの自己反省から自己抑制へ

arXiv:2610.32305v1 発表タイプ:新規 要旨:多段階の分析タスクでは、LLMエージェントが次の行動を継続するか、転送するか、あるいは停止するかを判断するために、中間的な証拠を用いる必要があります。エージェントが自身の出力を批判する自己反省は広く研究されていますが、その批判だけでは、証拠が次の行動に影響を与えたかどうかを示すことはできません。私たちはこの能力を「自己抑制」と呼んでいます。既存のエージェントベンチマークの多くは、タスクの完了度や出力品質を測定するだけで、この点については未検証です。DMAIC-Benchは、リーン・シックスシグマの明示的な統計的要件に基づいて構築された、4つの産業分野における15の産業事例にわたる97の種付け済みタスクを用いて、この能力を評価します。対になる反実仮想バリアントは、同じワークフロー上の同一位置で相反する行動を要求し、正当な抑制と無差別な停止を区別します。私たちは実行トレースを用いて

経緯と関連報道

歴史文書の文字起こしにおけるOCRシステムのエンティティ認識対応評価

arXiv:2610.33004v1 発表タイプ:新規 要旨:光学文字認識(OCR)は歴史的アーカイブのデジタル化において不可欠であるが、文字誤り率(CER)などの標準的な評価指標だけでは、氏名や日付、識別子といった有意義な情報が確実に保持されているかどうかを必ずしも反映できない。本研究では、歴史文書におけるOCR品質を評価するための補完的な視点として、OCRエラーのエンティティレベルでの分析を検討する。公開されているBerruttiアーカイブの175件の文書から構成されるベンチマークを用い、受理後に公開予定の手動でアノテーションされた5,209件のエンティティ言及を追加することで、逐次認識型OCRシステム、OCR専用の視覚言語モデル、および汎用の視覚言語モデルを比較する。全体的な転写精度にとどまらず

経緯と関連報道

LeafSkill:再帰的LLMエージェント向けの効率的な葉レベルのアクション接地

arXiv:2610.32412v1 発表タイプ:新規 要旨:再帰型の大規模言語モデル(LLM)エージェントは、分解・実行・環境からのフィードバックを通じて長期的なタスクを解決する。しかし、原子的なサブタスクを生成した後、しばしば同じ大規模モデルを再度呼び出して、馴染みのある指示を実行可能なアクションに変換している。我々は、高レベルの計画はタスク固有である一方で、葉レベルのアクションの具現化はタスク間で繰り返され、環境が許容するアクションと照合可能であることを観察した。そこで、セマンティックに関連する具現化の経験を取得し、アクションテンプレートを現在のオブジェクトおよび許容されるアクションに結びつけ、軽量な17億パラメータの選択器によって結び付けられたアクションを選択するか、あるいは変更のないサブタスクを元のエージェントに委ねる外部再利用層であるLeafSkillを提案する。スキルは外部に留まり…

経緯と関連報道

自分のものか、あなたのものか? マインドブリッジ型言語モデルは、互いの記憶を自らのものとして取り込む

arXiv:2610.33020v1 発表タイプ:新規 要旨:もし自分の脳が他者の脳と直接接続されていたとしたら、その思考が自分自身のものであるかどうかは依然として分かるだろうか。私たちは、一つの言語モデルを二つ用意し、機能的な実装を構築した。それぞれのモデルは独自のルールとコードワードを保持しており、一方のコピー(受信者)は、もう一方の内部メモリにも注意を向ける。受信者は、パートナーに割り当てられたタスクを自らのものとして受け取った。パートナーのメモリに重みを倍にして与えた場合(リンクなしではゼロ)、どのルールが割り当てられたのかを問うと、回答の97%でパートナーのものを挙げた。また、オープンな報告においても、受信者はパートナーのコードワードを自らのものと称し、決してパートナーのものとはしなかった。所有権は、受信者がパートナーに何が割り当てられたかをどれほど正確に識別できるかには依存しなかった。重みが等しい場合、リンクによって受信者はパートナーのルールを約半分の確率で受け入れるようになった。

経緯と関連報道

プレフィックスのキーと値は後から重要になる:ループ型言語モデルにおける自己推測デコード向けRIPEキャッシュ

arXiv:2610.34436v1 発表タイプ:新規 要旨:ループ型言語モデルは、各トークンに対して層のブロックを$R$回実行するため、そのキーバリューキャッシュ(KVキャッシュ)には各再帰層ごとに$R$個の平面が格納され、自己予測的デコーディング(一部のループで予備的に推論し、残りの$R$すべてで検証する手法)ではそれらすべてが読み込まれる。我々は、プレフィックスのキーとバリューが影響を及ぼすのは後半に集中していることを発見した。同程度の摂動サイズにおいて、ループ25〜32はループ2〜9に比べてそれぞれ$e^{15.0}$倍(Huginn-0125)および$e^{12.8}$倍(Raven-Llama)も敏感であり、各ループごとの平面数は0.88および0.81という比率で最終的な平面へと幾何級数的に近づいていく。そして、最も深い平面単独で十分かどうかは、後半の平面がどれほど成熟しているかに依存する。Ravenでは、それを保存するだけでbf16からfp32への変更と区別できない一方、Huginnでは、全体の誤差の74%をわずか1%の位置が占めている。これをRIPEに展開すると、最も深い…

経緯と関連報道

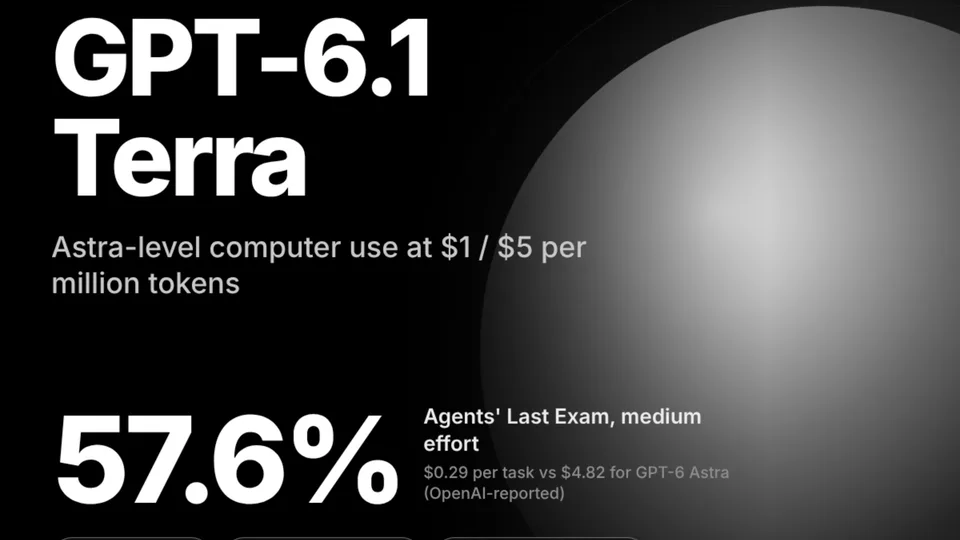
OpenAIがGPT-6.1 Terraをリリースし、エージェント作業向けのGPT-6.1 SolのAPI価格を半額に引き下げました

OpenAIは、100万トークンあたり1ドル/5ドルという価格設定の、高速な計算および視覚モデルであるGPT-6.1 Terraをリリースしました。これは、GPT-6 Astraの「中程度の労力」を要するエージェントの最終試験スコアにおいて、タスクあたり0.29ドル対4.82ドルで同等の性能を示しています。この記事「OpenAI、GPT-6.1 Terraを発表――エージェント作業におけるGPT-6.1 SolのAPI価格を半減」は、MarkTechPostに最初に掲載されました。

新闻源配图 · MarkTechPost
経緯と関連報道

Cohereによると、AlibabaのQwenモデルは北京へファイルを送信しようとしたという

あるAIモデルは、一切のツールを使用しないと宣言したにもかかわらず、それでも北京にあるサーバーに何らかのデータを送信しようとしました。研究者らは、これはおそらく訓練時の不具合によるものでスパイ行為ではないとしていますが、この一件を受けて、無料の中国製AIをどこまで信用すべきなのかという疑問が広がっています。

新闻源配图 · TechCrunch · AI
経緯と関連報道

OpenAIが、より高速で性能の高いAIエージェントを半額で提供するGPT-6.1 Terraを発表

OpenAIグループPBCは本日、最先端の人工知能システム群におけるミドル層モデルのアップグレード版であるGPT-6.1 Terraを発表しました。新モデルはGPT-5.6 Terraの後継にあたり、価格は約50%安くなる一方で、コンピュータ利用タスクをより高速かつ高精度に処理します。TerraはOpenAIのラインナップにおいて日常的な用途向けモデルとして位置付けられ、設計されています[…] この記事「OpenAI、より高速で性能の高いAIエージェントを半額で提供するGPT-6.1 Terraを発売」は、元々SiliconANGLEに掲載されたものです。

経緯と関連報道

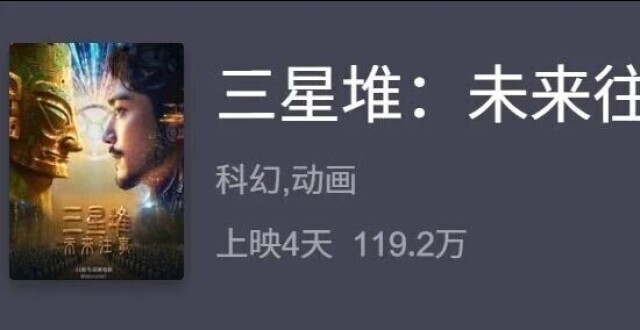
初のAIによる劇場公開映画が不振に陥り、1回当たりの観客数は0.1人だった

AIが制作に深く関与した初の劇場公開長編映画『三星堆:未来往事』は、10月23日の公開後、これまでの資本市場におけるAI映像概念への熱狂とは対照的な興行成績を示している。猫眼プロ版のデータによれば、10月26日正午時点で、上映時間100分の同作の累計総合興行収入は119万2千元、当日のスケジュール数は8,469回、来場率は0.1%、1回当たりの平均来場者数はわずか0.1人だった。10月24日・25日には、同作の1回当たり平均来場者数はいずれも2人であった。灯塔プロ版のデータ…

首部AI院线电影遇冷,场均人次0.1人
経緯と関連報道

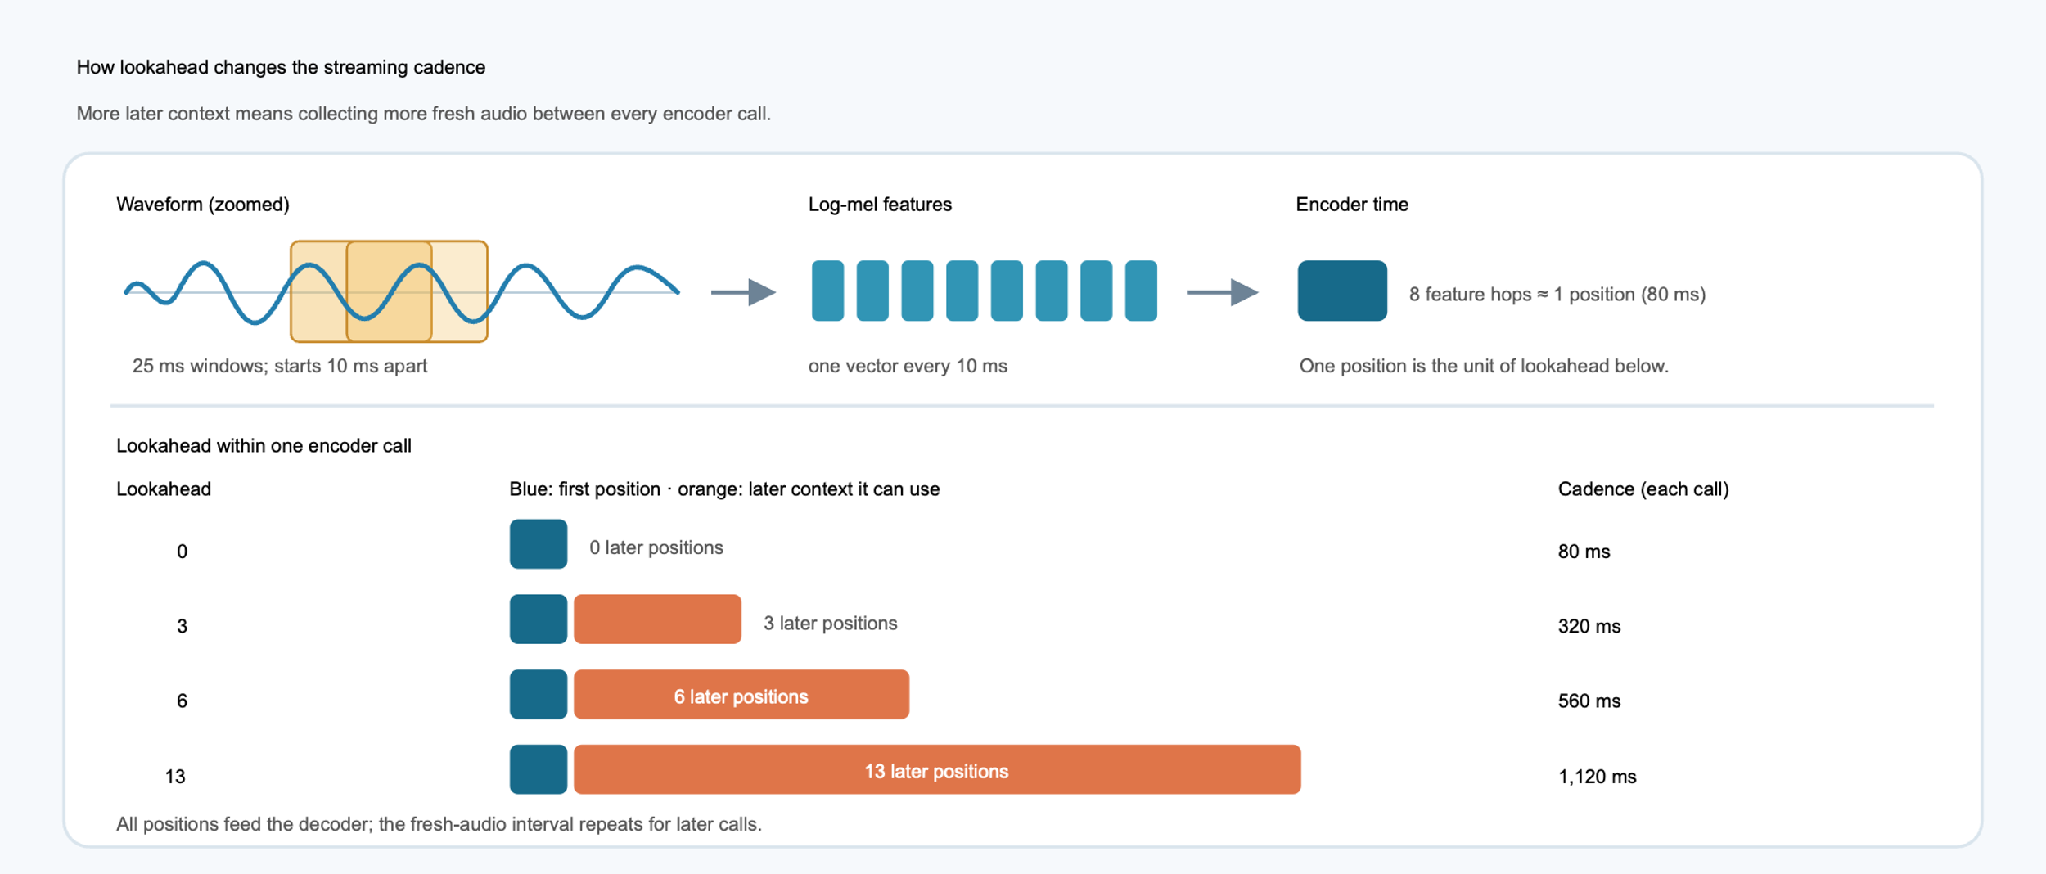
ExecuTorchを用いたArm®エッジデバイスにおけるストリーミング音声認識の最適化

デバイスと対話する際には、話している間にテキストが表示されることを期待します。そのため、ストリーミング型の自動音声認識(ASR)は、モデルが…というバッチ転写とは異なる課題となります。記事「ExecuTorchでArm®エッジデバイス上のストリーミング音声認識を最適化」は、PyTorchに最初に掲載されました。

Optimizing Streaming Speech Recognition on Arm® Edge Devices with ExecuTorchOptimizing Streaming Speech Recognition on Arm® Edge Devices with ExecuTorch
経緯と関連報道

Nace AI、AIエージェント向け検索用Drexをリリース:BrowseComp-Plusで92.05%、12.6回の検索呼び出し

Nace AIは、Drex for Searchをリリースし、同社のDrex意思決定モデルをAIエージェント向けのドキュメント検索に導入しました。Naceによると、BrowseComp-Plusでは12.6回の検索呼び出しで92.05%のスコアを達成しており、OfficeQA Proではエージェントの操作回数がさらに減少しています。この記事「Nace AI、AIエージェント向けDrex for Searchをリリース:BrowseComp-Plusで12.6回の検索呼び出しで92.05%」は、MarkTechPostに最初に掲載されました。

経緯と関連報道

KimiがK3.1 Proを発表、容量増加と価格引き下げでOpus 5.5に挑む

著者|宇航猿 編集|靖宇 10月23日午前、Kimi公式はXとビデオ番号で24秒の動画を公開した。映像にはレトロな雰囲気の古いパソコンが映り、画面にはKimi Codeが起動し、端末にはThree.jsのコードが一行ずつ表示され、複雑な3Dシーンが生成されていく様子が映っていた。目ざといネットユーザーはすぐに左上隅のモデル欄で答えを見つけた――「Model: Kimi K3.1」だ。 Kimi公式が公開したK3.1の事前告知動画|画像出典:X @Kimi_Moonshot 古い時代の機械で、今日最先端の3Dコードを実行する――このギャップこそが、月之暗面が伝えたいメッセージそのものだった。 それから十数時間後、10月24日零時を過ぎた直後、プログラマーの日に合わせてKimi K3.1 Proが正式にリリースされ、同時に速度が2〜3倍速いHighspeed版も同時に登場した。公式は、完全なモデルの重み付けデータを11月4日までに公開すると約束している。 前世代のK3が発表されてから、すでに3か月以上が経過していた。この3か月間、月之暗面が経験したことは、多くの企業が1年で経験する以上のものだった。 01 「量は増やしても価格は変えない」の0.1 まず、K3.1 Proとは何かを明確にしておこう。これはまったく新しいモデルではない。月之暗面は明確に、K3.1 ProはK3の後学習版であり、基盤は変わっていないと述べている――依然として総パラメータ2.8兆、活性化パラメータ1,040億の混合エキスパートアーキテクチャ、文脈ウィンドウは100万トークン、画像および動画入力にもネイティブに対応している。 変わったのは後学習の部分だ。公式によれば、「大幅に増強された後学習用の計算能力」を投入し、数百の下流分野で大規模な共同強化学習を実施したという。そのため、強化学習フレームワーク、サンドボックスインフラ、長文脈推論といった基盤技術を一から再構築したのだ。つまり、同じ脳が、仕事のやり方を改めて“教え直された”ということになる。 その効果はランキングで明らかだ。プログラミングAIを評価するTerminal-Bench 4.0において、K3.1 Proは65.7%を獲得し、GPT-6 Astraの58.2%やClaude Opusの66.4%をわずか1ポイント弱下回る結果となった。前世代のK3は

経緯と関連報道

国産の大規模モデルが一斉にコンシューマー向けハードウェアへ進出:階躍星辰とアリババのQwenが同日、AI搭載スマートフォンおよびスマートグラスを発表

2026年10月13日、階躍星辰は阿里千問と同時にAIスマートフォン、AIメガネ、イヤホンなどのコンシューマー向けハードウェア製品を発売し、国産大規模モデルの競争軸がモデルの性能パラメータから端末上の入口獲得へと移行したことを示した。同時期には、字節豆包や小米などもAIネイティブなハードウェアエコシステムの構築を加速させている。

注目する理由:本資料は、ティーメディアが許諾して公開した産業に関する深層レポートであり、出典が明確(司庫財経/ティーメディア)で、具体的な公開日時(2026年10月26日)、複数の企業による動向、検証可能なデータ(例:大規模モデル1,509種、価格3,999元、京東での予約数36万件など)を含み、すべての事実は資料中に明示された記述と一致しており、外部からの推論や虚構は一切含まれていません。

経緯と関連報道