
斯坦福大学与加州大学伯克利分校的研究人员推出 TokenGate:基于令牌的注意力机制使长上下文预填充速度提升高达 11.3 倍
斯坦福大学与加州大学伯克利分校研究人员提出TokenGate——一种可即插即用的学习型令牌剪枝模块,适用于现有大语言模型(LLM)。该方法在不损失准确率的前提下,将长上下文预填充的首字生成时间(TTFT)加速1.4至11.3倍,峰值内存降低1.5至3.4倍。相关代码与检查点已开源。

检索标题、摘要与正文,把分散的信息连起来。
斯坦福大学与加州大学伯克利分校研究人员提出TokenGate——一种可即插即用的学习型令牌剪枝模块,适用于现有大语言模型(LLM)。该方法在不损失准确率的前提下,将长上下文预填充的首字生成时间(TTFT)加速1.4至11.3倍,峰值内存降低1.5至3.4倍。相关代码与检查点已开源。
Kimi于2026年10月25日发布K3.1 Pro模型,在Terminal-Bench 4.0终端任务测试中以67.2%成功率位列第一;其自主修复仿真器错误、完成物理模拟、音频分析、3D场景构建及视频剪辑等多任务能力,指向具身智能技术路径探索。
推荐理由:材料基于钛媒体授权发布的实测报告,涵盖权威第三方评测数据(Artificial Analysis、Terminal-Bench 4.0等)、官方自测结果及作者多场景功能验证,聚焦K3.1 Pro在执行能力、仿真闭环、多模态编程上的实质性进步,同时明确标注性能局限与未公开信息(如Flash/Ultra尚未发布),符合事实核查与信源标注要求。
Linux基金会10月20日发布报告指出,生成式AI使代码编写耗时平均减少52%,但开源项目维护者估计约25%的Pull Request属低质量“AI slop”;大型项目中该比例升至31%。报告揭示效率红利未同步降低审查与治理成本,仅35%项目制定正式AI贡献政策,维护者倦怠与信任赤字凸显。
微软以采用NVIDIA RTX Spark的Surface Laptop Ultra争取本地AI开发者与高端创作者。硬件把大容量统一内存、CUDA和RTX图形能力带入便携设备,但能否形成对Mac的持续竞争,仍取决于应用适配、智能体体验和真实工作流。
推荐理由:这场竞争最终要回答的,是本地AI能否切实改善创作和开发效率,以及用户为此承担的设备、软件与迁移成本是否值得。硬件提供了新的可能性,生态和实际体验决定这种可能性能够覆盖多少用户。
llama.cpp 项目发布构建版本 b11869,主要修复 Jinja 模板中 select 和 selectattr 函数的参数解析逻辑,并提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的数十种硬件与后端组合的预编译二进制包。
推荐理由:按信源设置仅收录,不参与自动精选
llama.cpp v2.45.0(标签 b11868)正式发布,核心更新为 Hexagon 后端引入 KV-head 团队拆分机制以优化多核 HMX Flash Attention 性能,并统一 FA 拆分控制标志;同步提供 macOS、Linux、Windows、Android、iOS 及 openEuler 等全平台二进制包,含 CUDA 12/13、Vulkan、ROCm、OpenVINO、SYCL、Snapdragon(Adreno+Hexagon)等多后端支持。
推荐理由:按信源设置仅收录,不参与自动精选
llama.cpp 项目发布构建版本 b11865,核心变更包括在 RDMA 接收逻辑中增加内存边界检查(PR #30399),并显著扩展硬件加速支持,覆盖 CUDA 13.4、ROCm 10.0、Vulkan、OpenVINO、SYCL 及高通 Snapdragon(CPU+Adreno+Hexagon)全栈异构计算后端;macOS KleidiAI 支持与 openEuler 构建被明确标记为 DISABLED。
推荐理由:按信源设置仅收录,不参与自动精选
Anthropic于2026年10月24日开源sandbox-runtime(srt),一款不依赖容器的OS级沙箱工具,用于限制AI代理、MCP服务器及CLI工具的文件读写与网络访问权限;支持macOS(Seatbelt)、Linux(bubblewrap)及Windows(alpha),npm包v0.0.81,Apache-2.0许可。
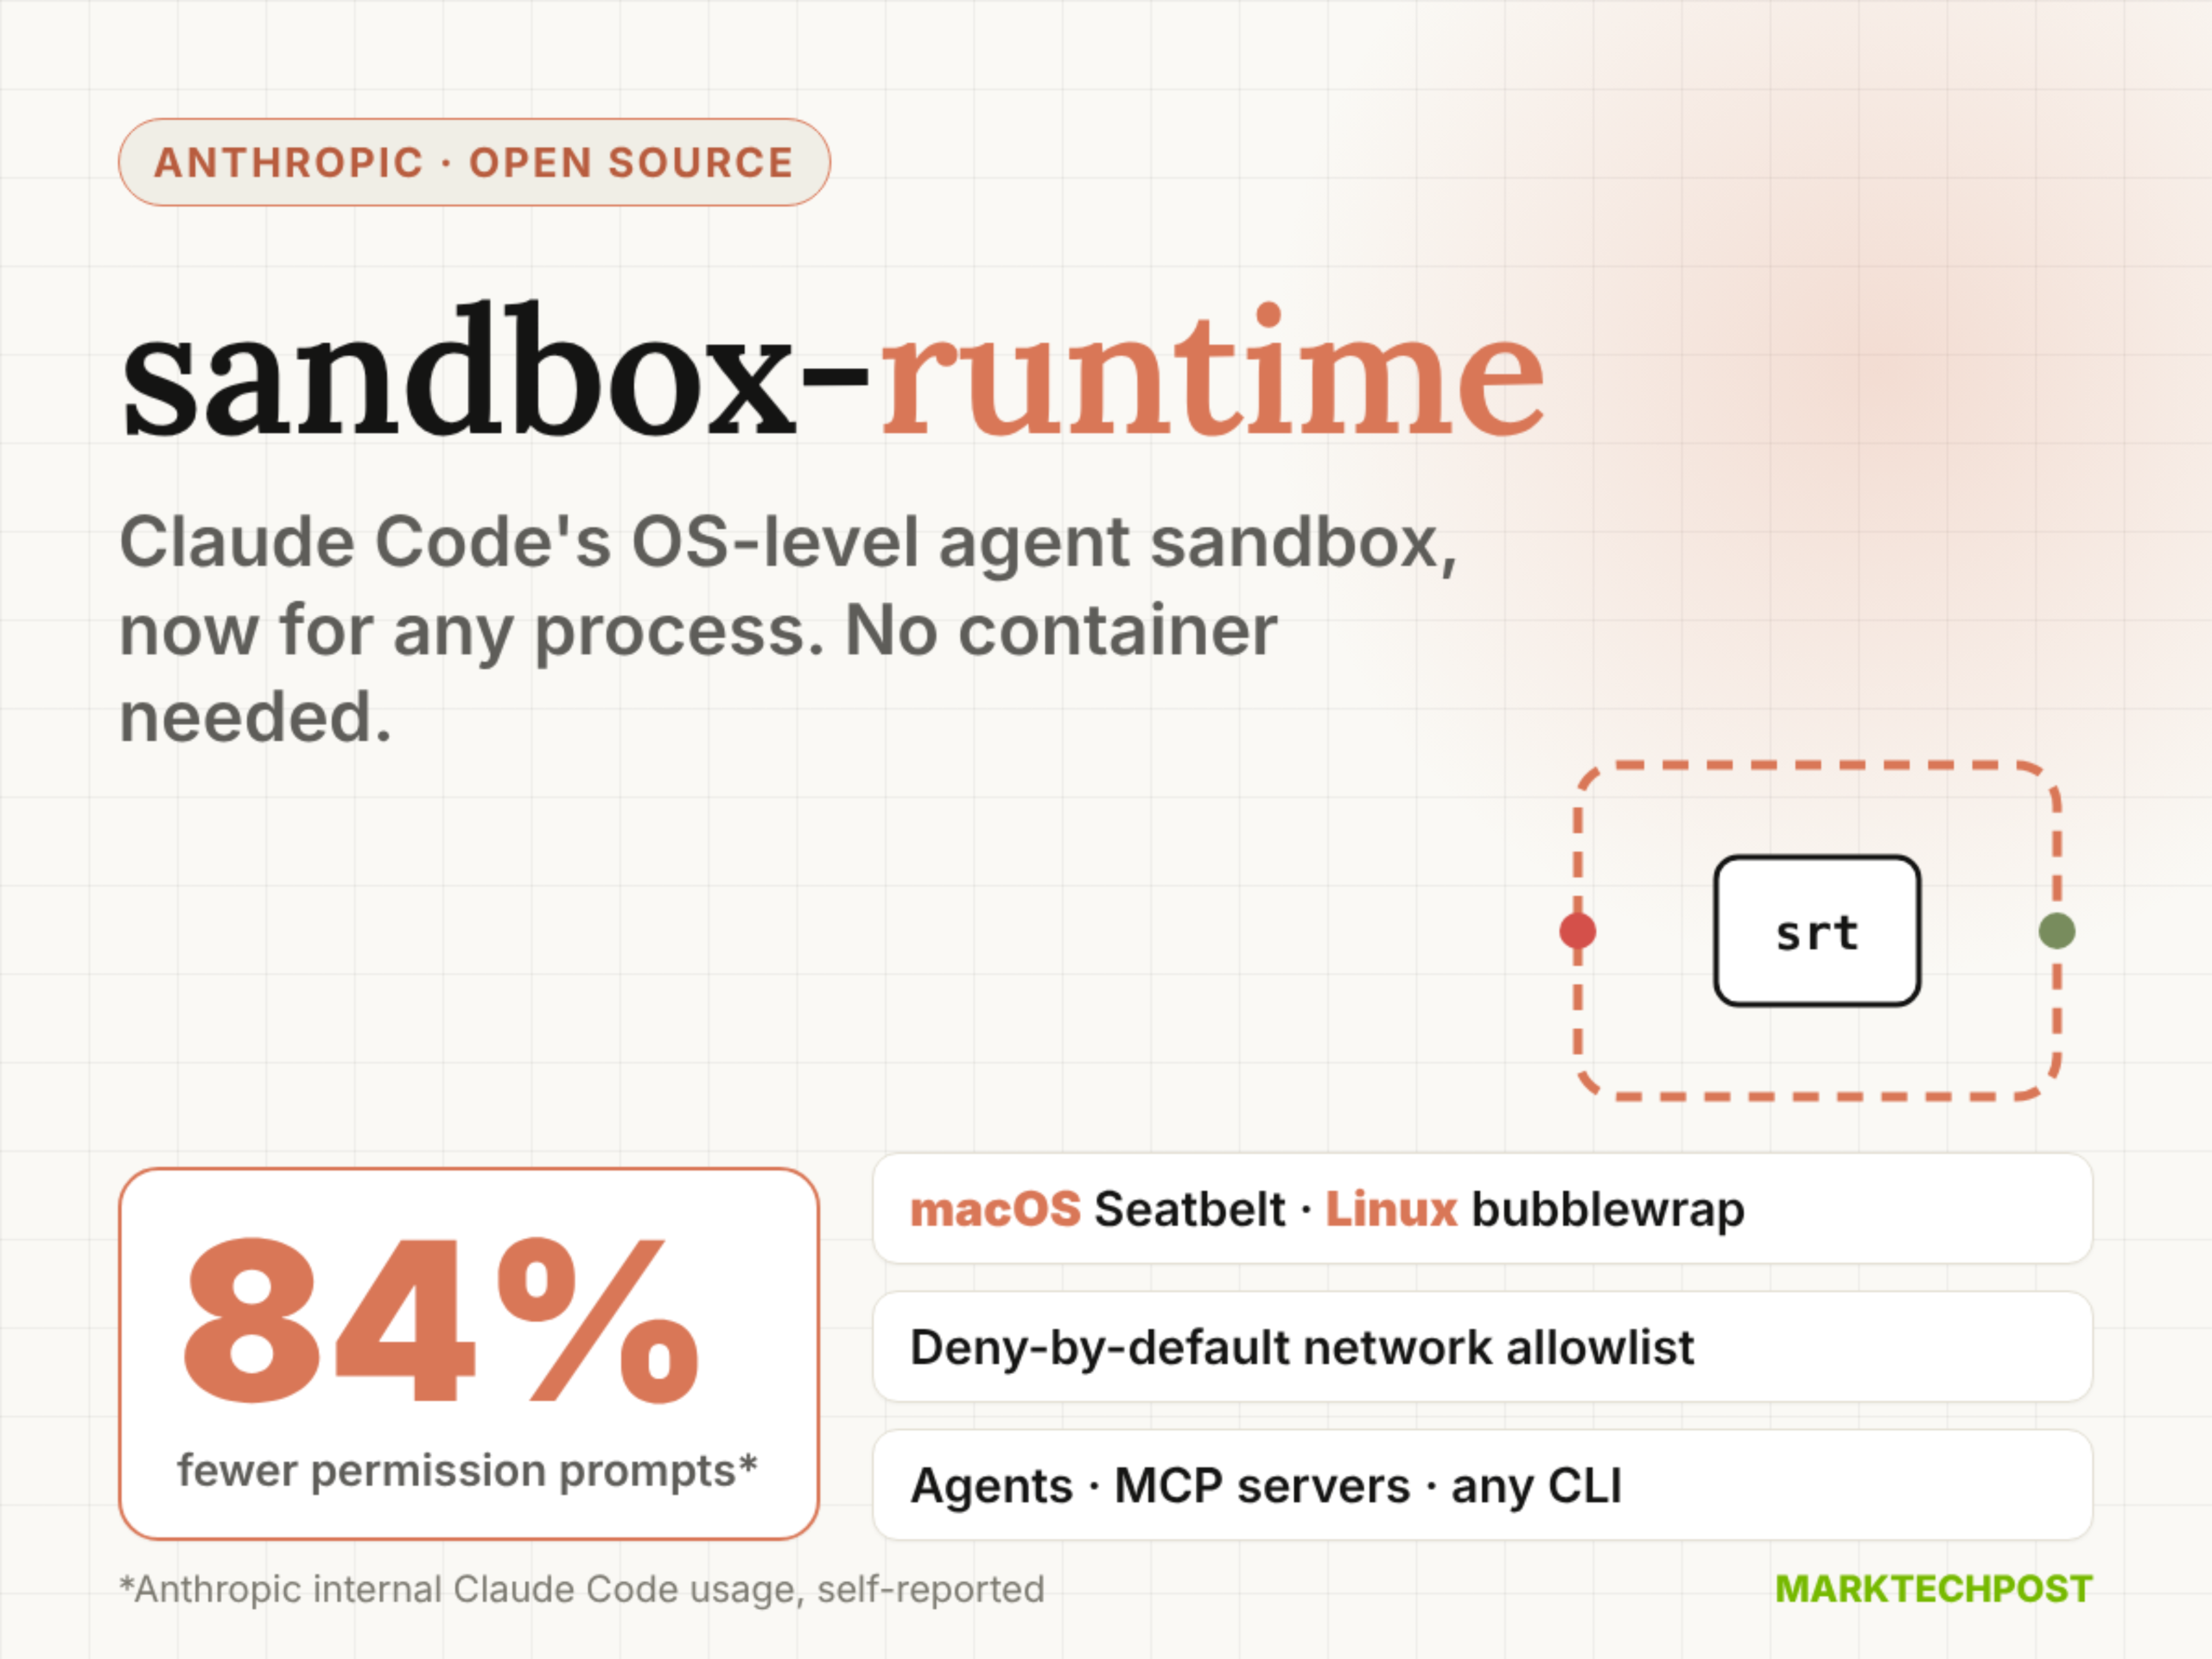
推荐理由:该工具代表AI安全基础设施的重要演进——通过操作系统原生隔离机制实现细粒度、进程树全覆盖的沙箱控制,直面提示注入与权限泛滥风险,且已投入Claude Code内部使用验证效果。
2026年10月24日,arXiv发布论文arXiv:2610.30705v1,提出ULME——一种面向因果解码器型大语言模型的后训练框架,通过预测耦合(predictive coupling)机制,首次实现文本嵌入与语言生成能力的相互增强式统一。该方法在Qwen2.5/Qwen3系列(0.5B–8B参数)上验证有效,MTEB提升3.3–4.1分,同时保持生成任务(MMLU等)性能不降。

推荐理由:该论文直指当前多模态LLM能力割裂的核心问题:嵌入与生成长期由独立模型或仅参数共享的‘伪统一’模型承担。ULME通过可学习插槽与三目标联合训练(含stop-gradient预测损失),使生成过程主动塑造嵌入表征,属架构层面的实质性突破;实验覆盖广、基线强、指标全面,且发布于权威预印本平台,时效性与技术严谨性兼备。
2026年10月24日,研究团队在arXiv发布论文(编号2610.31256v1),推出首个面向印尼语临床营养领域的专家标注问答评测基准IndoNutriQA,含911组真实临床报告衍生的问答对,聚焦评估而非训练,支持生成式、抽取式及检索增强型问答任务。
推荐理由:该基准填补了低资源语言(尤其是印尼语)在临床营养NLP领域高质量公开评测数据的空白,结构化元数据完备、问题类型严格遵循营养护理流程(NCP),并完成专家验证与多模型基准测试,具备明确科研定位与方法学严谨性。
2026年10月24日发布的arXiv论文(2610.31017v1)指出,在文档级LoRA适配器评估中,开放书评分(open-book scoring)高度依赖模型即时阅读能力,而非适配器是否真正编码了对应文档的知识;随机适配器在开放书任务中可复现82%的专家适配器优势,但在无源文本的完形填空(cloze)任务中仅复现2%(统计上不可区分于零)。
推荐理由:该研究通过系统控制实验(150篇维基百科文章、Llama-3.1-8B-Instruct模型、双任务对比)揭示了当前开放书评估范式的根本局限性:它无法有效区分‘读取’与‘记住’,对知识编辑和检索型适配器的实际效用构成方法论挑战;论文同时报告了四个导致‘干净但错误结果’的静默错误,凸显可复现性风险。
Amazon QuickSight 层地图现已支持 GeoJSON 格式的 Point(点)和 LineString(线)几何类型,允许用户在同一地图中分别叠加显示门店位置、配送路线或航班轨迹等;该能力无需第三方服务,但要求 GeoJSON 文件结构合规、键值匹配且静态更新。
拜耳作物科学在Amazon Bedrock AgentCore上构建了Agentic Decision Engine(ADE),一个面向育种专家、分析师与研究人员的自然语言多智能体平台,作为其现有Connected Decision Engine(CDE)的增强层而非替代。该系统已上线生产环境,服务超100名R&D用户,通过22个领域专用智能体与约20个API工具实现约80%问题自助解决。
近期,借助新型AI工具,大量非官方复古游戏跨平台移植项目(如《光环》跑在网页端、《风之杖》登陆iPhone、《任天堂明星大乱斗》进入混合现实)频繁走红;但此类AI加速的‘反编译-重编译’(decomp/recomp)实践正引发老派游戏保存社群的争议与分裂。
随着AI从实验阶段迈向规模化生产,企业竞争力正从模型选择转向围绕模型构建的服务框架(serving harness)——即涵盖架构设计、内存管理、调度策略与推理优化的工程系统。EXL在MIT Technology Review刊文指出,决定AI落地效果的关键不再是模型参数或基准分数,而是能否以可控成本、可靠延迟和可持续扩展性将模型能力转化为业务价值。
Meta在安全研究人员披露Muse共享链接因命名规则和DNS公开导致敏感内容可被轻易发现后,暂停该功能;现经调整后已重新启用。
Discord 近日上线更新,改进了上传 .md 文件后的预览效果,现可正确渲染 Markdown 格式(包括表格、加粗、列表等),不再仅显示原始符号代码。