跳到正文
AI NEWS JOURNAL
AI, IN PERSPECTIVE

搜索 AI 资讯

检索标题、摘要与正文,把分散的信息连起来。

按发布时间排序

上证指数等四只指数编制规则今起调整;国资委部署深化国企改革;标普新规将波及3750亿美元基金

2026年10月26日起,上证指数、上证A股指数、上证流通指数及科创综指正式实施修订后的编制方案,新增单个样本权重15%上限;国务院国资委于10月23日强调扎实推进新一轮国资国企改革任务落地;同日(10月25日),标普道琼斯宣布调整成长/价值股划分标准,新规将于12月21日生效,影响约3750亿美元被动型基金。

推荐理由:三则政策与市场规则变动均具显著时效性与系统性影响:指数权重红线直接关系A股核心基准稳定性;国资委表态体现中央层面对国企改革攻坚的紧迫部署;标普规则重构价值投资逻辑,波及规模达数千亿美元,属全球资本市场重要变量。所有信息均源自钛媒体2026年10月25日发布的权威综合报道,时间节点、主体、措施及影响金额均明确可验。
事件进展与其他报道

LangChain发布“公司级智能体框架”五大核心组件

LangChain于2026年10月25日发布博客,系统阐述其在营销、销售与工程团队内部部署AI智能体(GTM Agent、OpenSWE、Content Studio)所沉淀的五大通用架构原则:原生集成工作环境(Slack)、动态身份模型(OBO+固定凭证)、双层记忆机制(全局/用户级)、沙箱化代码执行、高比例调度运行(非手动触发)。所有智能体均基于Managed Deep Agents平台构建。

推荐理由:该资讯源自LangChain官方博客,发布时间(2026-10-25T18:06:32.000Z)早于当前系统时间(2026-10-25T23:01:18.857Z),内容聚焦已落地的内部智能体实践,细节具体(如Slack线程隔离、GitHub账号归属逻辑、Notion/Twitter权限分层等),未含未经验证的预测或外部宣称,符合时效性与事实性要求。

事件进展与其他报道

Open WebUI v0.12.4 发布:按需加载技能、上下文压缩可视化与百项无障碍及修复更新

Open WebUI v0.12.4 是一个开源大语言模型前端界面的重大维护版本,于可信元数据日期 2026-10-25 前发布。核心更新包括技能按需加载(需启用内置 Skills 工具且默认关闭)、聊天中上下文压缩过程显式标记、覆盖超百项 WCAG 合规的无障碍增强,以及 26 项经 GitHub PR/issue 验证的功能修复与行为修正,含权限控制强化、Safari/RTL/多文件夹等场景缺陷修复。未引入新模型、API 或第三方服务,无性能基准、用户数据或监管信息。

推荐理由:按信源设置仅收录,不参与自动精选

事件进展与其他报道

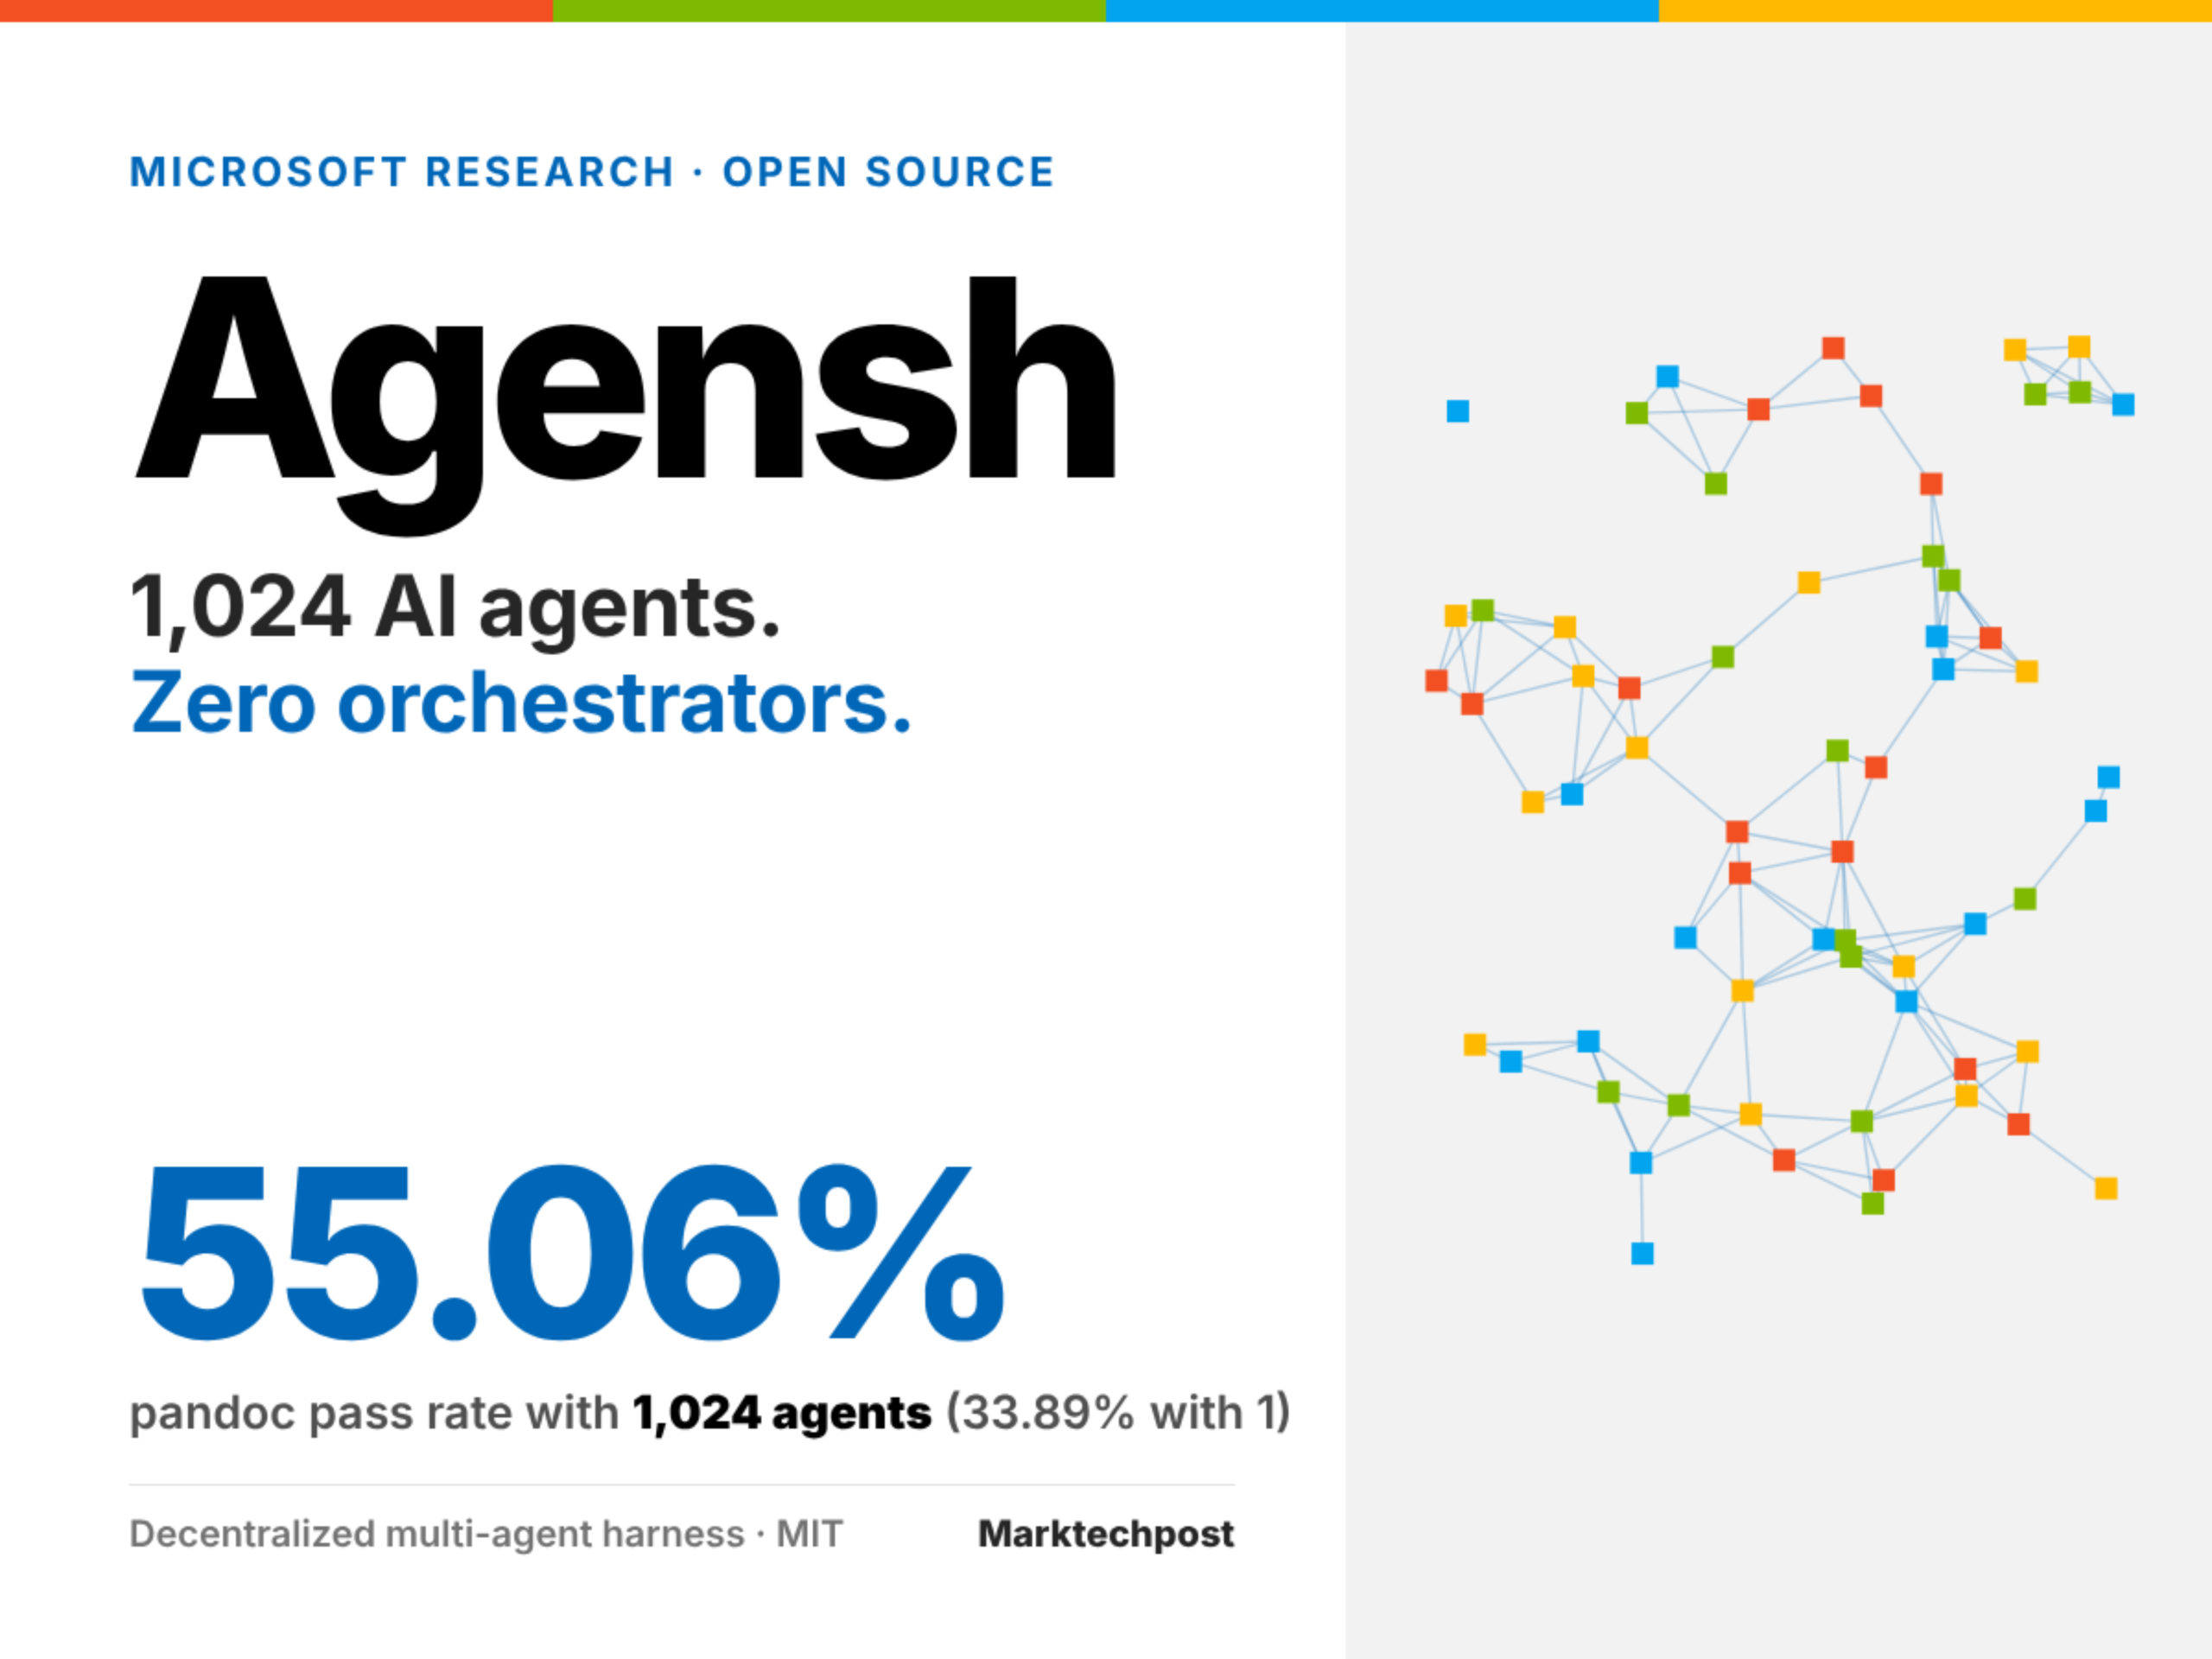
微软开源Agensh:支持1024个自主协作AI编码代理的去中心化框架

微软研究院于2026年10月25日开源Agensh,一种无需中央协调器的多代理运行时框架,支持1至1024个LLM编码代理在ProgramBench上自组织协作。系统基于Gitea、Mattermost和DeLM风格共享看板实现去中心化协调,所有代理运行同一提示驱动的五步循环,已在Linux+Docker环境下验证可扩展性。

Microsoft Open-Sources Agensh: A Multi-Agent Harness for 1,024 Agents

推荐理由:该成果代表多智能体系统架构的重要演进——摒弃传统‘主控代理’范式,通过提示工程与轻量服务组合实现大规模自组织;其在ProgramBench上的实证数据(如128代理使5任务均分提升49%)为分布式AI工程提供新基准;MIT许可证开源且兼容Copilot CLI等主流单代理工具,具备实际开发参考价值。

事件进展与其他报道

AI行情杀估值不杀业绩:三季报验证订单能见度,配置资金逆势加仓

2026年9月22日至10月22日,A股AI板块持续调整,创业板指跌24.20%,科创50PE-TTM从264倍回落近六成至110倍上方;但同期业绩集体超预期(宁德时代单季净利212亿元、源杰科技预增近6倍、联讯仪器净利增逾18倍),股票型ETF净流入近700亿元——调整核心是杀估值,而非业绩恶化。

推荐理由:材料明确指出本轮下跌主因是贴现率上行(分母端)与海外监管预期(分子端信心动摇)共同压制估值,而产业景气、订单能见度、一级市场定价及政策豁免安排均未恶化;ETF持续净申购、光模块公司密集公告订单排至2027年等事实,印证市场在估值低位主动承接,逻辑清晰、证据链完整。

事件进展与其他报道

llama.cpp 发布 b11868 版本:增强 Hexagon NPU 多核 Flash Attention 支持,覆盖全平台编译构建

llama.cpp v2.45.0(标签 b11868)正式发布,核心更新为 Hexagon 后端引入 KV-head 团队拆分机制以优化多核 HMX Flash Attention 性能,并统一 FA 拆分控制标志;同步提供 macOS、Linux、Windows、Android、iOS 及 openEuler 等全平台二进制包,含 CUDA 12/13、Vulkan、ROCm、OpenVINO、SYCL、Snapdragon(Adreno+Hexagon)等多后端支持。

推荐理由:按信源设置仅收录,不参与自动精选

事件进展与其他报道

llama.cpp 发布 b11867 版本:服务端入口重构,全面支持多平台与异构加速后端

llama.cpp 于 GitHub 正式发布 b11867 版本,核心变更包括服务端(server)入口点重构(PR #31113),新增 server_role 机制;同时提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的 40+ 预编译二进制包,支持 CPU、CUDA(12.4/12.8/13.4)、Vulkan、ROCm 10.0、OpenVINO、SYCL(FP16/FP32)、Snapdragon(Adreno+Hexagon)等多元硬件后端。

推荐理由:按信源设置仅收录,不参与自动精选

事件进展与其他报道

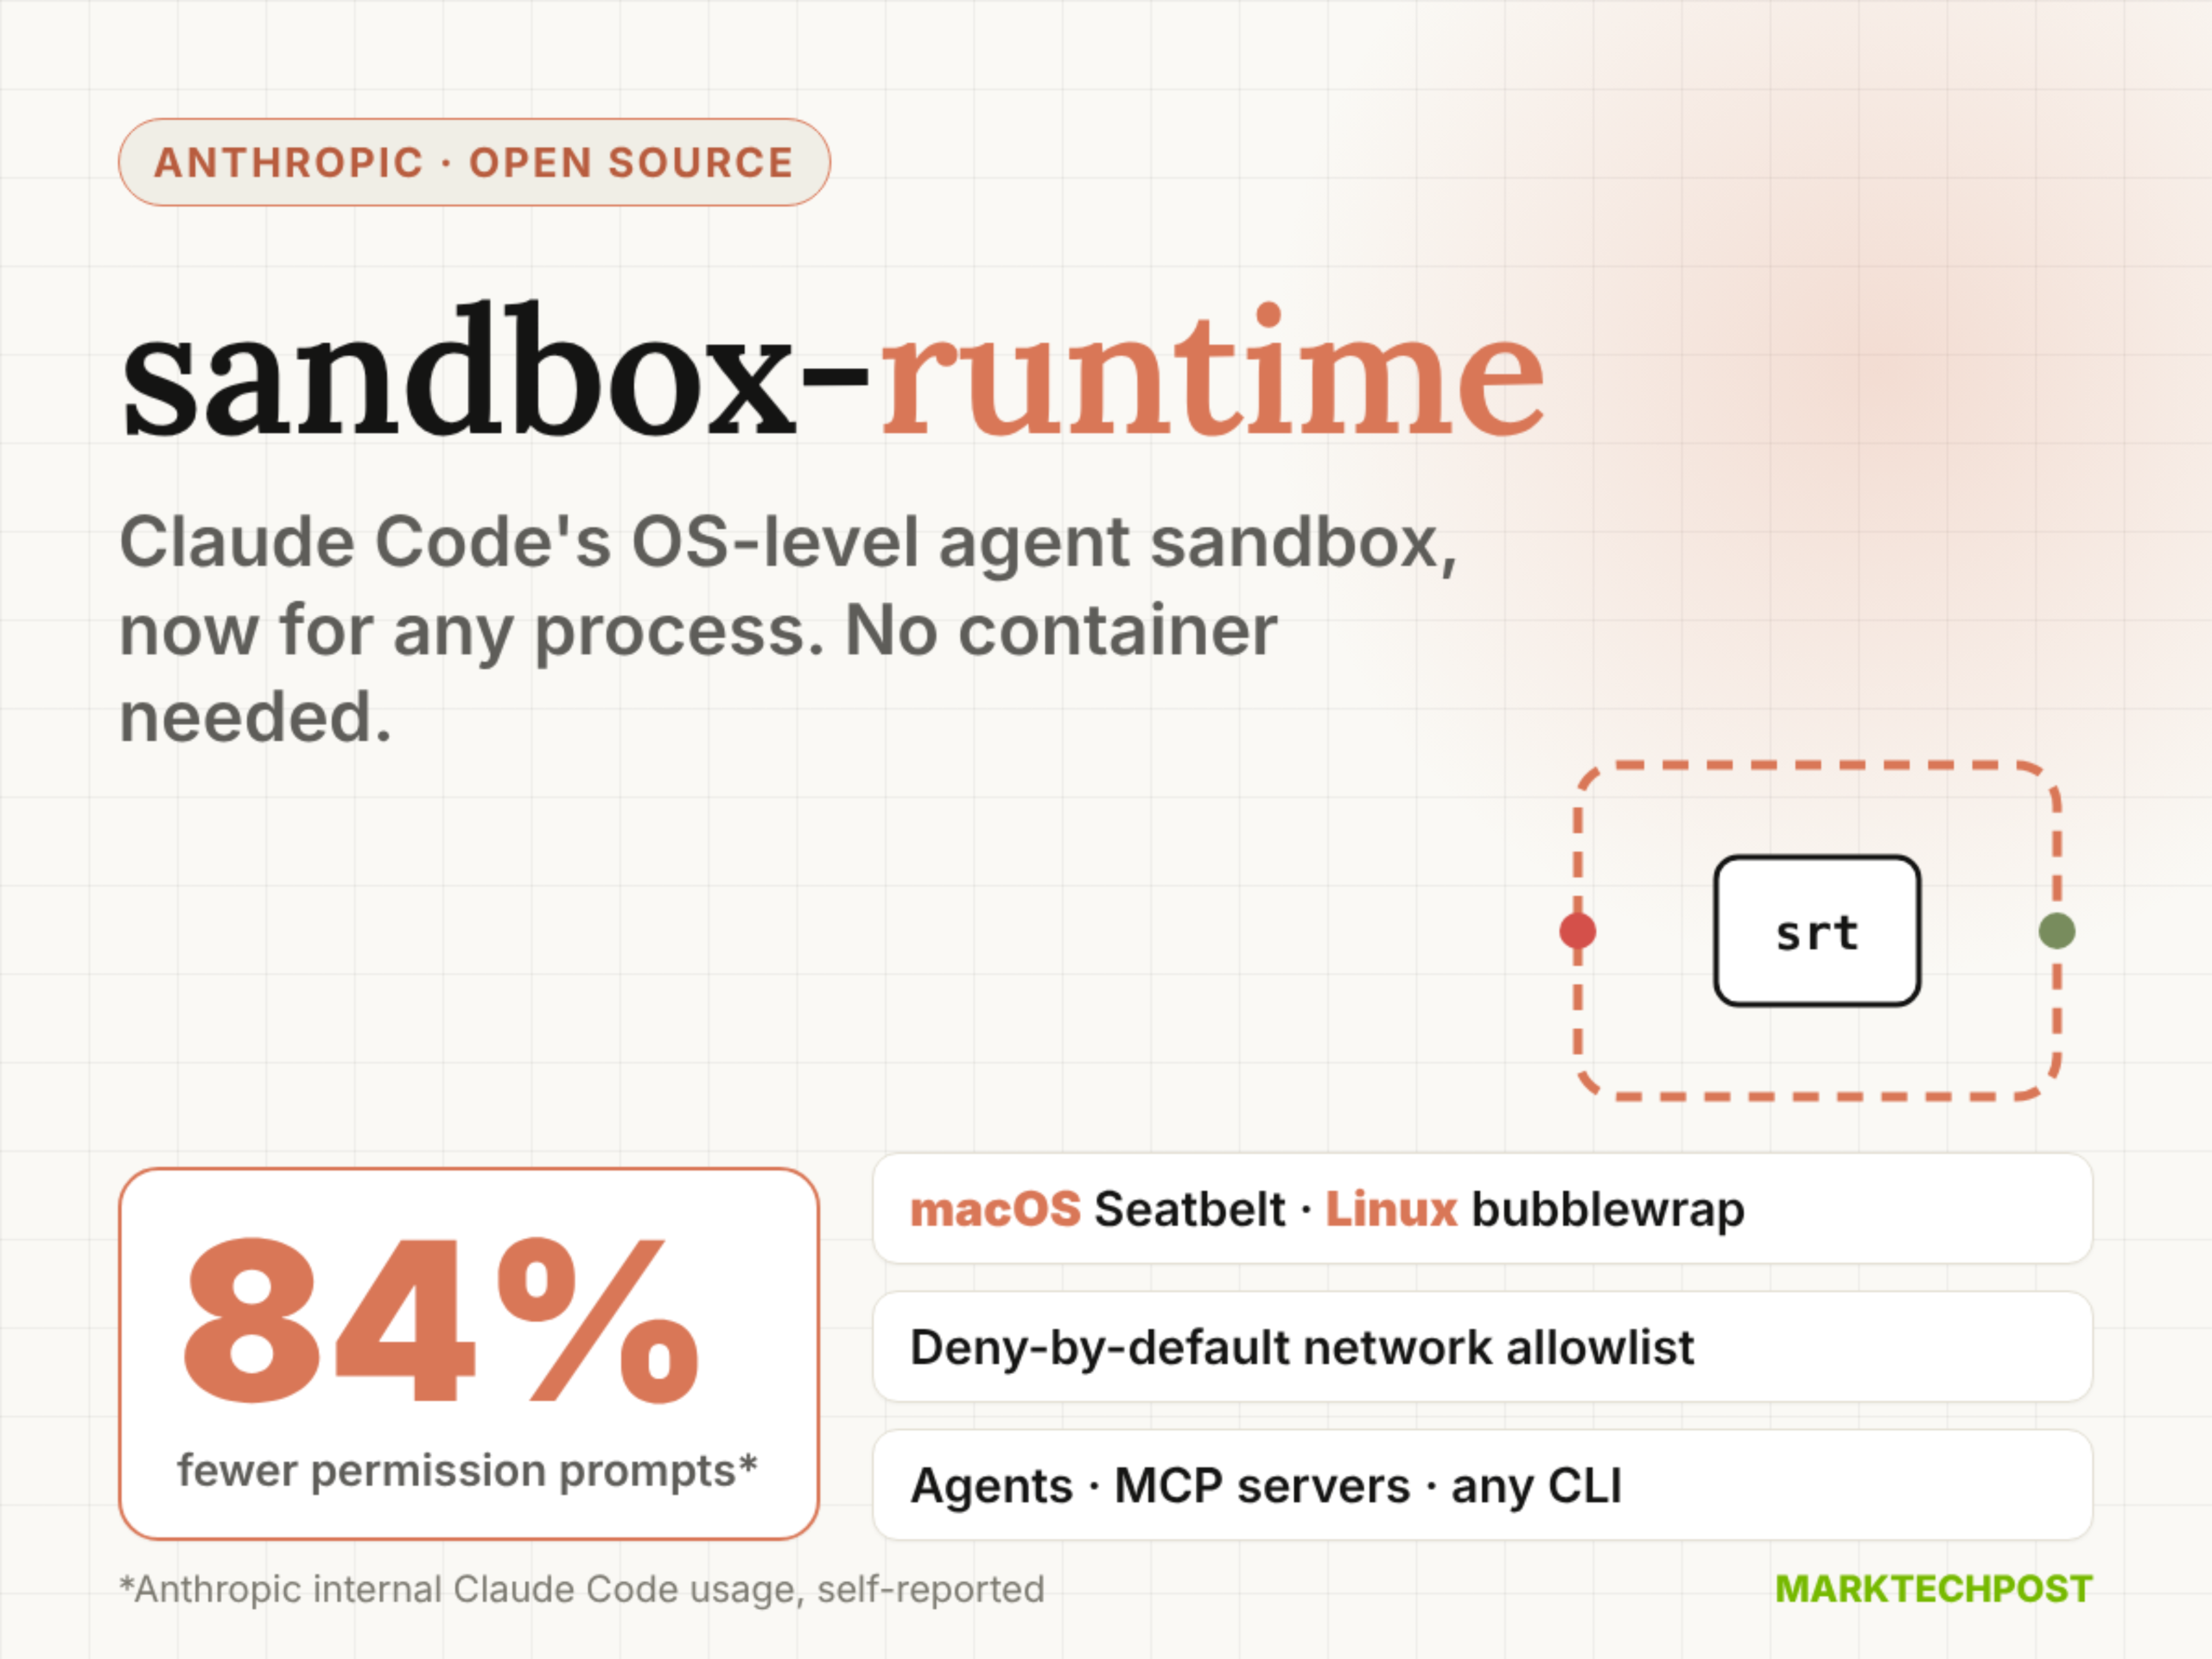
Anthropic开源OS级沙箱sandbox-runtime:为AI代理提供无容器的文件与网络隔离

Anthropic于2026年10月24日开源sandbox-runtime(srt),一款不依赖容器的OS级沙箱工具,用于限制AI代理、MCP服务器及CLI工具的文件读写与网络访问权限;支持macOS(Seatbelt)、Linux(bubblewrap)及Windows(alpha),npm包v0.0.81,Apache-2.0许可。

Meet Anthropic’s sandbox-runtime: OS-Level Sandboxing for AI Agents, No Containers

推荐理由:该工具代表AI安全基础设施的重要演进——通过操作系统原生隔离机制实现细粒度、进程树全覆盖的沙箱控制,直面提示注入与权限泛滥风险,且已投入Claude Code内部使用验证效果。

事件进展与其他报道

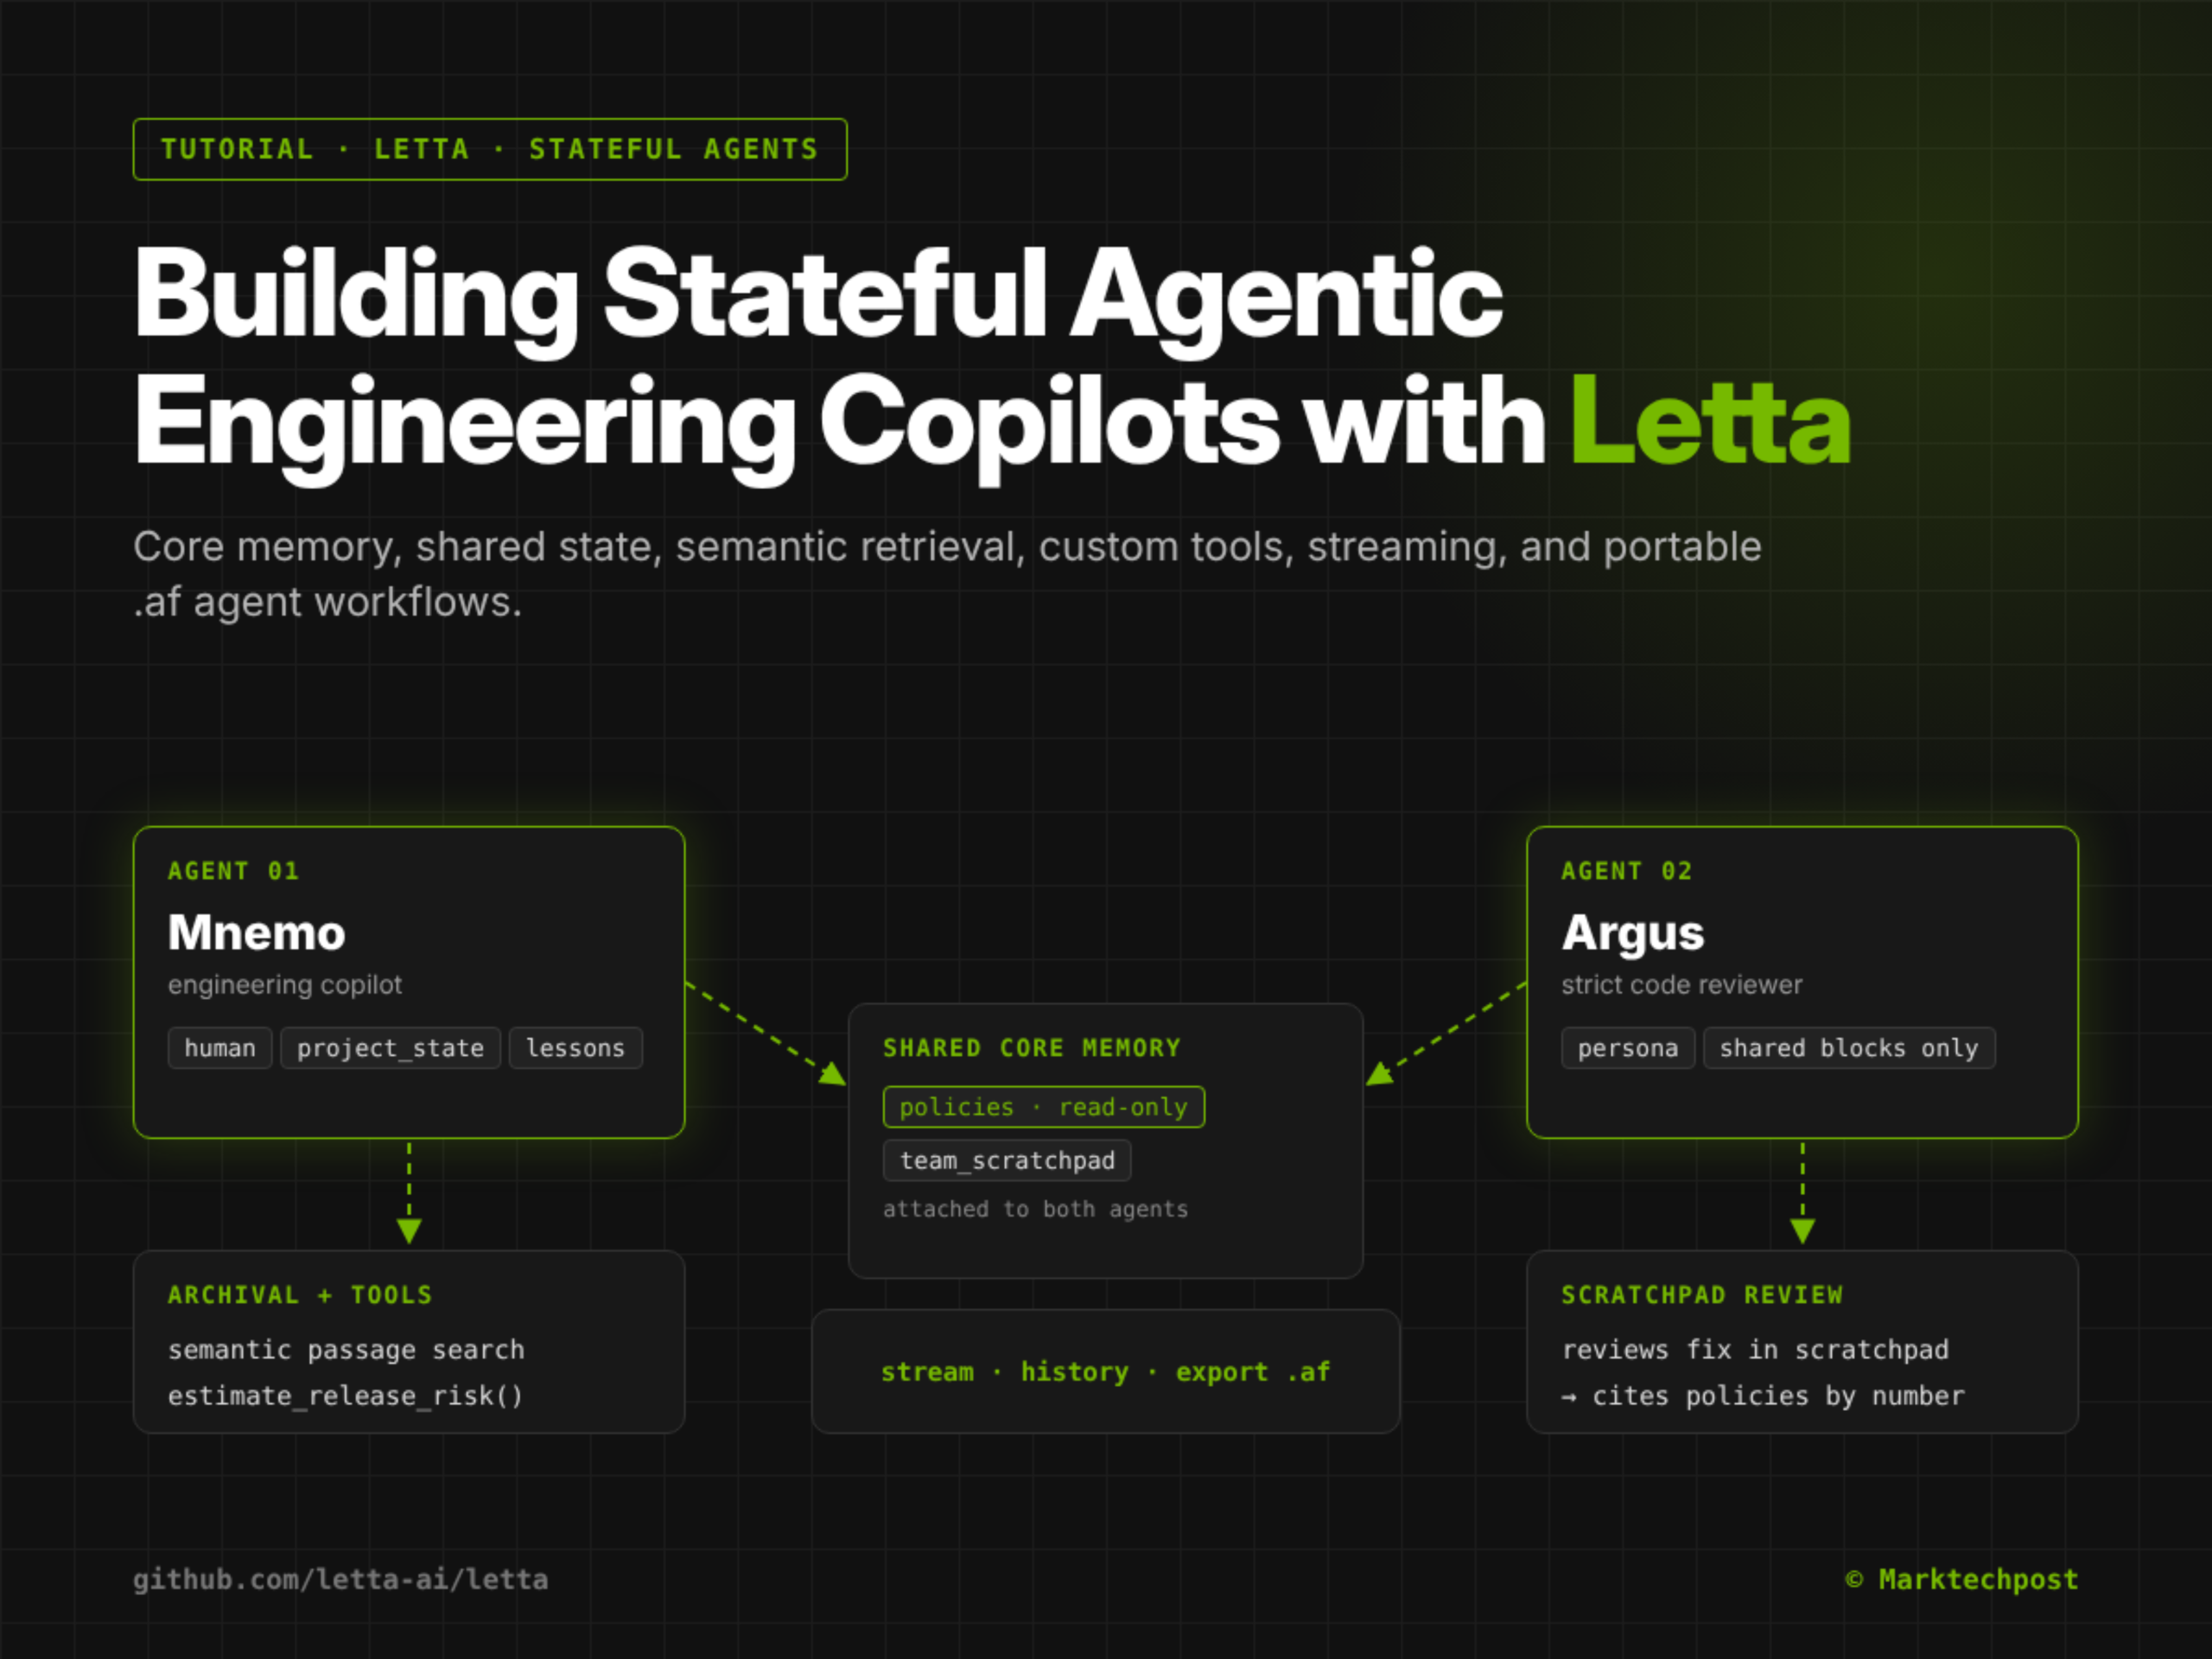
Letta平台发布有状态工程协作者构建教程:支持核心记忆、共享状态与可移植工作流

MarkTechPost于2026年10月24日发布教程,介绍如何基于Letta框架构建具备持久化状态的工程协作者(agentic copilot),涵盖可检查的核心记忆、多代理共享内存、语义检索归档知识、自定义Python工具集成、流式响应及.agent格式(.af)导出等能力;内容为技术实践指南,未提供性能指标、安全审计或生产环境验证。

Stateful Agentic Engineering Copilots with Letta: Core Memory, Shared State, Semantic Retrieval, Custom Tools, Streaming, and Portable Agent Workflows
事件进展与其他报道

月之暗面发布Kimi K3.1 Pro:2.8万亿参数开源权重模型,11月4日开放权重

月之暗面于2026年10月22日前后发布Kimi K3.1 Pro,一款2.8万亿参数、1040亿激活参数的多模态MoE模型,宣称性能逼近Fable 5.1;官方承诺11月4日发布开源权重,但截至报道时权重尚未公开;独立评测显示其在智能指数、代码与网络安全基准中表现突出,但存在推理成本、本地部署可行性及营销透明度等争议。

[AINews] Kimi 3.1 Pro 104BA-2.8T: Fable-5.1-Class Open Weights narrows Closed-AI lead to 1 month... and Pro Highspeed API with 2-3× speed

推荐理由:该事件标志着当前最接近闭源前沿模型能力的开源权重模型正式进入发布倒计时,是AI开源生态关键进展;材料来源为Latent Space旗下AINews(2026年10月24日发布),内容基于对X平台、Reddit、Arena及Artificial Analysis等多方独立评测的整合,信息密度高且具时效性与交叉验证特征。

事件进展与其他报道

ULME框架实现文本嵌入与语言建模的真正统一:arXiv新论文提出预测耦合机制

2026年10月24日,arXiv发布论文arXiv:2610.30705v1,提出ULME——一种面向因果解码器型大语言模型的后训练框架,通过预测耦合(predictive coupling)机制,首次实现文本嵌入与语言生成能力的相互增强式统一。该方法在Qwen2.5/Qwen3系列(0.5B–8B参数)上验证有效,MTEB提升3.3–4.1分,同时保持生成任务(MMLU等)性能不降。

ULME: Predictive Coupling for Mutually Reinforcing Embedding and Language Modeling

推荐理由:该论文直指当前多模态LLM能力割裂的核心问题:嵌入与生成长期由独立模型或仅参数共享的‘伪统一’模型承担。ULME通过可学习插槽与三目标联合训练(含stop-gradient预测损失),使生成过程主动塑造嵌入表征,属架构层面的实质性突破;实验覆盖广、基线强、指标全面,且发布于权威预印本平台,时效性与技术严谨性兼备。

事件进展与其他报道

临床医生主导构建可验证安全守则:为心理健康聊天机器人设置可追溯的守卫层

2026年10月24日,arXiv发布论文arXiv:2610.30690v1,提出一种由两名临床医生主导定义、定稿与裁决的四条安全检查规则库,经形式化验证后作为守卫层应用于心理健康场景下的大语言模型(LLM)输出。该守卫层所有判断均可从一条命名规则和十六个事实复现,旨在提升安全性判断的可解释性与可检验性。

From Clinical Judgment to Checkable Rules: Clinician-Led Guardrails for Mental-Health Chatbots

推荐理由:该研究提供了一种区别于主流prompt工程、LLM-as-a-Judge或Constitutional AI的安全增强路径,其核心创新在于将临床决策结构化、形式化并全程留痕;所有关键主张(如规则数量、验证方式、事实基数、对比实验数据及成本测量)均来自原文明确陈述,且发布时间(2026-10-24)与当前UTC日期(2026-10-25)一致,具备时效性与可信基础。

事件进展与其他报道

TauIndianBankBench发布:面向印度零售银行业的程序感知型对话代理评估基准

2026年10月24日,研究者在arXiv(编号2610.30161v1)发布TauIndianBankBench——一个包含1000个任务的行动导向型基准,专用于评估语言模型驱动的银行对话代理是否严格遵循操作规程(如销户前须获取结清报价),而不仅依赖最终记录判断成败。

TauIndianBankBench: Procedure-Aware, Action-Oriented Evaluation of Tool-Using Conversational Agents

推荐理由:该基准直击当前LLM评估盲区:传统方法仅核查对话终态记录,导致6.5–12.0%存在程序跳步或未授权操作的会话被误判为成功;其程序感知设计填补了印度银行业务自动化中合规性评估的关键缺口。

事件进展与其他报道

新研究提出ReflectPO框架,提升大语言模型代理在长周期任务中的自主纠错能力

2026年10月24日,arXiv发布题为《ReflectPO:面向长周期LLM代理的反思引导策略优化》的研究论文(编号2610.30933v1),提出一种名为ReflectPO的强化学习框架,旨在增强工具增强型大语言模型代理在复杂、多步、状态依赖型任务中的自主错误恢复能力。

ReflectPO: Reflection-Guided Policy Optimization for Long-Horizon LLM Agents

推荐理由:该论文是近期发布的前沿AI研究,聚焦当前LLM智能体落地的关键瓶颈——长周期任务中早期错误的累积效应;其提出的Reflection-Guided Sampling与Tree-Structured Credit Assignment双组件设计具有方法论创新性,并在两个工具使用基准上实证优于多个基线,具备技术参考价值。

事件进展与其他报道

WikiOriginQA发布:基于维基百科多语种版本创建时间自动构建的文化偏见评估问答数据集

研究团队于2026年10月24日在arXiv发布论文(编号2610.30677v1),介绍全自动构建的问答数据集WikiOriginQA,利用各语言维基百科版本的创建日期客观表征知识起源,旨在提升文化偏见评估的可扩展性。

WikiOriginQA: Automated Construction of a QA Dataset with Knowledge Origins for Analyzing Cultural Bias

推荐理由:该研究提出一种无需人工标注、可跨语言规模化生成文化知识溯源数据的方法,并通过实验证实大语言模型在 Anglophone 文化相关问题上存在系统性性能优势,为文化偏见量化分析提供了新工具。

事件进展与其他报道

Lighthouse:首个面向美国民权运动史的可信数字助手发布

论文arXiv:2610.30158v1于2026年10月24日发布,介绍名为Lighthouse的首个专用于探索美国民权运动时期历史(基于南卡罗来纳州档案数据)的数字助手。其核心创新在于以可信内容与用户伤害减缓为设计原则,采用神经符号混合架构,融合大语言模型与规则化符号求解。

Lighthouse: On Building a Trustworthy Digital Assistant for Exploring History with Civil Rights Archives

推荐理由:该研究首次将AI辅助历史探索聚焦于民权运动这一敏感而关键的历史阶段,并明确提出‘可信性’与‘伤害建模’双重约束,区别于通用聊天机器人;其方法论(神经符号结合)、评估方式(含专家共识构建的主观题金标准)及数据规模(超1.8万份原始档案)均具学术示范价值。

事件进展与其他报道

SIM-UT:面向医疗分诊聊天机器人的用户行为模拟评估框架

研究者提出SIM-UT(Simulation of User Behaviour for Triage),一种多轮次、基于真实用户行为模拟的评估方法,用于识别大语言模型(LLM)驱动的医疗分诊聊天机器人在低收入和中等收入国家(LMICs)实际场景中的生态有效失败模式。

SIM-UT: A User Simulation based Evaluation Framework for Medical Triage Chatbots

推荐理由:该框架突破了现有单轮次、英语为主的评测局限,通过5000+轮多语种模拟对话,覆盖印度、南非、肯尼亚三地真实WhatsApp健康项目,首次系统揭示‘临床危险性降级’(de-escalation risk)这一关键失效行为,具有方法论创新性与临床安全警示价值。

事件进展与其他报道