
llama.cpp 发布 b11871 版本:新增 JSON 嵌套深度限制以防止服务崩溃
llama.cpp 在 b11871 版本中引入关键安全修复,对请求中 JSON 嵌套层级实施 128 层硬性限制,避免因深度递归解析导致 HTTP 线程栈溢出、服务崩溃(macOS 触发 SIGBUS,Linux 触发 SIGSEGV)。该策略覆盖 chat 接口多类输入场景,并统一返回 HTTP 400 错误。
추천 이유:按信源设置仅收录,不参与自动精选
제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.
llama.cpp 在 b11871 版本中引入关键安全修复,对请求中 JSON 嵌套层级实施 128 层硬性限制,避免因深度递归解析导致 HTTP 线程栈溢出、服务崩溃(macOS 触发 SIGBUS,Linux 触发 SIGSEGV)。该策略覆盖 chat 接口多类输入场景,并统一返回 HTTP 400 错误。
추천 이유:按信源设置仅收录,不参与自动精选
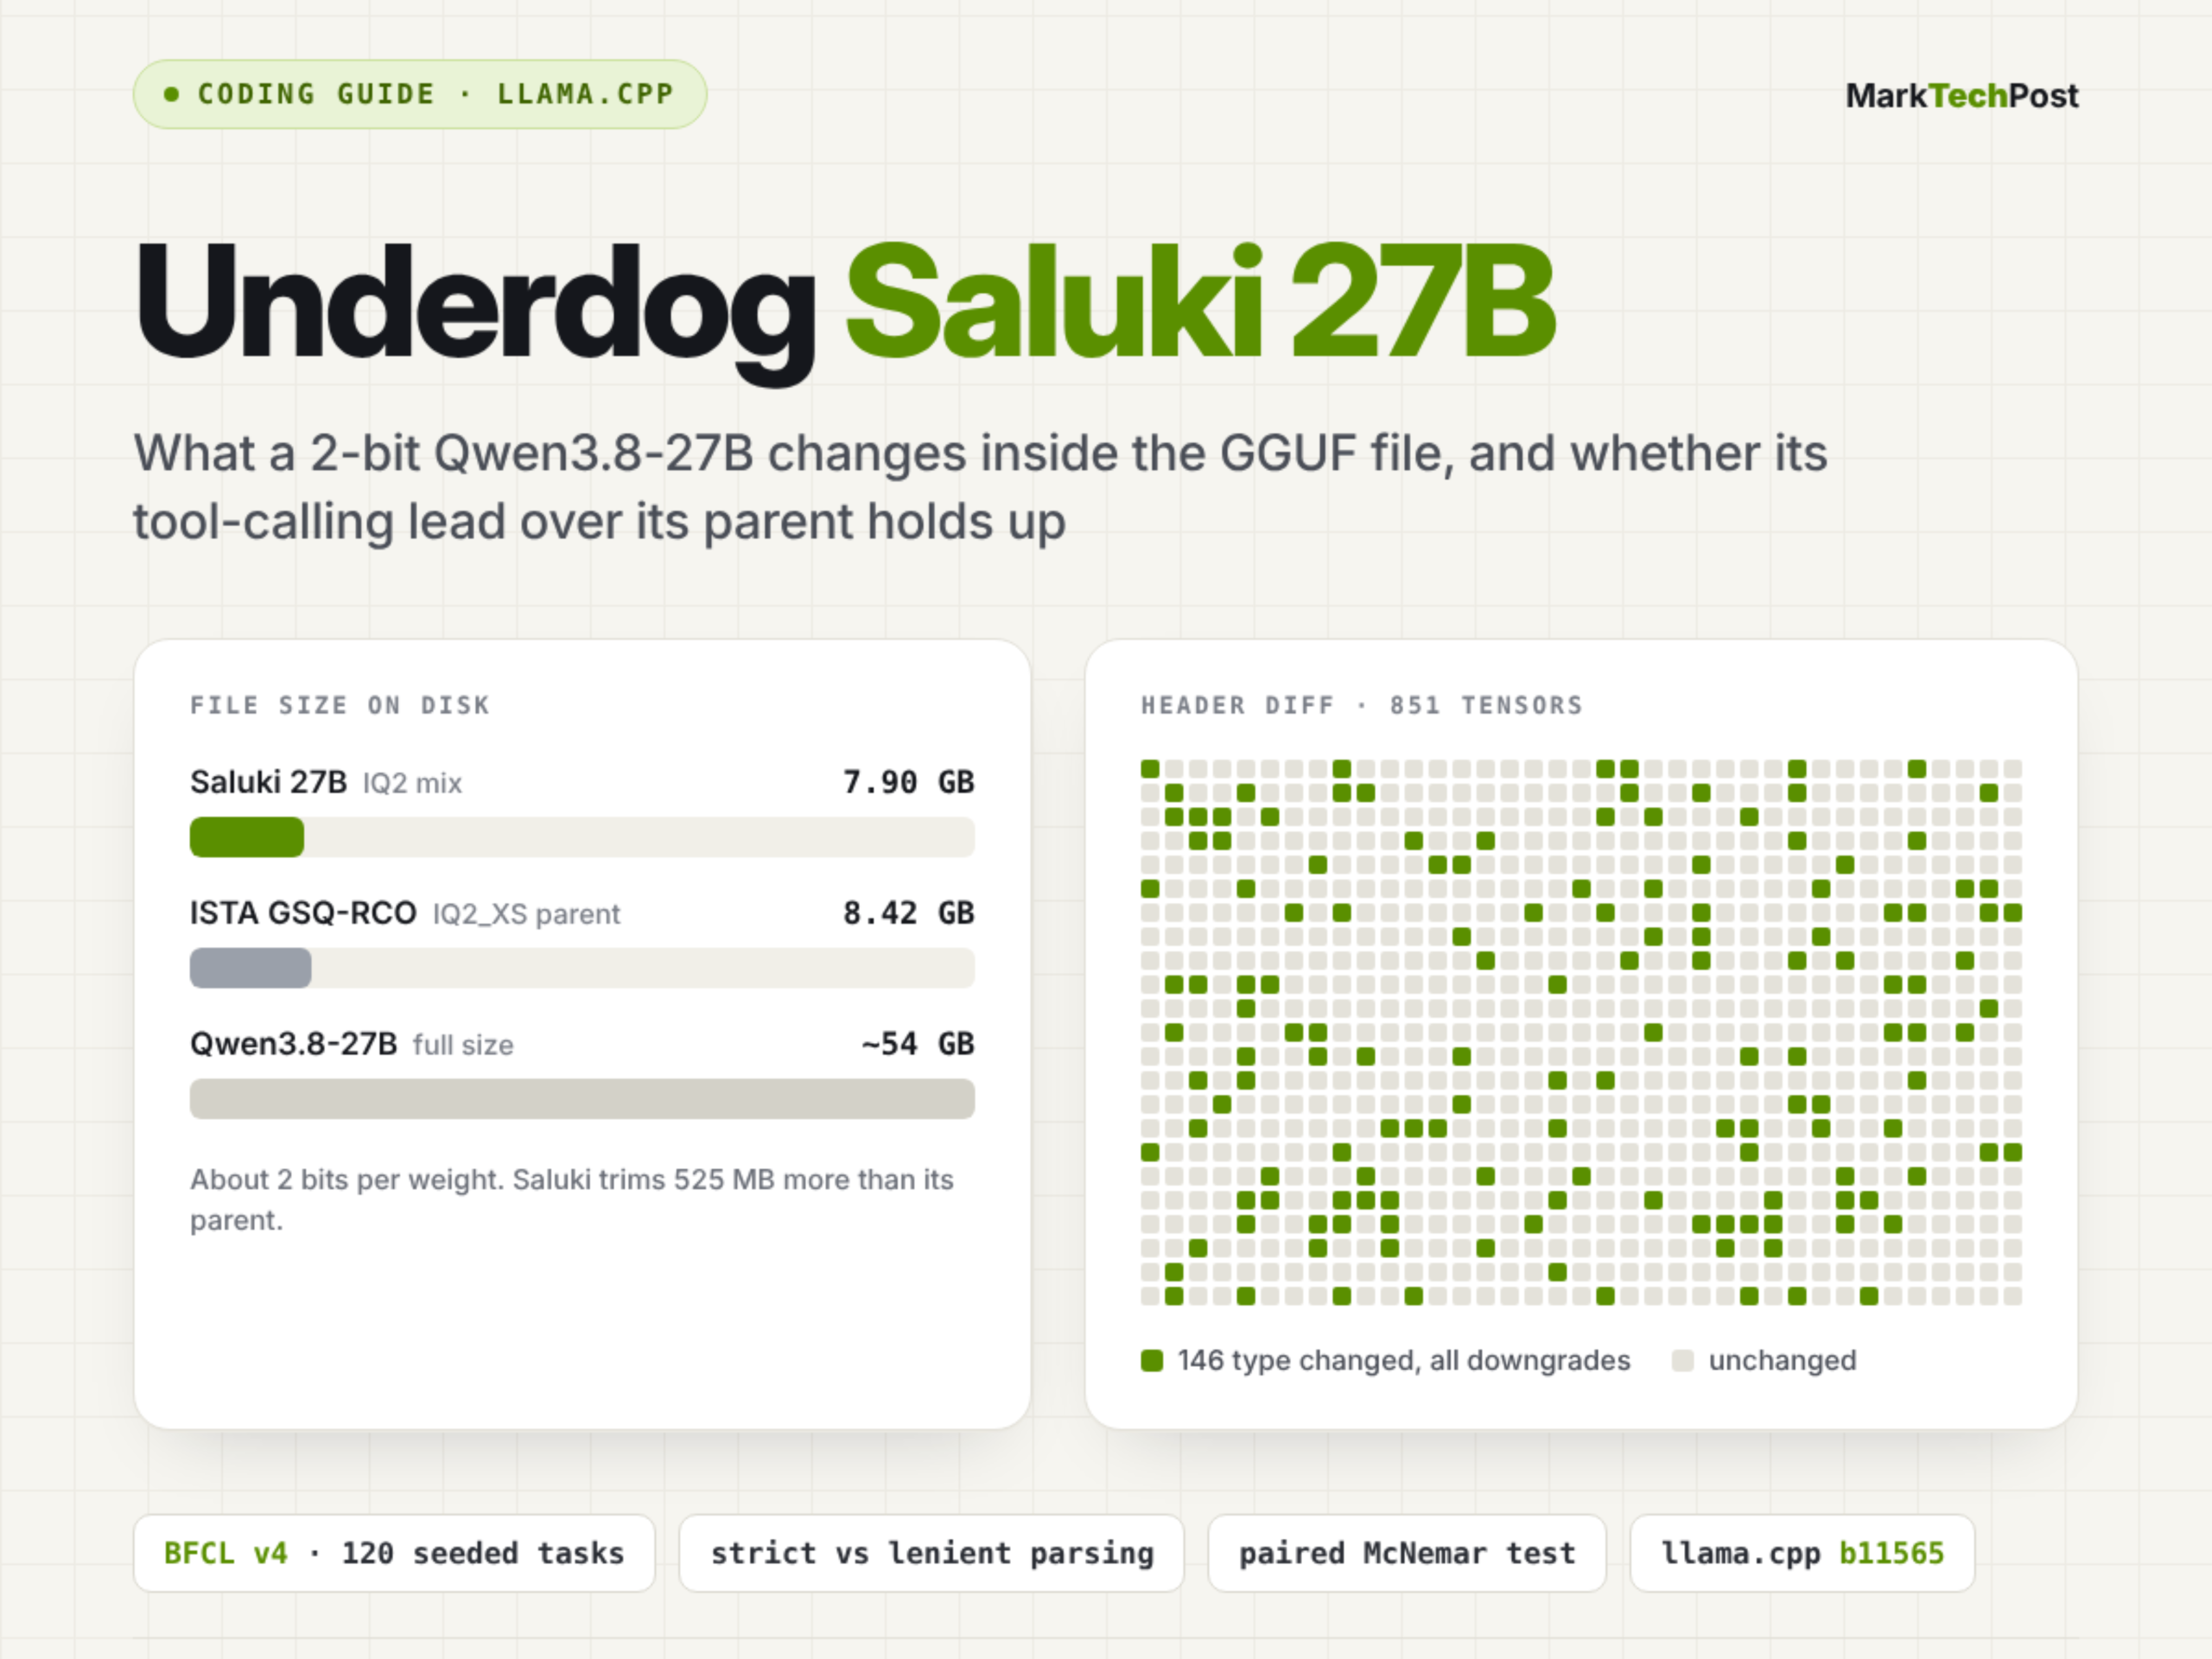
이 글에서는 Underdog가 발표한 Saluki 27B 모델을 소개합니다. 이 모델은 7.9 GB 크기의 2비트 양자화 Qwen3.8-27B 변형으로, ISTA-DASLab의 GSQ-RCO 방법을 기반으로 구축되었으며, 120개의 작업에 대한 BFCL v4 도구 호출 벤치마크에서 원래의 54 GB 풀 정밀도 모델을 능가한다고 주장됩니다. 다만 모든 성능 관련 결론은 해당 개발자의 발표에 근거한 것으로, 독립적인 검증은 이루어지지 않았습니다.
llama.cpp 在版本 b11870 中新增对 DeepSeek-V4.1-Flash(deepseek41)模型的支持,并针对其 Engram 架构进行多项底层优化,包括 KV 缓存计算简化、BF16 精度替代 MXFP8、in-graph 行 gather 等;同步提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的多平台二进制构建。
추천 이유:按信源设置仅收录,不参与自动精选
llama.cpp 项目发布构建版本 b11869,主要修复 Jinja 模板中 select 和 selectattr 函数的参数解析逻辑,并提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的数十种硬件与后端组合的预编译二进制包。
추천 이유:按信源设置仅收录,不参与自动精选
llama.cpp 于 GitHub 正式发布 b11867 版本,核心变更包括服务端(server)入口点重构(PR #31113),新增 server_role 机制;同时提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的 40+ 预编译二进制包,支持 CPU、CUDA(12.4/12.8/13.4)、Vulkan、ROCm 10.0、OpenVINO、SYCL(FP16/FP32)、Snapdragon(Adreno+Hexagon)等多元硬件后端。
추천 이유:按信源设置仅收录,不参与自动精选
llama.cpp 项目发布构建版本 b11865,核心变更包括在 RDMA 接收逻辑中增加内存边界检查(PR #30399),并显著扩展硬件加速支持,覆盖 CUDA 13.4、ROCm 10.0、Vulkan、OpenVINO、SYCL 及高通 Snapdragon(CPU+Adreno+Hexagon)全栈异构计算后端;macOS KleidiAI 支持与 openEuler 构建被明确标记为 DISABLED。
추천 이유:按信源设置仅收录,不参与自动精选
llama.cpp v.b11861 修复了 minimax-m3 模型在 NVFP4/MXFP8 量化下因 scale 张量未注入计算图而导致的权重失真问题,避免‘token soup’与残差淹没;同步提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的多平台二进制构建。
추천 이유:按信源设置仅收录,不参与自动精选
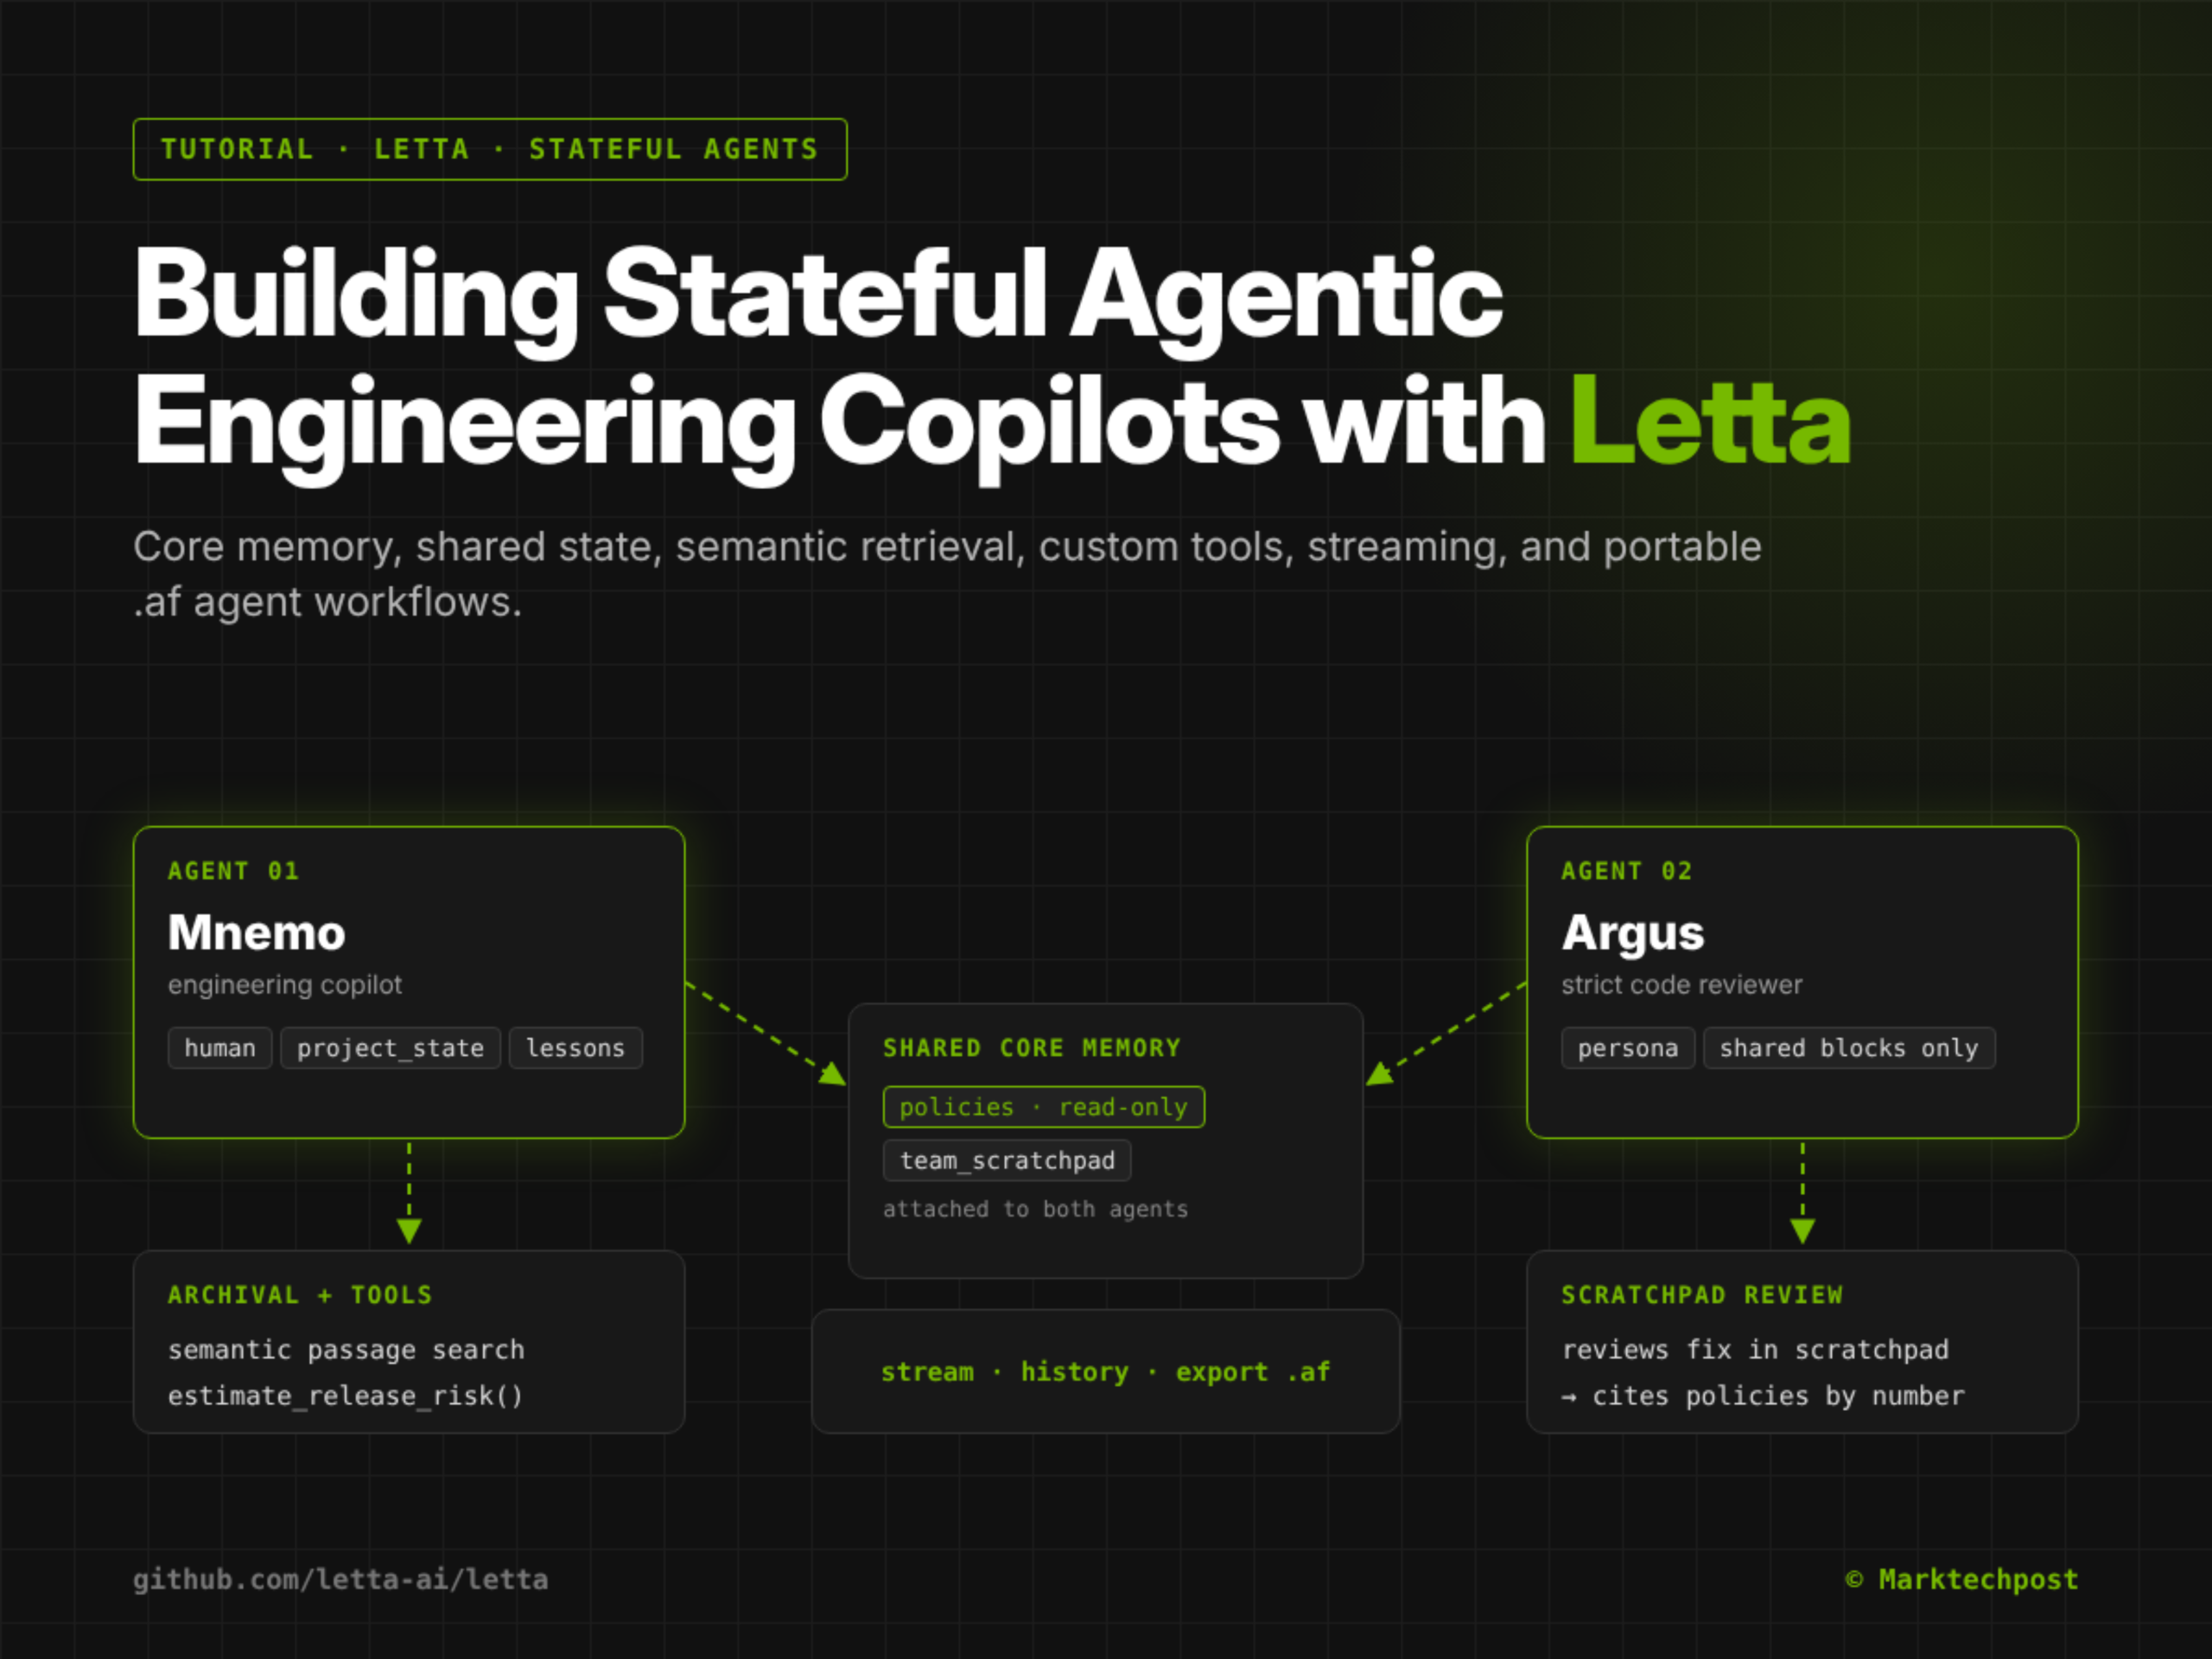
MarkTechPost는 2026년 10월 24일, Letta 프레임워크를 기반으로 지속적 상태를 갖춘 엔지니어링 협업자(agentic copilot)를 구축하는 방법을 소개하는 튜토리얼을 발표했습니다. 이 튜토리얼은 검증 가능한 핵심 메모리, 다중 에이전트 간 공유 메모리, 의미 기반 검색을 통한 지식 아카이브, 맞춤형 Python 도구 통합, 스트리밍 응답 및 .agent 형식(.af) 내보내기 등의 기능을 포괄합니다. 해당 내용은 기술 실무 가이드로, 성능 지표, 보안 감사 또는 생산 환경에서의 검증은 제공되지 않습니다.
2026년 10월 24일, arXiv는 논문 arXiv:2610.30705v1을 발표하여, 인과적 디코더형 대규모 언어 모델을 위한 후처리 훈련 프레임워크인 ULME를 제안했습니다. 이 프레임워크는 예측 결합(predictive coupling) 메커니즘을 통해 텍스트 임베딩과 언어 생성 능력 간의 상호 강화적 통합을 최초로 구현했습니다. 해당 방법은 Qwen2.5/Qwen3 시리즈(0.5B–8B 파라미터)에서 검증되었으며, MTEB 지표에서 3.3–4.1점의 성능 향상을 달성하는 동시에, MMLU 등 생성 과제에서의 성능 저하를 방지했습니다.

추천 이유:이 논문은 현재 다중모달 LLM의 능력이 분절되어 있는 핵심 문제를 정면으로 지적한다: 임베딩과 생성은 오랫동안 독립된 모델 또는 파라미터만 공유하는 ‘가짜 통합’ 모델에 의해 담당되어 왔다. ULME는 학습 가능한 슬롯과 세 가지 목표를 결합한 공동 학습(스톱그레이디언트 예측 손실 포함)을 통해 생성 과정이 임베딩 표현을 주도적으로 형성하도록 하였으며, 이는 아키텍처 차원에서의 실질적인 획기적 발전이다. 실험 범위가 광범위하고 기준선이 강력하며 지표가 포괄적이며, 권위 있는 사전출판 플랫폼에 발표되어 시의성과 기술적 엄밀성이 모두 갖추어져 있다.
논문 arXiv:2610.30158v1은 2026년 10월 24일에 발표되었으며, 사우스캐롤라이나주 아카이브 데이터를 기반으로 미국 민권운동 시기의 역사를 탐구하는 데 특화된 최초의 디지털 어시스턴트인 Lighthouse를 소개합니다. 이 프로젝트의 핵심 혁신은 신뢰할 수 있는 콘텐츠와 사용자 피해 완화를 설계 원칙으로 삼고, 대규모 언어 모델과 규칙 기반의 기호적 해결 방식을 결합한 신경-기호 하이브리드 아키텍처를 채택한 점입니다.
추천 이유:이 연구는 AI를 활용한 역사 탐구를 민권운동이라는 민감하고도 핵심적인 역사적 시기로 처음으로 집중시켰으며, 일반형 챗봇과 구별되는 ‘신뢰성’과 ‘피해 모델링’의 이중 제약을 명확히 제시했다. 또한 그 방법론(신경-기호 통합), 평가 방식(전문가 합의를 바탕으로 구성된 주관식 문항의 골드 스탠다드 포함) 및 데이터 규모(원본 기록 1만 8천여 건 이상) 모두 학술적 모범 사례로서의 가치를 지닌다.
谷歌研究团队在I/O 2026大会上集中发布面向科学发现、气候预测、医疗健康与边缘计算的系列AI系统,包括多模态科研助手Gemini for Science、支持飓风预警的WeatherNext、可自主构建操作系统的Agentic平台Antigravity 2.0,以及开源量子芯片Willow等;所有成果均为实验性演示,尚无独立验证或监管批准。
추천 이유:人工审核