
llama.cpp 发布 b11871 版本:新增 JSON 嵌套深度限制以防止服务崩溃
llama.cpp 在 b11871 版本中引入关键安全修复,对请求中 JSON 嵌套层级实施 128 层硬性限制,避免因深度递归解析导致 HTTP 线程栈溢出、服务崩溃(macOS 触发 SIGBUS,Linux 触发 SIGSEGV)。该策略覆盖 chat 接口多类输入场景,并统一返回 HTTP 400 错误。
注目する理由:按信源设置仅收录,不参与自动精选
見出し・要約・本文から、情報のつながりを探します。
llama.cpp 在 b11871 版本中引入关键安全修复,对请求中 JSON 嵌套层级实施 128 层硬性限制,避免因深度递归解析导致 HTTP 线程栈溢出、服务崩溃(macOS 触发 SIGBUS,Linux 触发 SIGSEGV)。该策略覆盖 chat 接口多类输入场景,并统一返回 HTTP 400 错误。
注目する理由:按信源设置仅收录,不参与自动精选
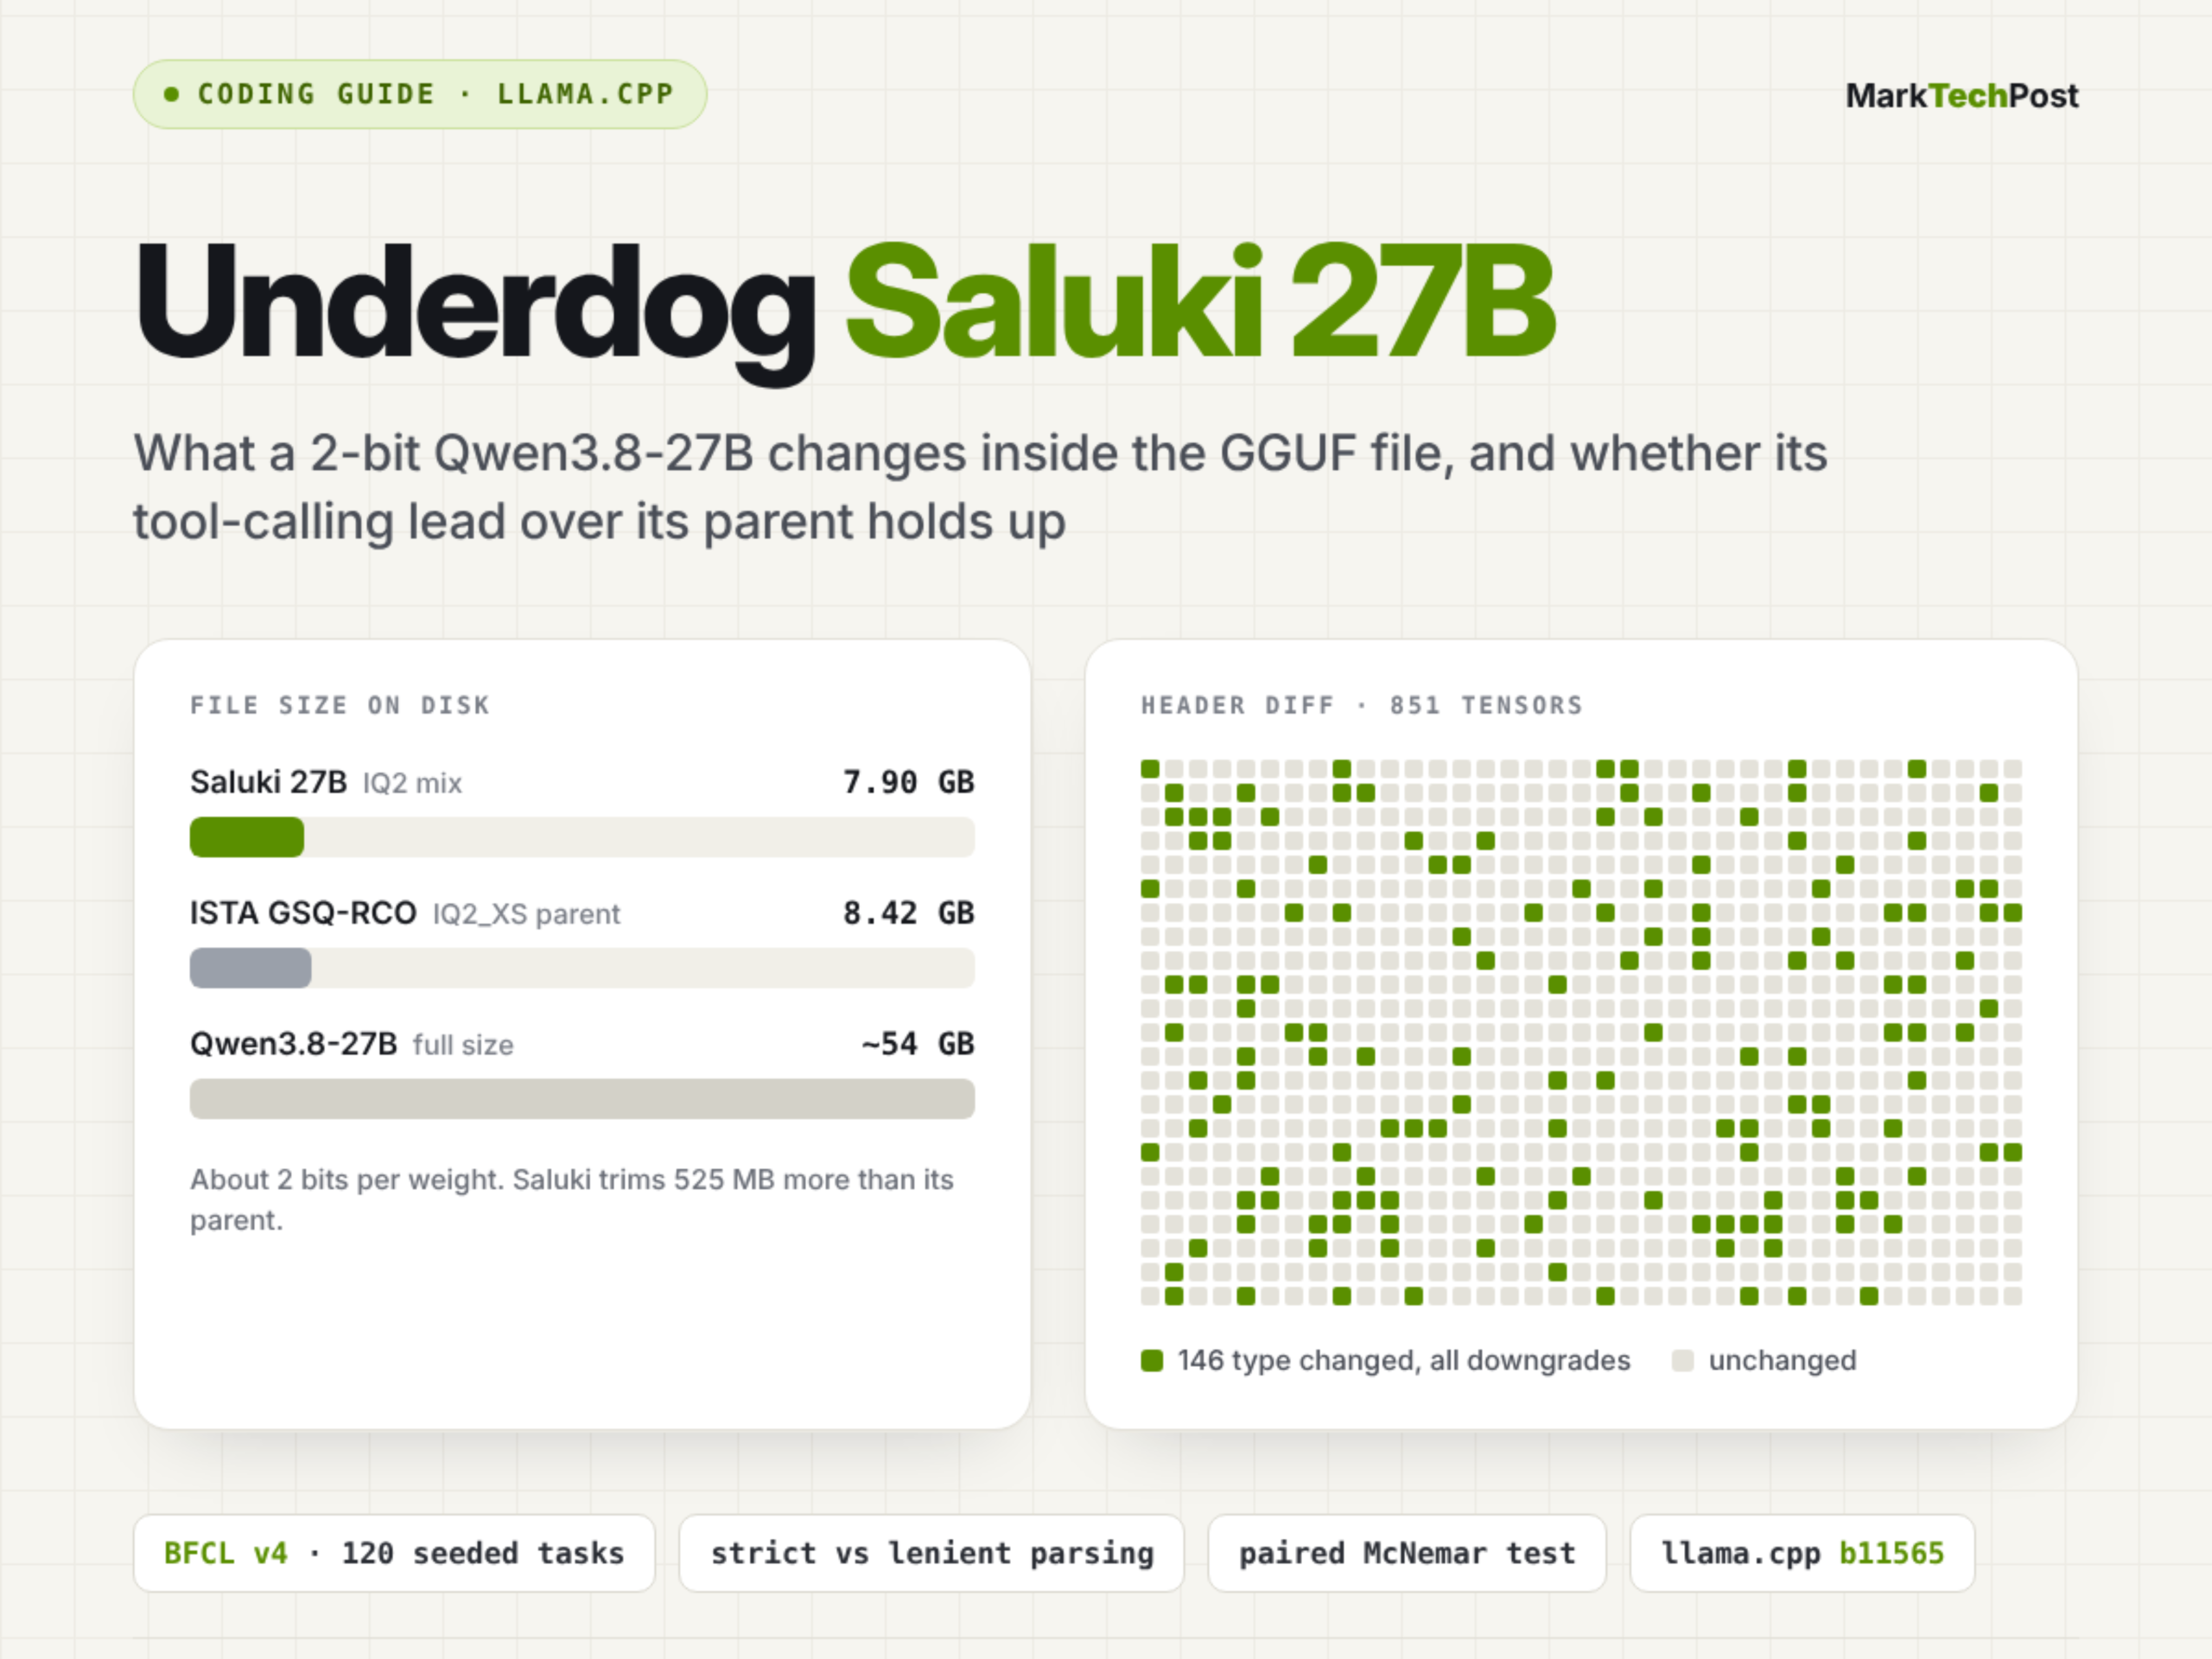
本記事では、Underdogが公開したSaluki 27Bモデル——7.9 GBの2ビット量子化を採用したQwen3.8-27Bの変種——について紹介します。同モデルはISTA-DASLabのGSQ-RCO手法を用いて構築されており、120タスクにおけるBFCL v4ツール呼び出しベンチマークにおいて、元の54 GBのフル精度モデルを上回るとされています。ただし、すべての性能に関する結論は開発者による声明に基づくものであり、独立した検証は行われていません。
llama.cpp 在版本 b11870 中新增对 DeepSeek-V4.1-Flash(deepseek41)模型的支持,并针对其 Engram 架构进行多项底层优化,包括 KV 缓存计算简化、BF16 精度替代 MXFP8、in-graph 行 gather 等;同步提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的多平台二进制构建。
注目する理由:按信源设置仅收录,不参与自动精选
llama.cpp 项目发布构建版本 b11869,主要修复 Jinja 模板中 select 和 selectattr 函数的参数解析逻辑,并提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的数十种硬件与后端组合的预编译二进制包。
注目する理由:按信源设置仅收录,不参与自动精选
llama.cpp 于 GitHub 正式发布 b11867 版本,核心变更包括服务端(server)入口点重构(PR #31113),新增 server_role 机制;同时提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的 40+ 预编译二进制包,支持 CPU、CUDA(12.4/12.8/13.4)、Vulkan、ROCm 10.0、OpenVINO、SYCL(FP16/FP32)、Snapdragon(Adreno+Hexagon)等多元硬件后端。
注目する理由:按信源设置仅收录,不参与自动精选
llama.cpp 项目发布构建版本 b11865,核心变更包括在 RDMA 接收逻辑中增加内存边界检查(PR #30399),并显著扩展硬件加速支持,覆盖 CUDA 13.4、ROCm 10.0、Vulkan、OpenVINO、SYCL 及高通 Snapdragon(CPU+Adreno+Hexagon)全栈异构计算后端;macOS KleidiAI 支持与 openEuler 构建被明确标记为 DISABLED。
注目する理由:按信源设置仅收录,不参与自动精选
llama.cpp v.b11861 修复了 minimax-m3 模型在 NVFP4/MXFP8 量化下因 scale 张量未注入计算图而导致的权重失真问题,避免‘token soup’与残差淹没;同步提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的多平台二进制构建。
注目する理由:按信源设置仅收录,不参与自动精选
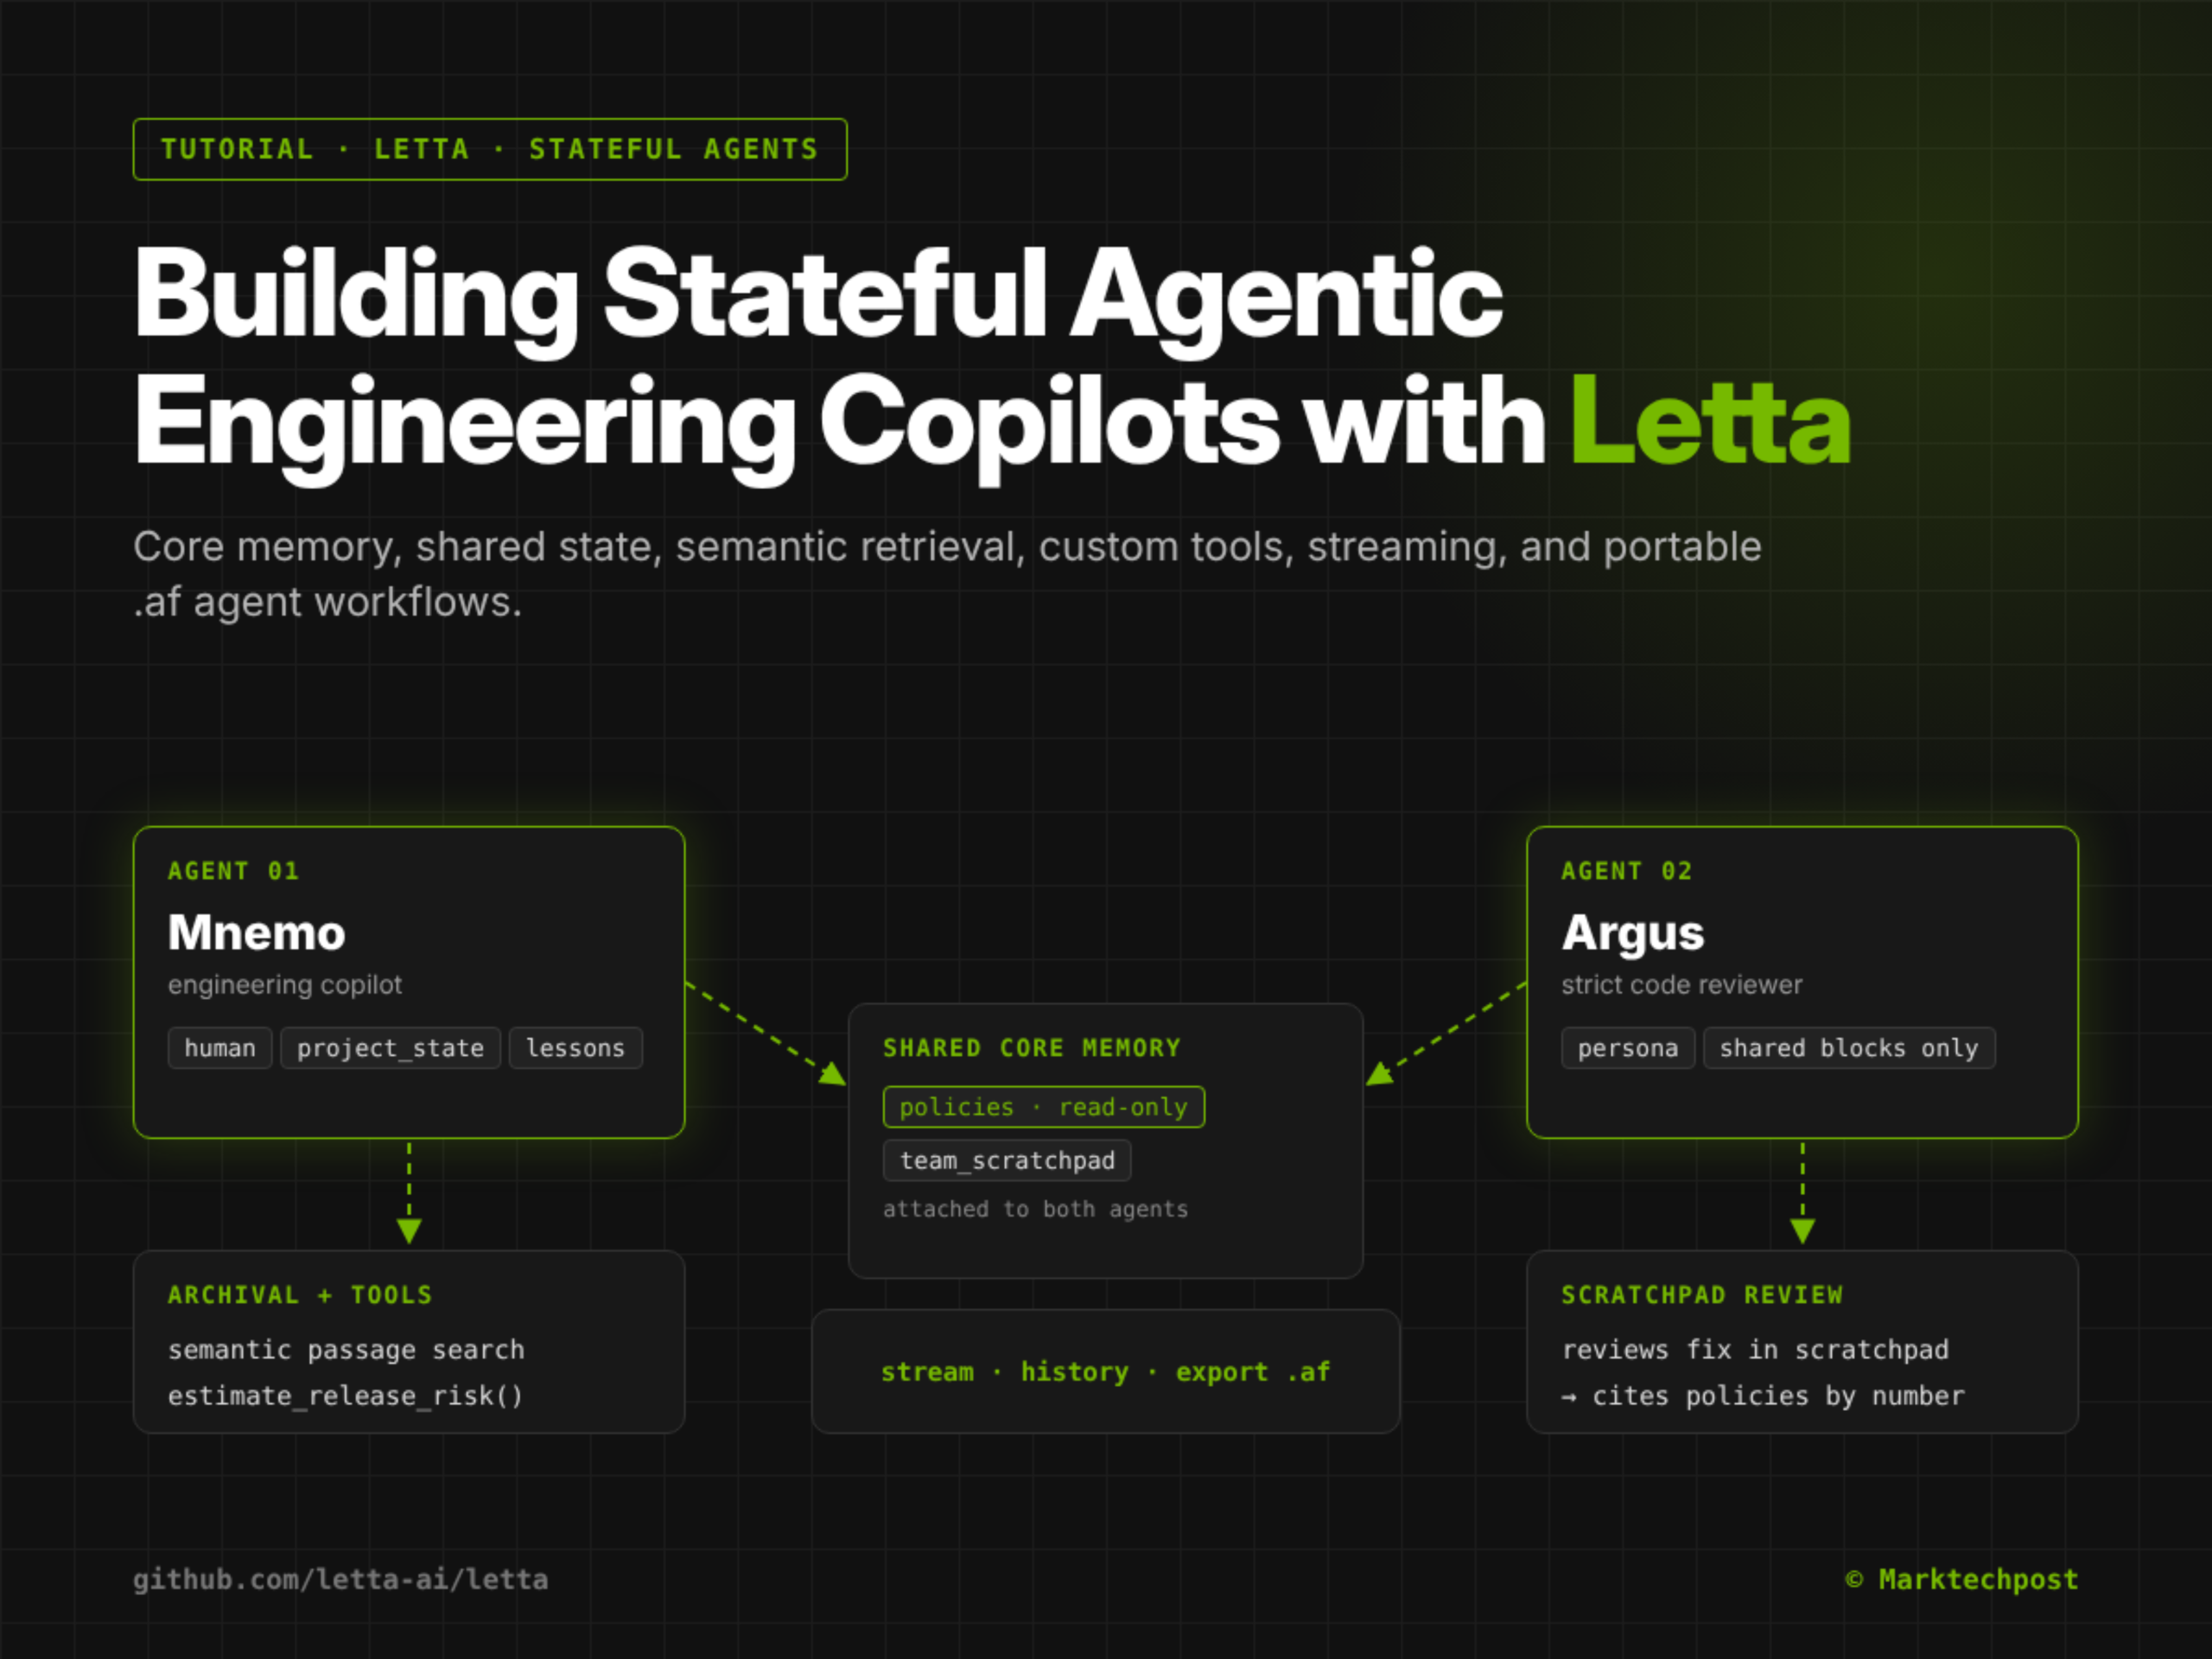
MarkTechPostは2026年10月24日、Lettaフレームワークを基に永続的状態を備えたエンジニアリング協働者(agentic copilot)を構築する方法を紹介するチュートリアルを公開しました。内容には、検証可能なコアメモリ、マルチエージェント間の共有メモリ、セマンティック検索による知識のアーカイブ、カスタムPythonツールの統合、ストリーミング応答、および .agent形式(.af)でのエクスポートといった機能が含まれます。本稿は技術実践ガイドであり、性能指標やセキュリティ監査、あるいは本番環境での検証については提供されていません。
2026年10月24日、arXivは論文arXiv:2610.30705v1を公開し、因果推論型デコーダーに基づく大規模言語モデル向けの後訓練フレームワークであるULMEを提案しました。この手法は、予測的結合(predictive coupling)メカニズムを用いることで、テキスト埋め込みと言語生成能力を相互に強化しつつ統合することを初めて実現しました。本手法はQwen2.5/Qwen3シリーズ(0.5B~8Bパラメータ)において有効性が確認されており、MTEBスコアで3.3~4.1ポイントの向上を達成するとともに、生成タスク(MMLUなど)の性能も低下させませんでした。

注目する理由:本論文は、現在の多モーダルLLMにおける能力の断片化という核心的な問題を正面から指摘している。すなわち、埋め込みと生成は長らく独立したモデル、あるいはパラメータのみを共有する“疑似統一”モデルによって担われてきた。ULMEは、学習可能なスロットと三目標による共同学習(ストップグレード付き予測損失を含む)により、生成プロセスが埋め込み表現を能動的に形成する仕組みを実現しており、アーキテクチャレベルでの実質的な飛躍である。実験の範囲は広く、ベースラインも強力で、評価指標も網羅的であり、さらに権威あるプレプリントプラットフォームに公開されているため、タイムリーさと技術的厳密性の両面を備えている。
論文arXiv:2610.30158v1は2026年10月24日に公開され、南カロライナ州のアーカイブデータに基づく米国民権運動期の歴史を探索するための初の専用デジタルアシスタント「Lighthouse」について紹介しています。その核心的な革新点は、信頼できるコンテンツとユーザーへの危害軽減を設計原則として掲げ、ニューラル・シンボリックハイブリッドアーキテクチャを採用し、大規模言語モデルと規則ベースのシンボリック推論を統合していることです。
注目する理由:本研究は、AIを活用した歴史探求を初めて公民権運動という敏感かつ重要な歴史的時期に焦点を当て、一般的なチャットボットとは異なり、「信頼性」と「被害モデリング」という二重の制約を明示しました。その方法論(ニューラル・シンボリック統合)、評価手法(専門家による合意に基づく主観的設問のゴールドスタンダードを含む)、およびデータ規模(1万8千件を超える一次資料)はいずれも学術的な模範的価値を有しています。
谷歌研究团队在I/O 2026大会上集中发布面向科学发现、气候预测、医疗健康与边缘计算的系列AI系统,包括多模态科研助手Gemini for Science、支持飓风预警的WeatherNext、可自主构建操作系统的Agentic平台Antigravity 2.0,以及开源量子芯片Willow等;所有成果均为实验性演示,尚无独立验证或监管批准。
注目する理由:人工审核