본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

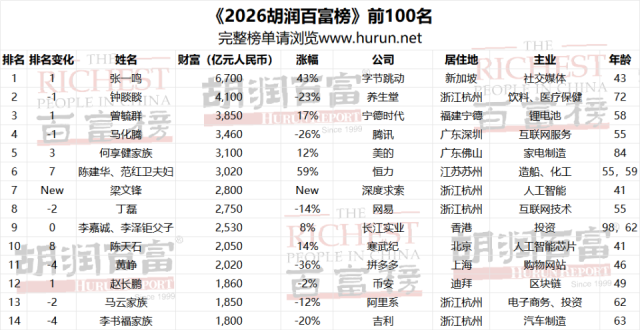
Anthropic가 증권신고서를 제출했으며, 규정을 위반한 사용자가 매출의 최소 5%를 기여한 것으로 나타났다; 후룬 부자 순위 100대 명단에 량원펑 등 AI 분야의 거물들이 대거 이름을 올렸다 | AI 업계에서는 또 어떤 일이 벌어지고 있을까

1. 워커들에게 더 적합한 GPT-6.1 Terra가 출시되며, API 가격은 절반으로 인하되고 컴퓨터 작업 속도는 더욱 빨라집니다. 10월 26일, OpenAI는 GPT-6.1 Terra를 발표했으며, 주요 기능으로 시각적 이해력, 컴퓨터 작업 능력, 사실 정확성 및 프로그래밍 능력을 향상시켰습니다....

Anthropic发招股书,违规用户贡献至少5%收入;胡润富豪榜百强名单,梁文锋等AI大佬纷纷上榜 | AI圈又发生什么了
진행 상황 및 관련 보도

‘높은 점수를 얻는 것’이 곧 ‘완전한 납품 가능성’을 의미하는 것은 아니다: AI 순위표가 신뢰 재평가의 시기를 맞고 있다

구 버전 순위의 점수는 만점에 근접했지만, 신규 버전의 실전 성적은 집단적으로 낙제점을 기록했다. 대형 모델 평가 자체가 하나의 비즈니스로 전환되면서, 기업들의 선택 기준은 이제 순위를 보는 데서 비용 계산으로 옮겨가고 있다.

진행 상황 및 관련 보도

Kimi, K3.1 Pro를 출시하며 용량 증가와 가격 인하로 Opus 5.5에 도전합니다

작성자|우항위안 편집자|징위 10월 23일 오전, Kimi 공식 계정은 X와 비디오 계정을 통해 24초짜리 영상을 게시했다. 화면에는 레트로 스타일의 구형 컴퓨터가 등장하고, 화면에는 Kimi Code가 실행 중이며, 터미널에는 Three.js 코드가 줄줄이 출력되며 복잡한 3D 장면이 생성되고 있었다. 눈썰미가 좋은 네티즌들은 곧 왼쪽 상단의 모델 표시줄에서 답을 찾아냈다—「Model: Kimi K3.1」. Kimi 공식이 공개한 K3.1 사전 홍보 영상|출처: X @Kimi_Moonshot 구식 고물 같은 기계로 오늘날 가장 첨단인 3D 코드를 구동하는 이 반전 자체가 바로 월지암면이 전하려는 메시지였다. 그로부터 십여 시간 후, 10월 24일 자정을 막 넘긴 시점에 프로그래머의 날을 맞아 Kimi K3.1 Pro가 정식으로 출시되었고, 동시에 속도가 2~3배 빨라진 Highspeed 버전도 함께 선보였다. 공식은 전체 모델 가중치를 11월 4일까지 공개하겠다고 약속했다. 지난 세대 K3가 발표된 지 벌써 석 달이 넘었다. 이 석 달 동안 월지암면이 겪은 일들은 대부분의 기업이 한 해 동안 겪는 것보다도 많았다. 01 「양 늘리고 가격은 올리지 않는」 0.1 먼저 K3.1 Pro가 무엇인지부터 설명하자. 이는 완전히 새로운 모델이 아니다. 월지암면은 명확히 밝혔다. K3.1 Pro는 K3의 후훈련 버전으로, 기본 아키텍처는 그대로—총 매개변수 2조 8천억 개, 활성화 매개변수 1,040억 개의 혼합 전문가 아키텍처, 문맥 창 크기 100만 토큰, 이미지와 비디오 입력을 원래부터 지원한다는 점도 변함없다. 달라진 것은 후훈련 부분이다. 공식에 따르면, “후훈련 연산력을 대폭 증강”했으며 수백 개의 하위 분야에서 대규모 연합 강화학습을 수행했다. 이를 위해 강화학습 프레임워크, 샌드박스 인프라, 장문맥 추론 등 기반 엔지니어링 전반을 한 번에 재구성했다. 다시 말해, 같은 두뇌를 다시 한 번 어떻게 일을 처리해야 하는지 ‘재교육’한 셈이다. 그 효과는 각종 순위표에서도 드러난다. 프로그래밍 지능 에이전트를 평가하는 Terminal-Bench 4.0에서 K3.1 Pro는 65.7%를 기록해 GPT-6 Astra의 58.2%와 Claude Opus의 66.4%를 각각 앞서며 불과 1포인트 차로 경쟁 상대들을 제쳤다. 지난 세대 K3는

진행 상황 및 관련 보도

FusionEval 발표: 대규모 언어 모델 통합을 위한 새로운 벤치마크 테스트

2026년 10월 24일, 연구자들은 arXiv에 논문 arXiv:2610.30162v1을 발표하여, 대규모 언어 모델의 통합 방법 평가를 위해 설계된 최초의 통합 벤치마크인 FusionEval을 제안했다. 이 벤치마크는 추론 체인 길이, 도구 호출 등 취약한 부분을 포괄하며, 학습 기반 및 학습 불필요형 통합 방법 간의 비교도 지원한다.

FusionEval: Benchmarking Model Fusion for Large Language Models

추천 이유:이 벤치마크는 기존 평가에서 장기 체인 추론과 도구 활용에 대한 포괄성이 부족한 점을 보완하며, 평균 성능과 최악의 성능 간의 명확한 구분을 제공하고, Qwen3/Llama 기반의 재현 가능한 전문가 풀, GPU 메모리 및 실행 시간을 포함한 다차원 지표, 그리고 오픈소스 코드를 제공하여 강력한 실무 지침성을 갖추고 있습니다.

진행 상황 및 관련 보도

연구는 코딩 에이전트 벤치마크에서의 ‘규범-오프체인 오라클 갭’ 문제를 밝혀냈다.

2026년 10월 24일 arXiv에 게재된 한 논문은 현재 주류 코딩 지능 에이전트 벤치마크(예: SWE-Milestone)에 ‘규격–오라클 격차’가 존재한다고 지적한다. 즉, 과제의 자연어 설명에는 테스트에 필요한 핵심 구현 세부사항(예: 상수 이름, 모듈 경로, 정확한 오류 메시지 등)이 포함되어 있지 않아, 평가 결과가 실제로는 상위 코드를 얼마나 재현하는지에 대한 능력을 측정할 뿐이며 진정한 이해와 추론 능력을 반영하지 못한다는 것이다.

What the Specification Did Not Say: Specification-Oracle Gaps in Test-Graded Coding-Agent Benchmarks

추천 이유:이 연구는 해당 유형의 편향을 최초로 형식적으로 정의하고, 다섯 가지 언어를 포괄하는 정적 감사 도구를 구축하여 정확도 89.2%, 재현율 92.9%를 달성했으며, SWE-Milestone에서 25개의 마일스톤 작업에 추론할 수 없는 암시적 의존성이 존재함을 실증적으로 밝혀냈습니다. 이는 실패율을 크게 높였으며(80.6% 대 48.4%), 현재 순위표가 ‘명칭 복사’형 에이전트를 체계적으로 선호할 수 있음을 드러냅니다. 연구 결과는 감사 도구와 수정 자료를 오픈소스로 공개하여 방법론적 및 실무적 측면에서 모두 높은 가치를 지닙니다.

진행 상황 및 관련 보도

Recursive, AI 주도로 개발된 로컬에서 실행 가능한 경량 프로그래밍 모델인 Flint을 출시했습니다.

AI 스타트업 Recursive는 오픈소스 코딩 모델 Flint를 출시했으며, 개발 과정의 대부분이 자체 개발한 AI 연구 시스템 Eureka Machine에 의해 이루어졌다고 밝혔다. 이 모델은 파라미터 수가 400억 개에 불과하며, 실제 테스트에서 활성화 수는 25억 개로 확인되었고, M4 Pro MacBook과 같은 일반 노트북에서도 오프라인으로 실행 가능하다. 추론 속도는 초당 131 토큰에 달하며, SWE-Bench 등 벤치마크 테스트에서 동급 규모의 대부분 모델보다 우수한 성능을 보였다.

진행 상황 및 관련 보도

OpenAI의 최신 GPT-6 시리즈 모델이 Google Cloud와 Antigravity 플랫폼에 도입될 예정입니다.

OpenAI의 GPT-6 및 6.1 시리즈 최첨단 모델(Astra, Sol, Luna)은 향후 수주 내에 Google Cloud Model Garden에 출시되며, Google의 에이전트 기반 프로그래밍 도구인 Antigravity에도 통합될 예정입니다. 이로써 Google은 Gemini, Claude, GPT 등 세 가지 주요 폐쇄형 대규모 언어 모델을 동시에 제공하는 최초의 주류 클라우드 서비스 제공업체가 되었습니다.

진행 상황 및 관련 보도

Claude Mods: 주의력 인터페이스의 첫 번째 실천, 인간이 프로그래밍할 수 있는 에이전트 상호작용 계층

Claude Mods는 Anthropic이 출시한 Claude Code의 프로그래밍 가능 플러그인 시스템으로, ‘주의 인터페이스’(Attention Interface)의 초기 형태를 나타냅니다. 이는 기존의 기계 지향형 에이전트 런타임 프레임워크(agent harness)에서 인간의 주의에 맞춘 맞춤형 상호작용 계층으로 전환합니다. 사용자는 TypeScript/JS로 Mods를 작성하거나 자연어를 통해 Claude에게 자동 생성을 요청함으로써, 언제 중단될지, 어떤 내용을 보게 될지, 어떤 결정을 내려야 하는지를 스스로 정할 수 있습니다.

진행 상황 및 관련 보도

Claude Mods: 프로그래밍 가능한 주의력 인터페이스로 인간과 AI 에이전트 간의 협업 패러다임을 재편합니다

Claude Mods는 Anthropic이 출시한 개발자용 프로그래밍 가능 플러그인 시스템으로, ‘에이전트 하네스’가 기계 측 인터페이스에서 인간 측 인터페이스인 ‘어텐션 인터페이스’로 전환됨을 의미합니다. 이를 통해 사용자는 TypeScript/JavaScript를 활용해 Claude Code의 동작, 렌더링 및 상호작용 로직을 맞춤 설정할 수 있으며, 사람과 AI가 함께 워크플로를 설계하는 것을 가능하게 합니다. 이 메커니즘은 You Should Know와 같은 내장 기능에도 이미 적용되어 있으며, 사용자가 직접 플러그인을 구축하거나 Claude의 도움을 받아 생성하는 것도 지원합니다.

진행 상황 및 관련 보도

Reflection이 오픈소스 대규모 언어 모델 Beam을 발표했습니다: 501B 파라미터의 희소 MoE 아키텍처로, 수백만 단어 규모의 컨텍스트와 다중 단계 추론 제어를 지원합니다.

리플렉션 회사는 오픈소스 대규모 언어 모델인 Beam(매개변수 501B, 실제 활성화 수치 23B/토큰)을 출시했으며, 256개의 전문가 스파스 MoE 아키텍처를 채택하고 1M의 컨텍스트 지원, NVFP4/FP8 양자화, 다중 단계 추론 옵션 구성 및 로컬 배포를 제공합니다. 모든 기술 관련 발표는 제3자 검증을 거치지 않았으며, 하드웨어 요구 사항이 높아 개인 사용자가 이를 감당하기는 어렵다는 평가가 지배적입니다.

진행 상황 및 관련 보도