
04:01
TODAY’S BRIEFING
ニュース一覧 今日のニュース

01 / IN FOCUS
vLLM セマンティックルーターが d3-ultra をリリース:270億パラメータのオープンなマルチモーダル意思決定モデル
MarkTechPost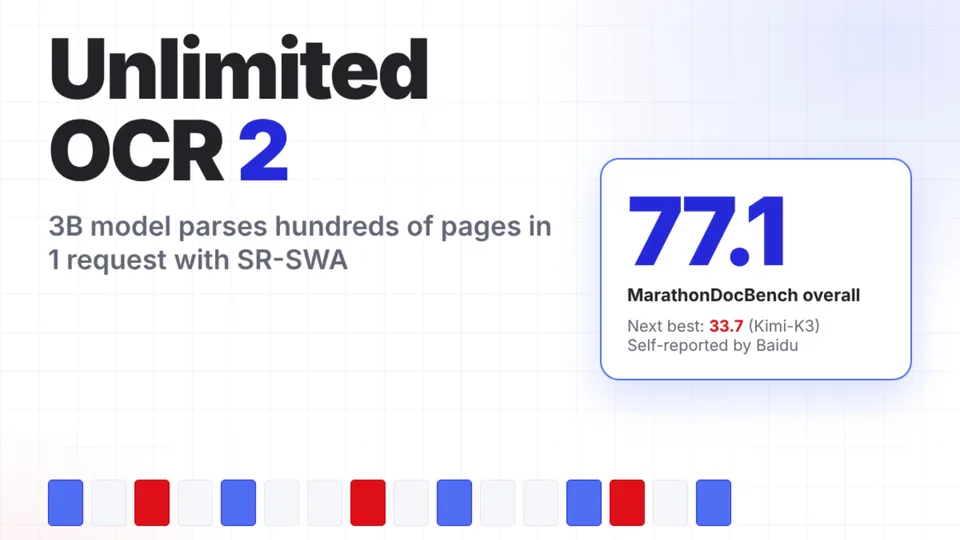
02 / IN FOCUS
百度が、数百ページに及ぶ文書の解析向けのUnlimited OCR 2をオープンソース化
MarkTechPost研究と技術 / 03ヤコビアンレンズの数学的理論arXiv cs.LG
03 / IN FOCUS
ヤコビアンレンズの数学的理論
arXiv cs.LGAIコンテンツ制作 / 04TraceQuery:拡散言語モデルにおけるフルデノイズング軌跡から再計算すべき内容を学習するarXiv cs.CL
04 / IN FOCUS
TraceQuery:拡散言語モデルにおけるフルデノイズング軌跡から再計算すべき内容を学習する
arXiv cs.CL研究と技術 / 05賢くささやく:ASRのファインチューニングにおけるスマートなサブセット選択arXiv cs.CL
05 / IN FOCUS
賢くささやく:ASRのファインチューニングにおけるスマートなサブセット選択
arXiv cs.CL研究と技術 / 06OpenESM:エネルギー駆動モデルはスケーラブルな基礎学習者arXiv cs.CL
06 / IN FOCUS
OpenESM:エネルギー駆動モデルはスケーラブルな基礎学習者
arXiv cs.CL研究と技術 / 07EKTルーター:身体を伴う視覚言語モデルにおける専門家と証拠の整合性arXiv cs.CV
07 / IN FOCUS
EKTルーター:身体を伴う視覚言語モデルにおける専門家と証拠の整合性
arXiv cs.CVモデル動向 / 08Nemotron 3.5 Bolt 74B-A9B 24GB:ローカルAI向けのハイブリッド視覚言語モデルarXiv cs.CV
08 / IN FOCUS
Nemotron 3.5 Bolt 74B-A9B 24GB:ローカルAI向けのハイブリッド視覚言語モデル
arXiv cs.CV研究と技術 / 09証拠に基づく直感:マルチモーダルエージェントのための適応型デュアルメモリarXiv cs.CV
09 / IN FOCUS
証拠に基づく直感:マルチモーダルエージェントのための適応型デュアルメモリ
arXiv cs.CVAI NEWS × FOXAI変化の兆しから、次の一歩へ
AI ツールを探す 最新ニュースから、自分に合うツールまで。
役立つAIツール
横にスワイプ →C Claude汎用アシスタント・検索
 Gemini汎用アシスタント・検索
 Midjourney画像生成・編集
 Krea画像生成・編集
 Runway動画・アニメーション
 Suno音楽・音声
 ElevenLabs音声生成・文字起こし
 Notion AI業務・生産性向上
 Gamma業務・生産性向上
 Cursorプログラミング・開発
Claude汎用アシスタント・検索ClaudeはAnthropicが提供するAIアシスタントで、対話により文章作成や資料の読解、データ分析、プログラミングを支援し、一部のタスクを編集可能なドキュメント、スプレッドシート、またはプレゼンテーションファイルに整理できます。アイデアや資料、下書きをつなぎ合わせたい個人やチームに適しています。
GGemini汎用アシスタント・検索Gemini は Google のAIアシスタントで、対話によって執筆の支援や計画の立案、資料の整理、アップロードされたファイルの分析を行えます。また、Deep Research を使ってテーマに関する資料を検索し、研究レポートを生成することも可能です。
MMidjourney画像生成・編集Midjourneyは、テキストと参照画像から視覚作品を生成するAI創作ツールです。ウェブページの「Create」画面でプロンプトを入力し、生成されたバージョンを比較したうえで、バリエーションや編集、拡大、さらには画像から動画への変換といった機能を使って、さらに創作を進めることができます。
KKrea画像生成・編集Krea は、テキストや参照画像から画像を生成し、さまざまなモデルやバリエーションを比較したうえで、編集や細部の強化・拡大を行える、AI ビジュアルクリエイション向けのワークスペースです。また、動画やその他のクリエイティブツールへのアクセスも提供します。
RRunway動画・アニメーションRunway は、動画生成、ビジュアル編集、クリエイティブな制作ワークフローを一体化したAIプラットフォームです。テキストや画像、既存の映像素材から始め、シーンを生成または編集し、さらに長尺化や拡大、エクスポートまで行えます。コンセプトムービーや広告、その他のビジュアル制作に活用できます。
SSuno音楽・音声Sunoは、テキストによる説明、歌詞、参考素材をもとに楽曲を生成するAI音楽プラットフォームです。ユーザーはボーカル入りの楽曲や音楽を生成し、さらに編集、リミックス、トラックの分離といった機能を使って制作を続け、共有することができます。
EElevenLabs音声生成・文字起こしElevenLabsは、AIによる音声生成、オーディオ制作、音声アバターを提供するプラットフォームです。クリエイターは吹き替え、オーディオブック、ポッドキャスト、ローカライズコンテンツを制作でき、開発者はAPIを通じて音声生成、文字起こし、対話機能にアクセスできます。
NNotion AI業務・生産性向上Notion AI は、Notion のワークスペースに統合された AI アシスタントで、チームのナレッジの検索、ページの生成と編集、データベースの処理、会議内容の整理などに活用できます。ワークスペースと接続済みアプリケーションのコンテキストを組み合わせることで、情報の照会、コンテンツの整理、さらなるタスクの実行を、同じ作業環境で一貫して行えるよう支援します。
GGamma業務・生産性向上Gammaは、AIを活用してプレゼンテーション資料、ドキュメント、ウェブページ、ビジュアルコンテンツの作成を支援する製品で、目的やアウトライン、既存の資料をもとにコンテンツを生成し、その後、対話型操作やレイアウトの調整、自由な編集によって仕上げることができます。
CCursorプログラミング・開発Cursor はソフトウェア開発タスクを中心に機能するAIプログラミング製品で、コードのコンテキスト内で設計、変更、テスト、レビューを支援し、デスクトップ、コマンドライン、クラウドエージェントなどさまざまな利用形態を提供します。
いま起きている AI の変化
1185 件の公開ニュース1185 件のニュース絞り込みを解除 ×
2026-04-09
時系列で変化を追う2026-04-03
時系列で変化を追う16:00
Evaluating alignment of behavioral dispositions in LLMs
Generative AI
翻訳待ち・原文を表示中 · en00:00
Gemma 4: Byte for byte, the most capable open models
Gemma 4: Our most intelligent open models to date, purpose-built for advanced reasoning and agentic workflows.
翻訳待ち・原文を表示中 · en2026-04-01
時系列で変化を追う00:16
2026-03-31
時系列で変化を追う20:00
Spaces: A CLI Built for Humans and Agents
Spaces: A CLI Built for Humans and Agents
翻訳待ち・原文を表示中 · en10:03
2026-03-29
時系列で変化を追う18:50
Reimagining the mouse pointer for the AI era
Google DeepMind is transforming the mouse pointer into a context-aware AI partner. Move beyond the friction of traditional prompting with intuitive AI collaboration in Chrome and beyond.
翻訳待ち・原文を表示中 · en2026-03-26
時系列で変化を追う23:23
Gemini 3.1 Flash Live: Making audio AI more natural and reliable
Our latest voice model has improved precision and lower latency to make voice interactions more fluid, natural and precise.
翻訳待ち・原文を表示中 · en00:46
00:01
Lyria 3 Pro:より多くの場所で、より長いトラックを作成できます
構造を意識したより長いトラックを実現するLyria 3 Proをご紹介します。また、Lyriaをより多くのGoogle製品やサービスに展開しています。
2026-03-25
時系列で変化を追う17:14
03:54
01:42
2026-03-24
時系列で変化を追う00:00
Speaking of Voxtral
Voxtral TTS: A frontier, open-weights text-to-speech model that’s fast, instantly adaptable, and produces lifelike speech for voice agents.
翻訳待ち・原文を表示中 · en2026-03-18
時系列で変化を追う03:47
00:57
00:03
AGIに向けた進捗の測定:認知フレームワーク
私たちは、AGIへの進捗を測定するためのフレームワークを導入し、関連する評価項目の構築を目的としたKaggleハッカソンを開始します。
00:00
Introducing Forge
Today, we’re introducing Forge, a system for enterprises to build frontier-grade AI models grounded in their proprietary knowledge.
翻訳待ち・原文を表示中 · en2026-03-17
時系列で変化を追う05:00
04:00
Mistral partners with NVIDIA to accelerate open frontier models
Mistral partners with NVIDIA to accelerate open frontier models
翻訳待ち・原文を表示中 · enすべての更新に、たどれる出典を。