本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI の全ニュース

出典・テーマ・日時から、気になるニュースを見つけられます。

公開日時順

b11927

metal:GGML_OP_TOP_K_MASK を追加(#31230) * metal:GGML_OP_TOP_K_MASK を追加 CUDA バックエンドから融合された top-k マスクを移植:グリッドストライドカーネルが出力に -inf を埋め込み、その後、各行ごとに 1 つのスレッドグループが、保持されるセルのマスク値を上書きします。関数定数は、特定のグラフで使用されないスコア、ブロック、および余分な経路を除外します。 協力者:dsh:llama.cpp/ggml-org/Qwen3.8-Flash-Next-GGUF(MacBook、M5 Max、128GB) * metal:top-k マスクカーネルの書式を整備 協力者:dsh:llama.cpp/ggml-org/Qwen3.8-Flash-Next-GGUF(MacBook、M5 Max、128GB) **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b11927/llama-b11927-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI 有効)[無効](
経緯と関連報道

b11926

glm5-next:kq_maskなしのQSA(+ DSA)(#31009)* glm5-next:kq_maskなしのQSA * DSA:dsa top-kマスクの変更を、DeepSeek-V3.2のレイヤー0および3でテスト済み **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b11926/llama-b11926-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI有効)[無効化](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b11926/llama-b11926-bin-macos-x64.tar.gz) - [iOS XCFramework](https://github.com/ggml-org/llama.cpp/releases/download/b11926/llama-b11926-xcframework.zip) **Linux:** - [Ubuntu x64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b11926/llama-b11926-bin-ubuntu-x64.t)

経緯と関連報道

開発者はAI時代の基盤による恩恵をいかに捉えるべきか?CEIC×1024深圳特別セッションが、AIとHarmonyOSによる新インフラ整備を解き明かす

2026年の長沙・1024プログラマーの日に開催されたCEIC消費電子イノベーション大会とCSDNは、深圳で開発者向けの本格的な技術の祭典を共同で実現しました。CEIC組織委員会の常務副主任である楊涛氏がインタビューで述べたように、「消費電子分野におけるあらゆる体験の革新は、結局のところ私たちプログラマーが打ち込むコードによって生み出されるのです。」現在の技術の転換点において、単なる手書きのコードから、エージェントや豊富な端末側APを活用する時代へと進んでいます…

开发者如何接住AI时代的底座红利?CEIC×1024深圳专场解密AI与鸿蒙开发新基建
経緯と関連報道

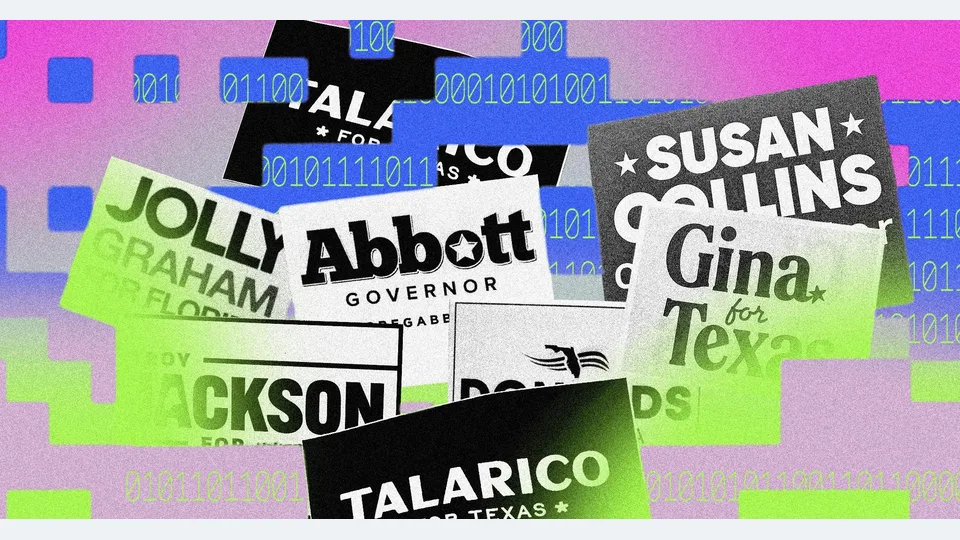
データセンターの拡張が全米各地で地元住民の反対を招き、2026年の中間選挙における重要な争点となっている

『The Verge』2026年10月27日の報道によると、米国各地のコミュニティでは、データセンターの大規模な建設とそれに伴うインフラ整備費用の急増をめぐり広範な反対運動が勃発しており、この問題は複数の連邦議会選挙および州知事選挙に深刻に影響を及ぼしている。テクノロジー系資本の参入も加速しており、マーク・アンドリーセン氏とグレッグ・ブロックマン氏が支援するスーパーPAC「Leading the Future」は、1年間で4,500万ドルを投入しているほか、Anthropicが支援する「Public First Action」も同様に参画している。

新闻源配图 · The Verge · AI

注目する理由:材料の出典が明確であり(The Verge)、公開日時が現在のシステム時刻と一致している(2026-10-27)、内容は検証可能な公共政策および選挙動向に焦点を当て、具体的な主体・金額・時間軸・組織間の関係性を含んでおり、時事性と事実に基づく正確性の要件を満たしています。

経緯と関連報道

b11925

ci:ROCm リリースビルドで ccache の依存モードを使用 (#31231) **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon (arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b11925/llama-b11925-bin-macos-arm64.tar.gz) - macOS Apple Silicon (arm64、KleidiAI 有効) [無効](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel (x64)](https://github.com/ggml-org/llama.cpp/releases/download/b11925/llama-b11925-bin-macos-x64.tar.gz) - [iOS XCFramework](https://github.com/ggml-org/llama.cpp/releases/download/b11925/llama-b11925-xcframework.zip) **Linux:** - [Ubuntu x64 (CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b11925/llama-b11925-bin-ubuntu-x64.tar.gz) - [Ubuntu arm64 (CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b1192)

経緯と関連報道

b11923

ggml:非連続なビューに対してスケールを緩和 (#31146) * ggml:非連続なビューに対してスケールを緩和 SCALE では src0 が 1 次元の連続メモリであることが要求されます。これを、任意の行ストライド(ggml_is_contiguous_rows)を持つ次元 0 の連続性に緩和し、Metal バックエンドの単項演算と同様の動作を実現します。 - ggml:ggml_scale_impl におけるアサートを緩和 - cpu:src0 の各行をバイトストライド(f32、bf16)に基づいてアクセス - cuda:ストライド対応のカーネル、高速除算による行分解 - metal:bf16 スケールをサポート(ガード付きの単項インスタンス化) - sycl:ゲートは連続状態を維持し、カーネルはフラットな f32 を使用 test_scale にビュー変種を追加。CPU、Metal、CUDA で検証済み。補助者:dsh:llama.cpp/ggml-org/Qwen3.8-Flash-Next-GGUF(RTX 5090 32GB、DDR5 128GB) * cuda:非連続なビューではソフトキャップ融合をスキップ 融合されたソフトキャップカーネルは src と w を読み込みます

経緯と関連報道

b11922

tests:訓練済みモデルに対するマルチシーケンス分割リプレイおよび部分状態のケースを修正(#31216)* tests:訓練済みモデルに対するマルチシーケンス分割リプレイを修正 ロールバック時のスナップショットは、ロールバックされた末尾をデコードしたグラフによって取得される一方で、参照コンテキストは異なるバッチ形状を持つ同じプレフィックスをデコードします。両者の状態は最後のビット部分で異なり、訓練済みモデルではリプレイされる各トークンごとにその差が拡大されます。各シーケンスの最初にリプレイされたトークンのみを比較し、その後、シーケンス1つ分だけの末尾が存在する前の状態を参照コンテキストに復元します。補助者:dsh:llama.cpp/ggml-org/Qwen3.8-Flash-Next-GGUF(MacBook、M5 Max、128GB)* tests:分割リプレイにおいてビット単位で正確なシーケンス1の分離を要求 シーケンス状態の保存は常にビット損失なしとは限らず、SWAでマスクされたセルは保存されないため、残りの部分を再読み込みします

経緯と関連報道

b11921

llama:メモリインスタンスから廃止されたn_padを削除(#31200) すべての呼び出し元でn_pad = 1が渡されており、使用している2つの実装のみがそれを256に固定しています。このパラメータおよびそのメンバ変数、さらに自明に真であるkv_sizeのアサートは削除します。 協力者:dsh:llama.cpp/ggml-org/Qwen3.8-Flash-Next-GGUF(MacBook、M5 Max、128GB) **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b11921/llama-b11921-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI有効)[無効化](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b11921/llama-b11921-bin-macos-x64.tar.gz) - [iOS XCFramework](https://github.com/ggml-org/llama.cpp/releases/download/b11921/llama-b11921-xcfram)

経緯と関連報道

b11919

opencl:mul mat id -1 インデックスを改良(#31170) 協力:Codex **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b11919/llama-b11919-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI有効)【無効】(https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b11919/llama-b11919-bin-macos-x64.tar.gz) - [iOS XCFramework](https://github.com/ggml-org/llama.cpp/releases/download/b11919/llama-b11919-xcframework.zip) **Linux:** - [Ubuntu x64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b11919/llama-b11919-bin-ubuntu-x64.tar.gz) - [Ubuntu arm64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b11)

経緯と関連報道

b11918

opencl:q3_k の初期サポート(#31172)* opencl:q3_k AOS メモリ転送を追加* opencl:q3_k SOA メモリ転送およびタイリングされた行列乗算を追加* opencl:adreno 用に q3_k noshuffle gemm/gemv を追加* opencl:adreno 用に q3_k dp4a gemm を追加共著者:Hongqiang Wang* opencl:adreno 用に q3_k カーネルをチューニング共著者:Hongqiang Wang---------共著者:Hongqiang Wang**ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b11918/llama-b11918-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI 有効)[無効化](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b11918/llama-b11918-bin-macos-x64.tar.gz) - [iOS XCFramework](https://github.com/ggml-org/ll)

経緯と関連報道

vLLM セマンティックルーターが d3-ultra をリリース:270億パラメータのオープンなマルチモーダル意思決定モデル

vLLMセマンティックルーターは、270億パラメータ規模のオープンウェイトなマルチモーダル意思決定モデルであるd3-ultraをリリースしました。同モデルはテキスト、画像、動画を一度に読み込み、各回答に対する確率を返却し、チームのSR-Textテストで87.2点を獲得しています。この記事「vLLMセマンティックルーター、270億パラメータ規模のオープンマルチモーダル意思決定モデルd3-ultraをリリース」は、MarkTechPostに最初に掲載されました。

新闻源配图 · MarkTechPost
経緯と関連報道

LooseLeaf:計算ノートブック向けのサーバーレスGPUを実現

arXiv:2610.33275v1 発表タイプ:新規 要旨:計算ノートブックはセッション全体にわたってGPUを占有しますが、GPUが計算を行うのはセルが実行中であるときだけで、それ以外の時間はアイドル状態となります。サーバーレス実行であれば、セル間でGPUを解放できますが、新しいワーカー上で蓄積されたノートブックの状態を再構築するには、各GPUセルごとに大きなコストが伴います。本論文では、対話型ノートブック向けのサーバーレスGPUプラットフォームであるLooseLeafを提案します。LooseLeafは、各セルの状態とインポートクロージャー、すなわちそのセルが必要とする最小限の変数やパッケージを導出します。実世界のノートブック5,000件に対する分析から、これらのクロージャーは非常に小さく、ユーザーによるセルの編集によっても、準備に要する時間は数秒程度であることが示されました。LooseLeafは、ユーザーがセルを編集している間に、これらのクロージャーを用いてGPUワーカーを準備します。実行後、ワーカーは…

新闻源配图 · arXiv cs.DC
経緯と関連報道

クラウドにおける大規模言語モデル:アーキテクチャ、オーケストレーション、推論に関する議論

arXiv:2610.33475v1 発表タイプ:新規 要旨:クラウドデータセンターにおける基盤となる大規模言語モデル(LLM)の広範な導入は、ステートレスなディープラーニングから分散型でメモリ集約的な生成ワークロードへと、根本的なパラダイムシフトを示しています。しかし、厳しいサービスレベル目標(SLO)の下で巨大な基盤モデルを運用するには、重要な物理的およびシステム上のボトルネックが露呈します。これらの課題には、依然として克服されていない高帯域幅メモリ(HBM)の壁、計算負荷に依存するプリフィル処理とメモリ帯域幅に制約されるデコード処理との間の運用上の非対称性、急増するキー・バリュー(KV)キャッシュの膨張、コスト面で非常に負担の大きいサーバーレス環境でのコールドスタート、さらにはハードウェアの信頼性に関する脆弱性などが含まれます。既存の文献レビューは依然として層ごとの分断状態にあり、低レベルのアクセラレータ仮想化とクラスター間の統合が切り離されたままです。

経緯と関連報道

DualPace:大規模言語モデルの推論における、非同期スケジューリングとGPU–CPU協調デコード

arXiv:2610.33501v1 発表タイプ:新規 要旨:大規模言語モデル(LLM)のサービスでは、推論スループットを向上させるためにバッチ処理が用いられるが、キー値(KV)キャッシュはシーケンス長に応じて増大し、GPU上での並行処理能力を制限する要因となっている。CPUオフロードによりホストメモリを活用してKV容量を拡張することは可能だが、既存のシステムは依然として大部分がGPUに依存しており、CPU上に常駐するリクエストが進捗するのは、GPUスケジューラが適切なオーバーラップの機会を提供した場合に限られる。その結果、ホストメモリとCPU計算は独立したサービス資源として機能せず、負荷下ではCPU側の進捗が断続的になり、末端のトークン間遅延(ITL)が過剰に増大するという問題が生じる。本稿では、ホストを独立してスケジュール可能なデコードエンジンへと変える、LLM向けの実行時環境であるDualPaceを提案する。DualPaceは、スケジューリング権限を二つのエンジン間に分割し、GPUエンジン

経緯と関連報道

b11913

hexagon:GGML_HEXAGON_VTCM_SIZE を追加(#31221)* hexagon:GGML_HEXAGON_VTCM_MB および GGML_HEXAGON_NTHREADS の上限を追加 変更ID:Idffe1613c8db6f96aa842d43d1b2efaed45462a8 * hexagon:VTCM 上限を GGML_HEXAGON_VTCM_SIZE に名称変更し、NTHREADS 上限は廃止 変更ID:If4c5b9ce9fd6b725c3561421c2295d40599d012d * hexagon:GGML_HEXAGON_VTCM_SIZE をオーバーライド可能な設定とし、K/M/G の接尾辞を許容 変更ID:Ib8eea84c22f24e6d986b37f215e504b046478c2c **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b11913/llama-b11913-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI 有効)[無効化](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b11913/llama-b)

経緯と関連報道

b11912

llama:laguna向けにmoe amaxリスケーリングを有効化(#31147)* llama:laguna向けにmoe amaxリスケーリングを有効化 支援者:Devin * llama:lagunaのsmテンソルサポートを宣言 **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b11912/llama-b11912-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI有効)[無効](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b11912/llama-b11912-bin-macos-x64.tar.gz) - [iOS XCFramework](https://github.com/ggml-org/llama.cpp/releases/download/b11912/llama-b11912-xcframework.zip) **Linux:** - [Ubuntu x64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b11912/llama-b11912-bin-u)

経緯と関連報道

Anthropicは、AIブームを支えるためにガスを燃やしている

上場準備を進めるなか、AnthropicのS-1届出書は、生成AIがメタンに依存している現状を露骨に示している。「電力供給へのアクセスや、十分な電力供給が確保できるデータセンターの立地を巡る競争は激化している。」米証券取引委員会に月曜日提出された文書において、Anthropicは、データセンターがますます「天然ガス」に依存するようになっていることを認めている[…]

Anthropic is burning gas to feed the AI boom
経緯と関連報道