
斯坦福大学与加州大学伯克利分校的研究人员推出 TokenGate:基于令牌的注意力机制使长上下文预填充速度提升高达 11.3 倍
斯坦福大学与加州大学伯克利分校研究人员提出TokenGate——一种可即插即用的学习型令牌剪枝模块,适用于现有大语言模型(LLM)。该方法在不损失准确率的前提下,将长上下文预填充的首字生成时间(TTFT)加速1.4至11.3倍,峰值内存降低1.5至3.4倍。相关代码与检查点已开源。

检索标题、摘要与正文,把分散的信息连起来。
斯坦福大学与加州大学伯克利分校研究人员提出TokenGate——一种可即插即用的学习型令牌剪枝模块,适用于现有大语言模型(LLM)。该方法在不损失准确率的前提下,将长上下文预填充的首字生成时间(TTFT)加速1.4至11.3倍,峰值内存降低1.5至3.4倍。相关代码与检查点已开源。
Anthropic于2026年10月8日推出OSS Scanner——一款基于Claude Mythos等强模型的免费、可选加入式AI漏洞扫描工具,专为关键开源项目设计;截至10月19日,已接收114个项目,11天内报告77个严重级和803个高级别漏洞(模型评级),88%的抽样审计结果符合其披露标准。
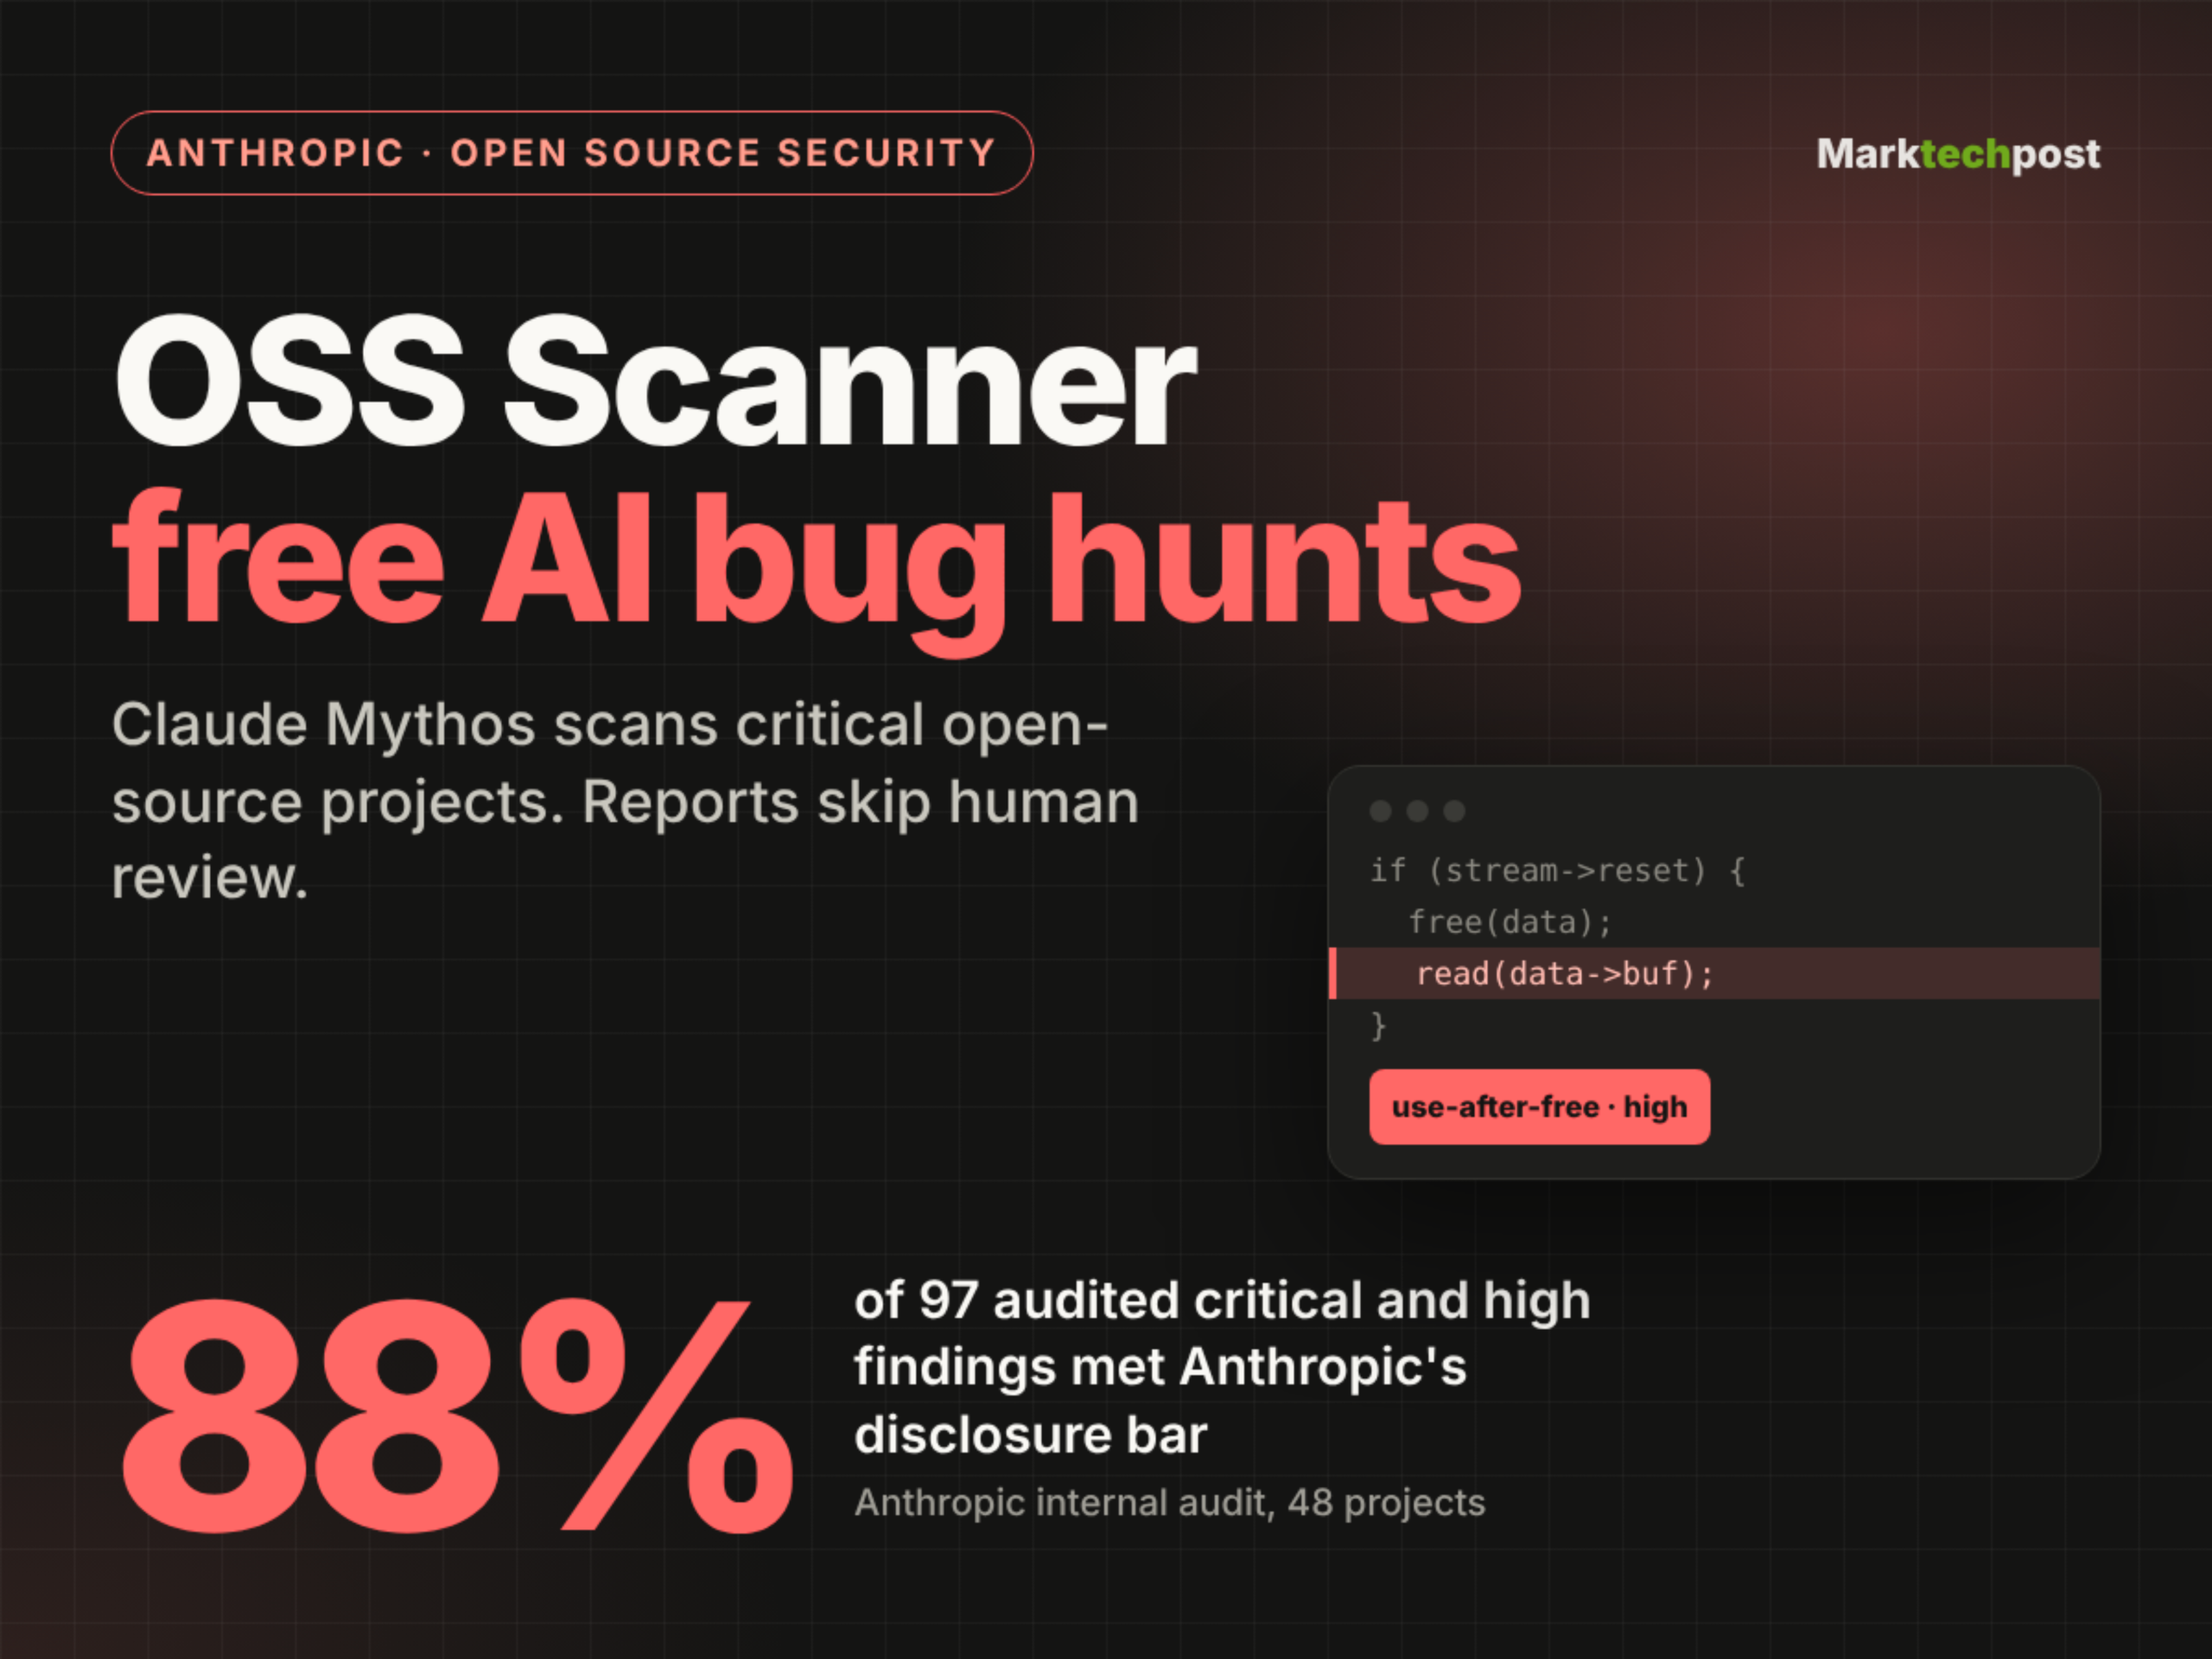
推荐理由:该工具代表LLM在开源安全领域的规模化落地实践,以零成本、全自动、离线审计为特点,但跳过人工审核环节带来误报与重复问题风险;其精度数据(88%有效率、1%假阳性)和真实项目反馈(如wolfSSL、curl)提供了当前AI驱动漏洞发现能力的实证基准。
第958期《The Sequence Radar》把推理软件、模块化AI工厂及企业AI投入放在一起观察:单次推理更便宜,并不必然意味着行业总投入更低。本篇按原刊整理,并以DeepSeek与英伟达官方资料补充技术范围和交付条件。
Kimi于2026年10月25日发布K3.1 Pro模型,在Terminal-Bench 4.0终端任务测试中以67.2%成功率位列第一;其自主修复仿真器错误、完成物理模拟、音频分析、3D场景构建及视频剪辑等多任务能力,指向具身智能技术路径探索。
推荐理由:材料基于钛媒体授权发布的实测报告,涵盖权威第三方评测数据(Artificial Analysis、Terminal-Bench 4.0等)、官方自测结果及作者多场景功能验证,聚焦K3.1 Pro在执行能力、仿真闭环、多模态编程上的实质性进步,同时明确标注性能局限与未公开信息(如Flash/Ultra尚未发布),符合事实核查与信源标注要求。
英飞凌与Wolfspeed于2026年10月15日宣布扩大并延长碳化硅晶圆供应协议,将合作从150mm延伸至200mm规格,旨在支持英飞凌200mm制造转型、增强供应链韧性;Wolfspeed则借此拓展200mm材料在头部客户中的长期应用,但其材料业务仍面临营收下滑与负毛利率压力。


推荐理由:该事件标志着全球碳化硅产业竞争重心正式前移至大尺寸衬底与制造环节,是产业链上下游协同推进200mm量产的关键信号;材料来源明确(钛媒体2026-10-25发布),所有事实均严格对应原文所列时间、主体、数据及限制条件,无推断、无补全、无引申。
2026年9月起,TCL华星、京东方、惠科等面板厂商密集发布涨价函,主因AI大模型发展导致HBM需求激增,挤占成熟制程芯片产能,推高驱动IC、PCB、玻璃基板等关键物料价格;康宁等上游供应商同步提价。尽管成本端压力明确,但下游电视/显示器品牌采购价未普涨,终端用户投诉过热、黑点等品控问题频发,涨价尚未转化为实际成交与体验升级。
推荐理由:材料系统揭示了AI产业对非直接关联硬件行业的跨链传导机制——非因AI拉动面板需求,而是通过晶圆产能再分配引发全链条成本重定价;同时呈现涨价行为与市场真实反馈(价格僵持、出货下滑、用户投诉)之间的显著落差,凸显产业议价权与产品力不匹配的深层矛盾。
微软以采用NVIDIA RTX Spark的Surface Laptop Ultra争取本地AI开发者与高端创作者。硬件把大容量统一内存、CUDA和RTX图形能力带入便携设备,但能否形成对Mac的持续竞争,仍取决于应用适配、智能体体验和真实工作流。
推荐理由:这场竞争最终要回答的,是本地AI能否切实改善创作和开发效率,以及用户为此承担的设备、软件与迁移成本是否值得。硬件提供了新的可能性,生态和实际体验决定这种可能性能够覆盖多少用户。
TechCrunch于2026年10月25日发布报道,梳理了2023至2026年间多个未能达预期的AI项目,包括Relay、Character.ai、Sora、Humane AI Pin等初创与产品,以及OpenAI、Apple、Microsoft等大厂的失败尝试或重大调整。

推荐理由:该报道为行业级现象性盘点,覆盖范围广、时间跨度清晰(含具体关停/延迟日期),并引用S&P Global Market Intelligence数据佐证企业级AI项目高废弃率(42%),兼具案例细节与结构性分析,具典型参考价值。
安全研究人员借助AI工具,将已存在多年、曾被认为难以利用的PHP漏洞(统称PHP2Shell)转化为可实际 exploited 的攻击面;漏洞公开数小时内即遭百万次尝试利用,但迄今无成功入侵报告。
推荐理由:该事件首次清晰呈现AI并非凭空创造新漏洞,而是显著降低历史漏洞的利用门槛,凸显AI在攻防两端加速既有安全动态的双重作用,且所有有效发现均依赖人机协同。
Sebastian Raschka于2026年10月24日在Ahead of AI杂志(magazine.sebastianraschka.com)发布一套共八讲、超11小时的Python与PyTorch实操视频课程,系统讲解推理模型的评估、推理时扩展、强化学习(RLVR)与知识蒸馏,基于预训练Qwen3-0.6B模型实现全部方法。
推荐理由:该课程是作者继《从零构建大语言模型》后推出的进阶技术教育内容,聚焦当前主流LLM的核心演进方向——推理能力增强,覆盖从基础环境搭建到GRPO强化学习、自蒸馏等完整技术链,且明确声明所有实现均‘从零手写’、可复现,具备强教学性与工程参考价值。
Anthropic于2026年10月24日开源sandbox-runtime(srt),一款不依赖容器的OS级沙箱工具,用于限制AI代理、MCP服务器及CLI工具的文件读写与网络访问权限;支持macOS(Seatbelt)、Linux(bubblewrap)及Windows(alpha),npm包v0.0.81,Apache-2.0许可。
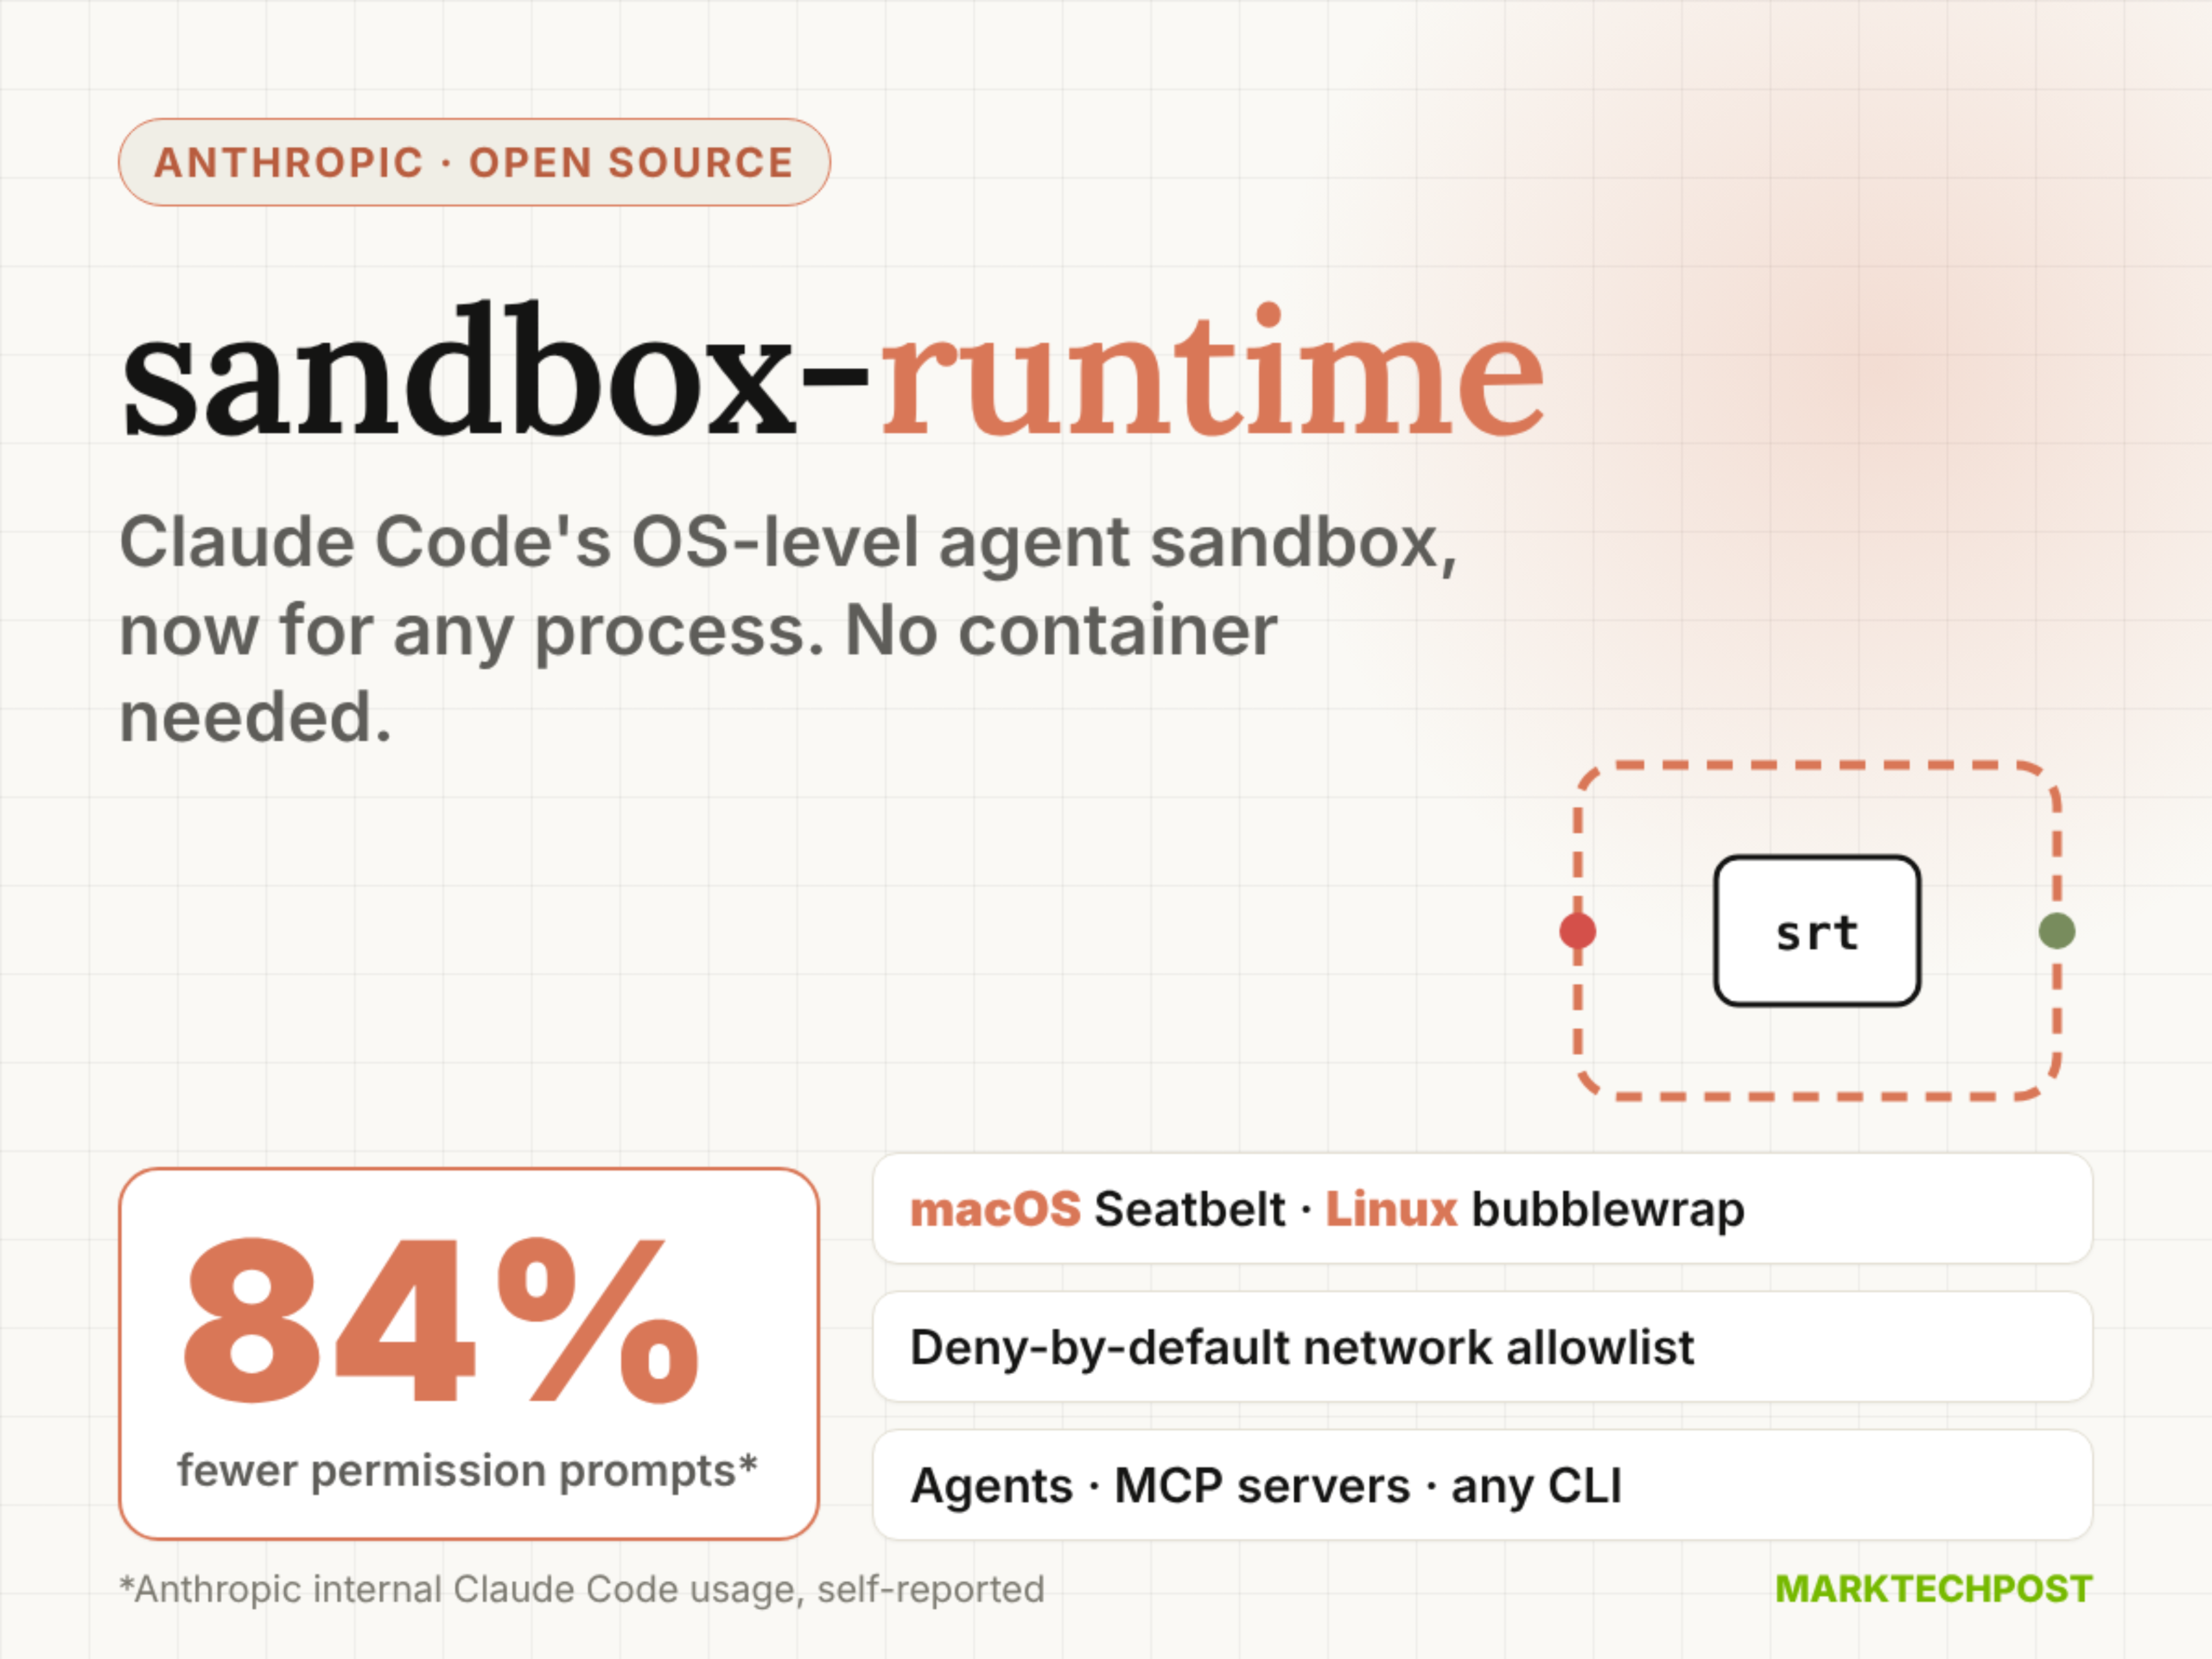
推荐理由:该工具代表AI安全基础设施的重要演进——通过操作系统原生隔离机制实现细粒度、进程树全覆盖的沙箱控制,直面提示注入与权限泛滥风险,且已投入Claude Code内部使用验证效果。
月之暗面于2026年10月22日前后发布Kimi K3.1 Pro,一款2.8万亿参数、1040亿激活参数的多模态MoE模型,宣称性能逼近Fable 5.1;官方承诺11月4日发布开源权重,但截至报道时权重尚未公开;独立评测显示其在智能指数、代码与网络安全基准中表现突出,但存在推理成本、本地部署可行性及营销透明度等争议。
推荐理由:该事件标志着当前最接近闭源前沿模型能力的开源权重模型正式进入发布倒计时,是AI开源生态关键进展;材料来源为Latent Space旗下AINews(2026年10月24日发布),内容基于对X平台、Reddit、Arena及Artificial Analysis等多方独立评测的整合,信息密度高且具时效性与交叉验证特征。
2026年10月24日,研究者在arXiv发布论文arXiv:2610.30841v1,正式推出TRIAD基准——专用于评估文本、图像与音频三模态协同歧义消解能力的新评测框架。该基准含327个手工构建的三模态样本,覆盖86个场景组和18类跨模态歧义类型。

推荐理由:该成果直击当前多模态大模型评测的核心盲区:现有基准多聚焦确定性输入下的感知或推理,而TRIAD首次系统性地以‘模态互补消歧’为评测目标,通过严格设计的留一模态反事实测试,揭示模型(尤其对音频)利用不足、场景级鲁棒性薄弱等关键缺陷,为下一代全模态模型评估提供可复现的诊断协议与分类法。
2026年10月24日,arXiv发布论文arXiv:2610.30705v1,提出ULME——一种面向因果解码器型大语言模型的后训练框架,通过预测耦合(predictive coupling)机制,首次实现文本嵌入与语言生成能力的相互增强式统一。该方法在Qwen2.5/Qwen3系列(0.5B–8B参数)上验证有效,MTEB提升3.3–4.1分,同时保持生成任务(MMLU等)性能不降。
推荐理由:该论文直指当前多模态LLM能力割裂的核心问题:嵌入与生成长期由独立模型或仅参数共享的‘伪统一’模型承担。ULME通过可学习插槽与三目标联合训练(含stop-gradient预测损失),使生成过程主动塑造嵌入表征,属架构层面的实质性突破;实验覆盖广、基线强、指标全面,且发布于权威预印本平台,时效性与技术严谨性兼备。
2026年10月24日,研究者在arXiv(编号2610.30828v1)发布TutorCaseBench——一个基于教育学、教育心理学与特殊教育真实案例构建的LLM家教评估基准,聚焦支持存在学习与行为困难学生的能力。该基准含923段对话、覆盖5类挑战行为,采用开放式生成(1560题)与多选题(2537题)双轨评估;11个前沿大模型中表现最优者仅在55.8%的开放题中满足评估标准。
推荐理由:该研究填补了现有AI教育评估忽视特殊需求学生行为复杂性的关键空白,方法论强调证据溯源(qualitative case studies + source-grounded rubrics),数据全部开源,具备可复现性与教育实践相关性;结果明确揭示当前LLM在情境化响应生成上的显著短板,对教育AI落地具警示与指导价值。
2026年10月24日,arXiv发布论文arXiv:2610.30690v1,提出一种由两名临床医生主导定义、定稿与裁决的四条安全检查规则库,经形式化验证后作为守卫层应用于心理健康场景下的大语言模型(LLM)输出。该守卫层所有判断均可从一条命名规则和十六个事实复现,旨在提升安全性判断的可解释性与可检验性。
推荐理由:该研究提供了一种区别于主流prompt工程、LLM-as-a-Judge或Constitutional AI的安全增强路径,其核心创新在于将临床决策结构化、形式化并全程留痕;所有关键主张(如规则数量、验证方式、事实基数、对比实验数据及成本测量)均来自原文明确陈述,且发布时间(2026-10-24)与当前UTC日期(2026-10-25)一致,具备时效性与可信基础。
该研究使用500条Arena-Hard v2.0提示,固定两个模型的回答,以GPT-4.1为裁判,在8种指令组合下重复评测,发现即使聚合分数变化微小(如±1分),高达21.2%的单条提示判决结果(胜/平/负)发生改变;指令调整进一步放大不稳定性,最高导致28.2个百分点的额外判决变动,而聚合分数却可能几乎不变。
推荐理由:研究直击当前LLM评估实践的核心盲区——过度依赖聚合分数而忽视个体判决的可复现性与指令依赖性,为偏好建模、人类反馈强化学习(RLHF)等依赖细粒度判决的任务提供关键方法论警示。
2026年10月24日,arXiv发布论文arXiv:2610.30435v1,提出Self-Assessment Reinforcement Learning(SARL)框架,旨在解决现有检索增强大语言模型中搜索代理缺乏搜索状态感知能力的问题。
推荐理由:该研究针对检索增强型大语言模型在复杂任务中因无法识别已获/缺失信息而导致幻觉推理和过早终止搜索的关键缺陷,提出无需测试时额外评估的端到端强化学习方案,并在多跳推理与深度研究基准上取得显著性能提升。
2026年10月24日,研究者在arXiv(编号2610.30161v1)发布TauIndianBankBench——一个包含1000个任务的行动导向型基准,专用于评估语言模型驱动的银行对话代理是否严格遵循操作规程(如销户前须获取结清报价),而不仅依赖最终记录判断成败。
推荐理由:该基准直击当前LLM评估盲区:传统方法仅核查对话终态记录,导致6.5–12.0%存在程序跳步或未授权操作的会话被误判为成功;其程序感知设计填补了印度银行业务自动化中合规性评估的关键缺口。
该论文于2026年10月24日在arXiv发布(编号2610.30379v1),提出MemPlan——一种将大语言模型(LLM)作为语言与符号规划之间受限桥梁的记忆条件化PDDL规划框架,适用于部分可观测的交互式文本环境。
推荐理由:MemPlan通过正向图记忆与负向记忆机制动态重构PDDL问题,显著提升任务完成率与步数效率,同时大幅降低在线token消耗;其离线微调的语言–符号接口可跨TextWorld任务类型复用,无需任务特化微调,体现了方法的泛化性与实用性。