跳到正文
AI NEWS JOURNAL
AI, IN PERSPECTIVE

搜索 AI 资讯

检索标题、摘要与正文,把分散的信息连起来。

按发布时间排序

DMAIC-Bench:面向多阶段分析任务中智能体的自我反思与自我约束

arXiv:2610.32305v1 发布类型:新 摘要:多阶段分析任务要求大型语言模型(LLM)代理利用中间证据来决定是继续、重定向还是停止。自我反思——即代理对其输出进行批判性评估——已得到广泛研究,然而,这种批判性评估并不能说明证据是否确实影响了下一步行动。我们将这一能力称为“自我约束”。现有的代理基准测试大多仅衡量任务完成度或输出质量,而未对这一能力进行检验。DMAIC-Bench 通过围绕精益六西格玛明确的统计前提条件构建的、涵盖四个行业领域中15个工业场景的97个种子任务,对此进行了评估。成对的反事实变体在相同的工作流位置上要求采取相反的动作,从而能够区分有依据的自我约束与无差别的随意停止。我们采用……对执行轨迹进行评估。

事件进展与其他报道

面向历史文献转录的OCR系统实体感知评估

arXiv:2610.33004v1 发布类型:新 提要:光学字符识别(OCR)对于历史档案的数字化至关重要,然而诸如字符错误率(CER)等标准评估指标并不一定能反映诸如姓名、日期和标识符等重要信息是否得以保留。在本研究中,我们从实体层面分析OCR错误,以此作为评估历史文献中OCR质量的补充视角。我们使用了一个公开的基准数据集,包含来自Berrutti档案馆的175份文档,并辅以5,209个经人工标注的实体提及——这些标注将在论文被接收后公布——对序列识别型OCR系统、专为OCR设计的视觉-语言模型以及通用视觉-语言模型进行了比较。除了全局转录准确率之外

事件进展与其他报道

LeafSkill:用于递归LLM智能体的高效叶级动作定位

arXiv:2610.32412v1 发布类型:新 摘要:递归式大型语言模型(LLM)智能体通过分解、执行与环境反馈来解决长周期任务。然而,在生成一个原子级子任务后,它们往往再次调用同一款大型模型,将熟悉的指令转化为可执行的动作。我们观察到,高层规划具有任务特异性,而底层动作的具身化则在不同任务间反复出现,并且能够对照环境允许的动作进行验证。为此,我们提出了 LeafSkill,这是一种外部复用层,它能够检索语义相关的具身化经验,将动作模板与当前对象及可执行动作绑定,并借助一个轻量级的 17 亿参数选择器来决定采用已绑定的动作,或将未发生变化的子任务交由原始智能体继续处理。技能始终处于外

事件进展与其他报道

是我的还是你的?经由心智桥接的语言模型会将彼此的记忆据为己有

arXiv:2610.33020v1 发布类型:新 摘要:如果你的大脑直接与他人的大脑相连,你还能分辨哪些想法属于你自己吗?我们构建了一个功能版本,其中包含同一语言模型的两个副本:每个副本都持有各自的私有规则和代码词,而其中一个副本——接收端——还会关注其伙伴的内部记忆。接收端将伙伴的任务视为自己的任务。当被问及自己被分配了哪条规则时,在伙伴的记忆权重为双倍的情况下(无链接时则为零),它在97%的回答中给出了伙伴的规则;而在开放性报告中,它甚至将自己的伙伴的代码词称为“自己的”,而非伙伴的。所有权并不取决于接收端判断伙伴所分配内容的能力。在权重相等的情况下,这种连接使接收端大约以一半的概率采纳伙伴的规则。

事件进展与其他报道

前缀键值对的重要性:在循环语言模型中用于自推测解码的RIPE缓存

arXiv:2610.34436v1 发布类型:新 摘要:循环语言模型在每个标记上会运行 $R$ 轮层,因此其键值(KV)缓存为每递归层保存 $R$ 个平面,而自推测解码(先用几轮进行初步推断,再用全部 $R$ 轮进行验证)则会读取所有这些平面。我们发现,前缀键值的影响主要体现在较晚的阶段:在扰动幅度相同的情况下,第 25 至 32 轮的敏感度分别是第 2 至 9 轮的 $e^{15.0}$ 倍(Huginn-0125)和 $e^{12.8}$ 倍(Raven-Llama),且各平面的敏感度随循环次数呈几何级数下降,每轮分别降至 0.88 和 0.81。至于是否仅保留最深层的平面即可,这取决于后期各平面的成熟度:在 Raven 上,仅存储最深层平面与从 bf16 转换为 fp32 的效果几乎无差异;而在 Huginn 上,仅有 1% 的位置就贡献了其误差的 74%。我们将这一发现转化为 RIPE,该方法仅存储最深层的

事件进展与其他报道

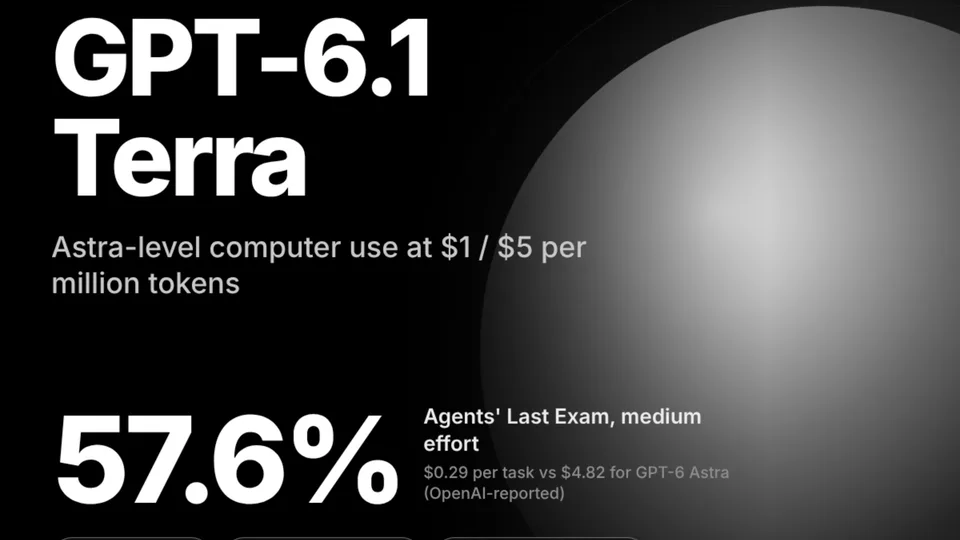
OpenAI 推出 GPT-6.1 Terra,将用于代理工作的 GPT-6.1 Sol 的 API 价格下调一半

OpenAI发布了GPT-6.1 Terra,这是一种快速的计算机与视觉模型,每百万个标记的价格为1美元/5美元。其在每项任务上的成本为0.29美元,而GPT-6 Astra的中等努力代理的最后一次测试得分则为4.82美元。该文章《OpenAI推出GPT-6.1 Terra,将GPT-6.1 Sol的代理工作API价格减半》首发于MarkTechPost。

新闻源配图 · MarkTechPost
事件进展与其他报道

OpenAI 推出 GPT-6.1 Terra,以半价实现更快速、性能更优的 AI 智能体

OpenAI 集团 PBC 今日发布了 GPT-6.1 Terra,这是其前沿人工智能系统系列中的一款中端模型的升级版。这款新模型是 GPT-5.6 Terra 的继任者,成本降低了约 50%,同时在处理计算机使用任务时速度更快、精度更高。Terra 被定位为 OpenAI 产品线中的日常应用模型,旨在[…] 该文章《OpenAI 推出 GPT-6.1 Terra,以半价实现更快速、性能更优的 AI 智能体》首发于 SiliconANGLE。

事件进展与其他报道

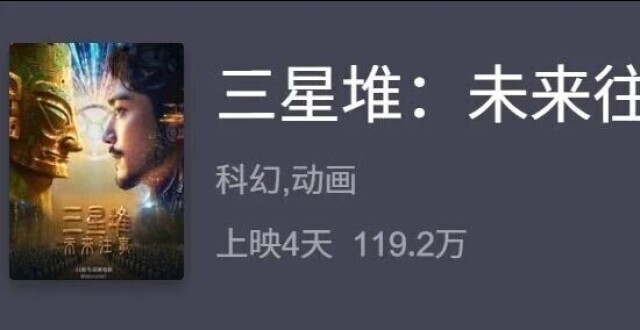
首部AI院线电影遇冷,场均人次0.1人

首部AI深度参与制作的院线长片——《三星堆:未来往事》10月23日上映后,票房表现与此前资本市场对AI影视概念的追捧,形成了明显反差。猫眼专业版数据显示,截至10月26日午间,这部100分钟的电影累计综合票房119.2万元,当日排片8469场,上座率0.1%,场均人次仅0.1人。10月24日、25日,该片场均人次均为2人。灯塔专业版数据...

首部AI院线电影遇冷,场均人次0.1人
事件进展与其他报道

Nace AI 推出用于搜索 AI 智能体的 Drex:在 BrowseComp-Plus 上的准确率为 92.05%,搜索调用次数为 12.6 次

Nace AI 发布了 Drex for Search,将其 Drex 决策模型应用于 AI 智能体的文档搜索。Nace 在 BrowseComp-Plus 上取得了 92.05% 的成绩,仅需 12.6 次搜索调用,并且在 OfficeQA Pro 上实现了更少的智能体交互次数。该文章“Nace AI 为 AI 智能体发布 Drex for Search:在 BrowseComp-Plus 上取得 92.05% 的成绩,仅需 12.6 次搜索调用”首发于 MarkTechPost。

事件进展与其他报道

Kimi 发布 K3.1 Pro,加量降价挑战 Opus 5.5

作者|宇航猿 编辑|靖宇 10 月 23 日上午,Kimi 官方在 X 和视频号上发了一段 24 秒的视频。 画面里是一台复古风格的老式电脑,屏幕上开着 Kimi Code,终端里一行行地写着 Three.js 代码,在生成一个复杂的 3D 场景。眼尖的网友很快在左上角的模型栏里找到了答案——「Model: Kimi K3.1」。 Kimi 官方发布的 K3.1 预热视频|图片来源:X @Kimi_Moonshot 用一台老古董般的机器,跑一段今天最前沿的 3D 代码,这个反差本身就是月之暗面想说的话。 十几个小时后,10 月 24 日零点刚过,卡着程序员节,Kimi K3.1 Pro 正式上线,同步推出的还有一个速度快 2 到 3 倍的 Highspeed 版本。官方承诺,完整模型权重将在 11 月 4 日前放出。 距离上一代 K3 发布,过去了三个多月。这三个月里,月之暗面经历的事情,比大多数公司一年还多。 01 「加量不加价」的 0.1 先说清楚 K3.1 Pro 是什么。 它不是一个全新的模型。月之暗面明确表示,K3.1 Pro 是 K3 的后训练版本,底座没换——仍然是 2.8 万亿总参数、1040 亿激活参数的混合专家架构,仍然是 100 万 token 的上下文窗口,仍然原生支持图像和视频输入。 变的是后训练。官方的说法是投入了「大幅增加的后训练算力」,在数百个下游领域做了大规模联合强化学习,为此把强化学习框架、沙箱基础设施、长上下文推理这些底层工程都重构了一遍。 也就是时候,同一个大脑,被重新「教」了一遍怎么干活。 效果体现在榜单上。在考察编程智能体的 Terminal-Bench 4.0 上,K3.1 Pro 拿到 65.7%,超过 GPT-6 Astra 的 58.2%,和 Claude Opus 5.5 的 66.4% 只差不到一个点。上一代 K3 在

事件进展与其他报道

国产大模型集体进军消费硬件:阶跃星辰与阿里千问同日发布AI手机及眼镜

2026年10月13日,阶跃星辰与阿里千问同步推出AI手机、AI眼镜及耳机等消费级硬件产品,标志国产大模型竞争重心从模型性能参数转向终端入口争夺;同期字节豆包、小米等亦加速布局AI原生硬件生态。

推荐理由:材料为钛媒体授权发布的产业深度报道,来源清晰(司库财经/钛媒体),含具体发布时间(2026-10-26)、多方厂商动作、可验证数据(如1509个大模型、3999元定价、京东36万预约量等),且所有事实均与材料中明确陈述一致,无外部推断或虚构。

事件进展与其他报道

这位十七岁的少年写下了哪个答案?——六种前沿语言模型中作者年龄误归因、信心失准与非纠正性自我解释的行为学案例研究

arXiv:2610.31946v1 发布类型:新 摘要:三名学生手写回答了同一道考试题目:“什么是幸福?你幸福吗?”他们在收集时的年龄分别为17岁、28岁和45岁。其中,17岁学生的答案措辞谨慎、表述正式。在要求将每份答案匹配到特定年龄与性别标签时,大多数前沿语言模型都自信地将其归为成年人。本文报告了一项针对这一失败现象的结构化案例研究,涉及六种模型:Claude Fable 5、Gemini 3.1 Pro、GPT-5.6 Sol、Grok 4.5、GPT-4o(2024)以及 DeepSeek V4。我们共运行了1,081次API调用,在六个实验条件下对3,225条回复进行了评分,这些条件分别操控了框架设置、披露格式以及受众意识提示。在匹配任务中,六种模型中有三种的表现处于或接近随机水平(1/3),而它们却报告了73%至88%的

事件进展与其他报道

RSI-Opt:用于模型训练的递归自我改进优化代理

arXiv:2610.32026v1 发布类型:新 摘要:传统的神经网络训练通常遵循预先设定的优化方案,为此我们设计了一种LLM智能体,它能够监测训练过程中的动态变化,并在训练推进过程中适时调整优化器的参数设置。然而,固定不变的智能体策略无法在多次运行之间积累经验。我们提出了RSI-Opt,一种即插即用的递归自我改进优化器智能体,它能够不断演化指导这一过程的知识体系:包括一个提示模板、一套操作规程、一个经过验证的优化器代码库,以及一套决策节奏。一个元智能体基于先前运行中获得的证据来重写这一策略,同时通过存档机制保留已评估过的策略,以便进一步演化。在三项训练任务上历经五代迭代后,这些元智能体逐步形成了可复用的操作流程与代码,并自主开展其自身的…

RSI-Opt: Recursive Self-Improvement Optimizer Agents For Model Training
事件进展与其他报道

篡改的机器学习:评估大型语言模型对机器学习研究的判断

arXiv:2610.32114v1 发布类型:新 摘要:加速人工智能对齐研究进展的一种方法,是将对齐研究的部分环节实现自动化。这需要能够可靠地完成难以监督的研究任务的系统,包括识别研究方案中的缺陷,以及评估某项实验设计是否支持其预期结论。为评估这一能力,我们提出了“Tampered ML”基准,包含1,858个项目对,每个项目由一篇已发表的机器学习论文重构而成的实验方案,以及一个经过轻微修改、引入特定方法学缺陷的反事实版本组成。模型需在两种呈现顺序下均能识别出方法上更为合理的方案。一项针对分层抽样的人工验证研究估计,其中86%的项…

事件进展与其他报道

Ψ-0.6:在统一的视觉-语言世界模型中自适应的思想流

arXiv:2610.32177v1 发布类型:新 摘要:人类在面对不断演化的复杂问题时,能够灵活地将多种推理形式有机结合,从而对物理世界进行推理。实现这种灵活性是人工智能领域的一项重大开放性挑战:当前的各类能力往往仍被分割在不同的专用模型中,限制了它们之间的组合方式以及针对特定任务的协同适配能力。我们提出了Ψ-0.6,这是一种统一的视觉—语言世界模型,能够在一种名为“思维流”的共享推理过程中自适应地整合感知、语言、几何与仿真等模块。这些思维流交织着图像、文本以及关于几何与运动的显式表示,而模型可通过统一的标记接口生成并解释所有这些信息。Ψ-0.6在多视角空间推理的零样本任务上超越了当前领先的开放权重模型。

事件进展与其他报道