
在 NVIDIA DGX Spark 上提升 MoE 推理的三种方法
更快地生成令牌,首先要明确哪些因素限制了推理性能。在 NVIDIA 上对 Inclusion AI 的 Ling-3.0-flash 进行的单批次评估中……
检索标题、摘要与正文,把分散的信息连起来。
更快地生成令牌,首先要明确哪些因素限制了推理性能。在 NVIDIA 上对 Inclusion AI 的 Ling-3.0-flash 进行的单批次评估中……
旧榜跑分逼近满分,新榜实战却集体不及格。当大模型评测本身变成生意,企业选型正从看排名转向算成本账。
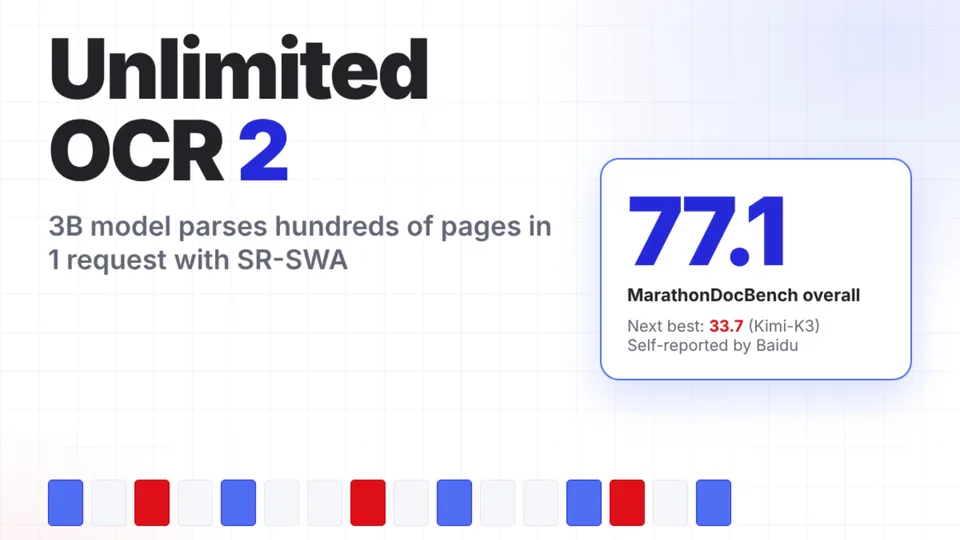
百度发布了 Unlimited OCR 2,这是一款采用 MIT 许可证的 3B 参数规模的 OCR 模型,能够在一次请求中解析百页文档。其 SR-SWA 注意力机制使每步解码开销几乎保持不变,在 MarathonDocBench 上取得了 77.1 的得分。该文章《百度开源 Unlimited OCR 2,用于百页文档解析》首发于 MarkTechPost。
arXiv:2610.33014v1 发布类型:新 提要:谈判助手无需准确预测对方的反应,也能达成一笔不错的交易。我们探讨的是,针对社会世界模型的评估是否直接检验了这种预测能力。我们对1999年至2026年间发表的113篇相关研究进行了梳理。其中9项主要评估测量的是,当系统或实验者选定某一行动后,真实个体对该行动的反应。仅有2项还把明确的反应预测与实际反应进行了对比。这些研究的预测模型所使用的信息仅限于行动被选定之时,而用于评估的反应数据在拟合过程中已被排除;且两项研究均对干预措施进行了随机化处理。此外,我们对25篇有关语言模型的研究进行了全文核查,未发现任何一项实验同时满足上述条件。其余评估则侧重于当前状态推断、任务成功率或预测准确性等指标。
arXiv:2610.33004v1 发布类型:新 提要:光学字符识别(OCR)对于历史档案的数字化至关重要,然而诸如字符错误率(CER)等标准评估指标并不一定能反映诸如姓名、日期和标识符等重要信息是否得以保留。在本研究中,我们从实体层面分析OCR错误,以此作为评估历史文献中OCR质量的补充视角。我们使用了一个公开的基准数据集,包含来自Berrutti档案馆的175份文档,并辅以5,209个经人工标注的实体提及——这些标注将在论文被接收后公布——对序列识别型OCR系统、专为OCR设计的视觉-语言模型以及通用视觉-语言模型进行了比较。除了全局转录准确率之外
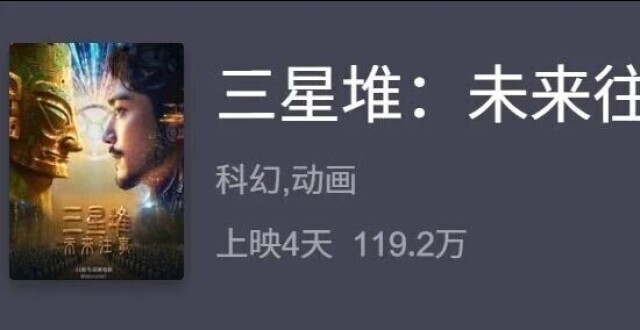
首部AI深度参与制作的院线长片——《三星堆:未来往事》10月23日上映后,票房表现与此前资本市场对AI影视概念的追捧,形成了明显反差。猫眼专业版数据显示,截至10月26日午间,这部100分钟的电影累计综合票房119.2万元,当日排片8469场,上座率0.1%,场均人次仅0.1人。10月24日、25日,该片场均人次均为2人。灯塔专业版数据...
Data Culture 构建了一个三步评估框架,使某项 AI 分析的部署准确率从 0% 提升至 94.7%。
Nace AI 发布了 Drex for Search,将其 Drex 决策模型应用于 AI 智能体的文档搜索。Nace 在 BrowseComp-Plus 上取得了 92.05% 的成绩,仅需 12.6 次搜索调用,并且在 OfficeQA Pro 上实现了更少的智能体交互次数。该文章“Nace AI 为 AI 智能体发布 Drex for Search:在 BrowseComp-Plus 上取得 92.05% 的成绩,仅需 12.6 次搜索调用”首发于 MarkTechPost。
作者|宇航猿 编辑|靖宇 10 月 23 日上午,Kimi 官方在 X 和视频号上发了一段 24 秒的视频。 画面里是一台复古风格的老式电脑,屏幕上开着 Kimi Code,终端里一行行地写着 Three.js 代码,在生成一个复杂的 3D 场景。眼尖的网友很快在左上角的模型栏里找到了答案——「Model: Kimi K3.1」。 Kimi 官方发布的 K3.1 预热视频|图片来源:X @Kimi_Moonshot 用一台老古董般的机器,跑一段今天最前沿的 3D 代码,这个反差本身就是月之暗面想说的话。 十几个小时后,10 月 24 日零点刚过,卡着程序员节,Kimi K3.1 Pro 正式上线,同步推出的还有一个速度快 2 到 3 倍的 Highspeed 版本。官方承诺,完整模型权重将在 11 月 4 日前放出。 距离上一代 K3 发布,过去了三个多月。这三个月里,月之暗面经历的事情,比大多数公司一年还多。 01 「加量不加价」的 0.1 先说清楚 K3.1 Pro 是什么。 它不是一个全新的模型。月之暗面明确表示,K3.1 Pro 是 K3 的后训练版本,底座没换——仍然是 2.8 万亿总参数、1040 亿激活参数的混合专家架构,仍然是 100 万 token 的上下文窗口,仍然原生支持图像和视频输入。 变的是后训练。官方的说法是投入了「大幅增加的后训练算力」,在数百个下游领域做了大规模联合强化学习,为此把强化学习框架、沙箱基础设施、长上下文推理这些底层工程都重构了一遍。 也就是时候,同一个大脑,被重新「教」了一遍怎么干活。 效果体现在榜单上。在考察编程智能体的 Terminal-Bench 4.0 上,K3.1 Pro 拿到 65.7%,超过 GPT-6 Astra 的 58.2%,和 Claude Opus 5.5 的 66.4% 只差不到一个点。上一代 K3 在
2026年10月26日,arXiv发布论文arXiv:2610.31838v1,提出Sense-Aligned Grounding Evaluation(SAGE)——一个统一的10候选图像选择基准,并配套训练无关的Gloss-Augmented Reasoning(GAR)框架,用于跨名词、动词和实体中心的多模态接地评估。

推荐理由:该研究首次将VWSD、VerSe和WikiDiverse三类任务统一为术语中心的接地评测协议,引入混淆难负样本与上下文交换诊断机制,并通过实证表明定义增强与约束引导推理的协同可显著提升Hits@1指标(65.90→71.22),为多模态语义对齐提供了更细粒度、可解释的评估新范式。
2026年10月24日,研究者在arXiv发布论文arXiv:2610.30162v1,提出FusionEval——首个专用于评估大语言模型融合方法的统一基准,覆盖推理链长度、工具调用等薄弱环节,并支持训练型与免训练型融合方法对比。

推荐理由:该基准填补了现有评测对长链推理与工具使用覆盖不足的空白,明确区分平均性能与最差能力保留,提供可复现的专家池(基于Qwen3/Llama)、多维指标(含GPU内存与运行时)及开源代码,具强实践指导性。
2026年10月24日,arXiv发布论文arXiv:2610.30970v1,系统评估参数量介于1700万至10亿之间的紧凑编码器在闭合集决策任务(如工具选择)中的设计选择:联合阅读所有选项 vs. 逐个独立评分。研究发现,在3200万参数规模下,逐选项评分在技能指标上显著优于联合评分;但其计算开销更高、延迟更不均衡。多个System1-Arena基准测试显示,6800万和1.5亿参数的联合编码器超越4.35亿参数DeBERTa-v3零样本分类器。
推荐理由:该论文提供了当前大模型下游决策模块轻量化设计的关键实证比较,涵盖架构选择、初始化依赖、延迟-精度权衡及输入顺序鲁棒性等工程关切点,数据基于三随机种子实验与公开/私有基准验证,发布时间(2026-10-24)与当前UTC日期(2026-10-25)一致,属最新可信研究进展。
AI初创公司Recursive推出开源编码模型Flint,声称其开发过程主要由自研AI研究系统Eureka Machine完成;该模型仅40B参数、实测2.5B激活,可在普通笔记本(如M4 Pro MacBook)离线运行,推理速度达131 token/s,SWE-Bench等基准测试中表现优于多数同规模模型。
NVIDIA推出预训练关系型基础模型Kumo Relational,可直接在企业级关系数据库上执行预测任务(如流失、欺诈、需求预测),无需任务微调、特征工程或表扁平化。在41项跨15个数据库的基准测试中全面超越XGBoost等监督模型,在SAP SALT企业基准上MRR指标领先AutoGluon达8%;支持5000亿行规模数据库,通过Predictive Query Language(PQL)实现零代码预测调用。
IBM研究院提出ALTK-Evolve方法,通过GPT-4.1自动从自身任务轨迹中提炼结构化行为指南(如身份认证、退款确认等),以纯提示工程方式注入ReAct代理系统,在不更新模型权重、不依赖人工标注的前提下,显著提升客服任务的准确率与可靠性;其零售分支以67.5% Pass⁴成绩位列τ²-bench 2026年10月12日榜单第一,超越所有前沿模型及微调系统。
联合王国AISI和EvalEval如何创造基准成果
OpenAI概述了共享全球AI标准的途径,要求协调评价,报告和治理,以改善安全.