跳到正文
AI NEWS JOURNAL
AI, IN PERSPECTIVE

搜索 AI 资讯

检索标题、摘要与正文,把分散的信息连起来。

按发布时间排序

Kimi发布K3.1 Pro:终端任务能力跃居榜首,仿真调试与多模态编程展现具身智能雏形

Kimi于2026年10月25日发布K3.1 Pro模型,在Terminal-Bench 4.0终端任务测试中以67.2%成功率位列第一;其自主修复仿真器错误、完成物理模拟、音频分析、3D场景构建及视频剪辑等多任务能力,指向具身智能技术路径探索。
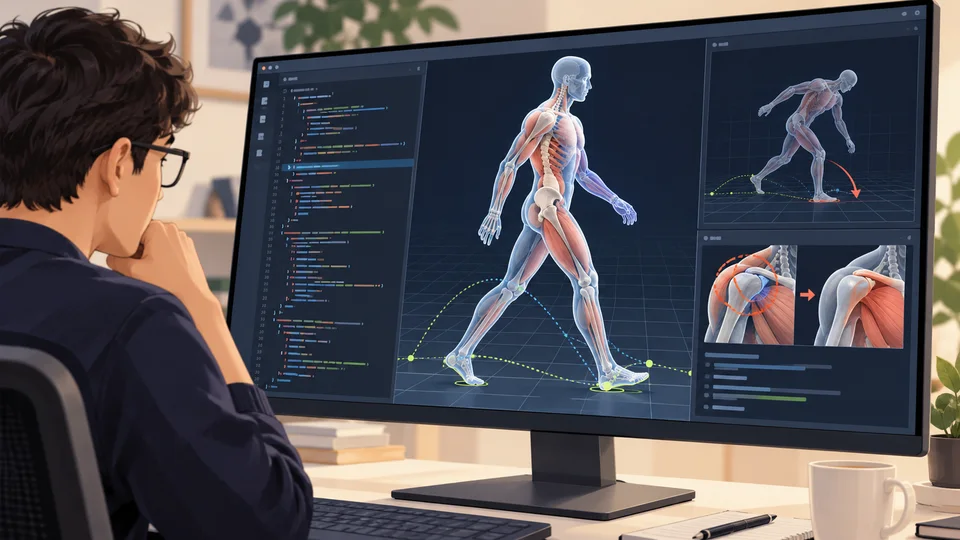
根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

推荐理由:材料基于钛媒体授权发布的实测报告,涵盖权威第三方评测数据(Artificial Analysis、Terminal-Bench 4.0等)、官方自测结果及作者多场景功能验证,聚焦K3.1 Pro在执行能力、仿真闭环、多模态编程上的实质性进步,同时明确标注性能局限与未公开信息(如Flash/Ultra尚未发布),符合事实核查与信源标注要求。

事件进展与其他报道

临床医生主导构建可验证安全守则:为心理健康聊天机器人设置可追溯的守卫层

2026年10月24日,arXiv发布论文arXiv:2610.30690v1,提出一种由两名临床医生主导定义、定稿与裁决的四条安全检查规则库,经形式化验证后作为守卫层应用于心理健康场景下的大语言模型(LLM)输出。该守卫层所有判断均可从一条命名规则和十六个事实复现,旨在提升安全性判断的可解释性与可检验性。

From Clinical Judgment to Checkable Rules: Clinician-Led Guardrails for Mental-Health Chatbots

推荐理由:该研究提供了一种区别于主流prompt工程、LLM-as-a-Judge或Constitutional AI的安全增强路径,其核心创新在于将临床决策结构化、形式化并全程留痕;所有关键主张(如规则数量、验证方式、事实基数、对比实验数据及成本测量)均来自原文明确陈述,且发布时间(2026-10-24)与当前UTC日期(2026-10-25)一致,具备时效性与可信基础。

事件进展与其他报道

SIM-UT:面向医疗分诊聊天机器人的用户行为模拟评估框架

研究者提出SIM-UT(Simulation of User Behaviour for Triage),一种多轮次、基于真实用户行为模拟的评估方法,用于识别大语言模型(LLM)驱动的医疗分诊聊天机器人在低收入和中等收入国家(LMICs)实际场景中的生态有效失败模式。

SIM-UT: A User Simulation based Evaluation Framework for Medical Triage Chatbots

推荐理由:该框架突破了现有单轮次、英语为主的评测局限,通过5000+轮多语种模拟对话,覆盖印度、南非、肯尼亚三地真实WhatsApp健康项目,首次系统揭示‘临床危险性降级’(de-escalation risk)这一关键失效行为,具有方法论创新性与临床安全警示价值。

事件进展与其他报道

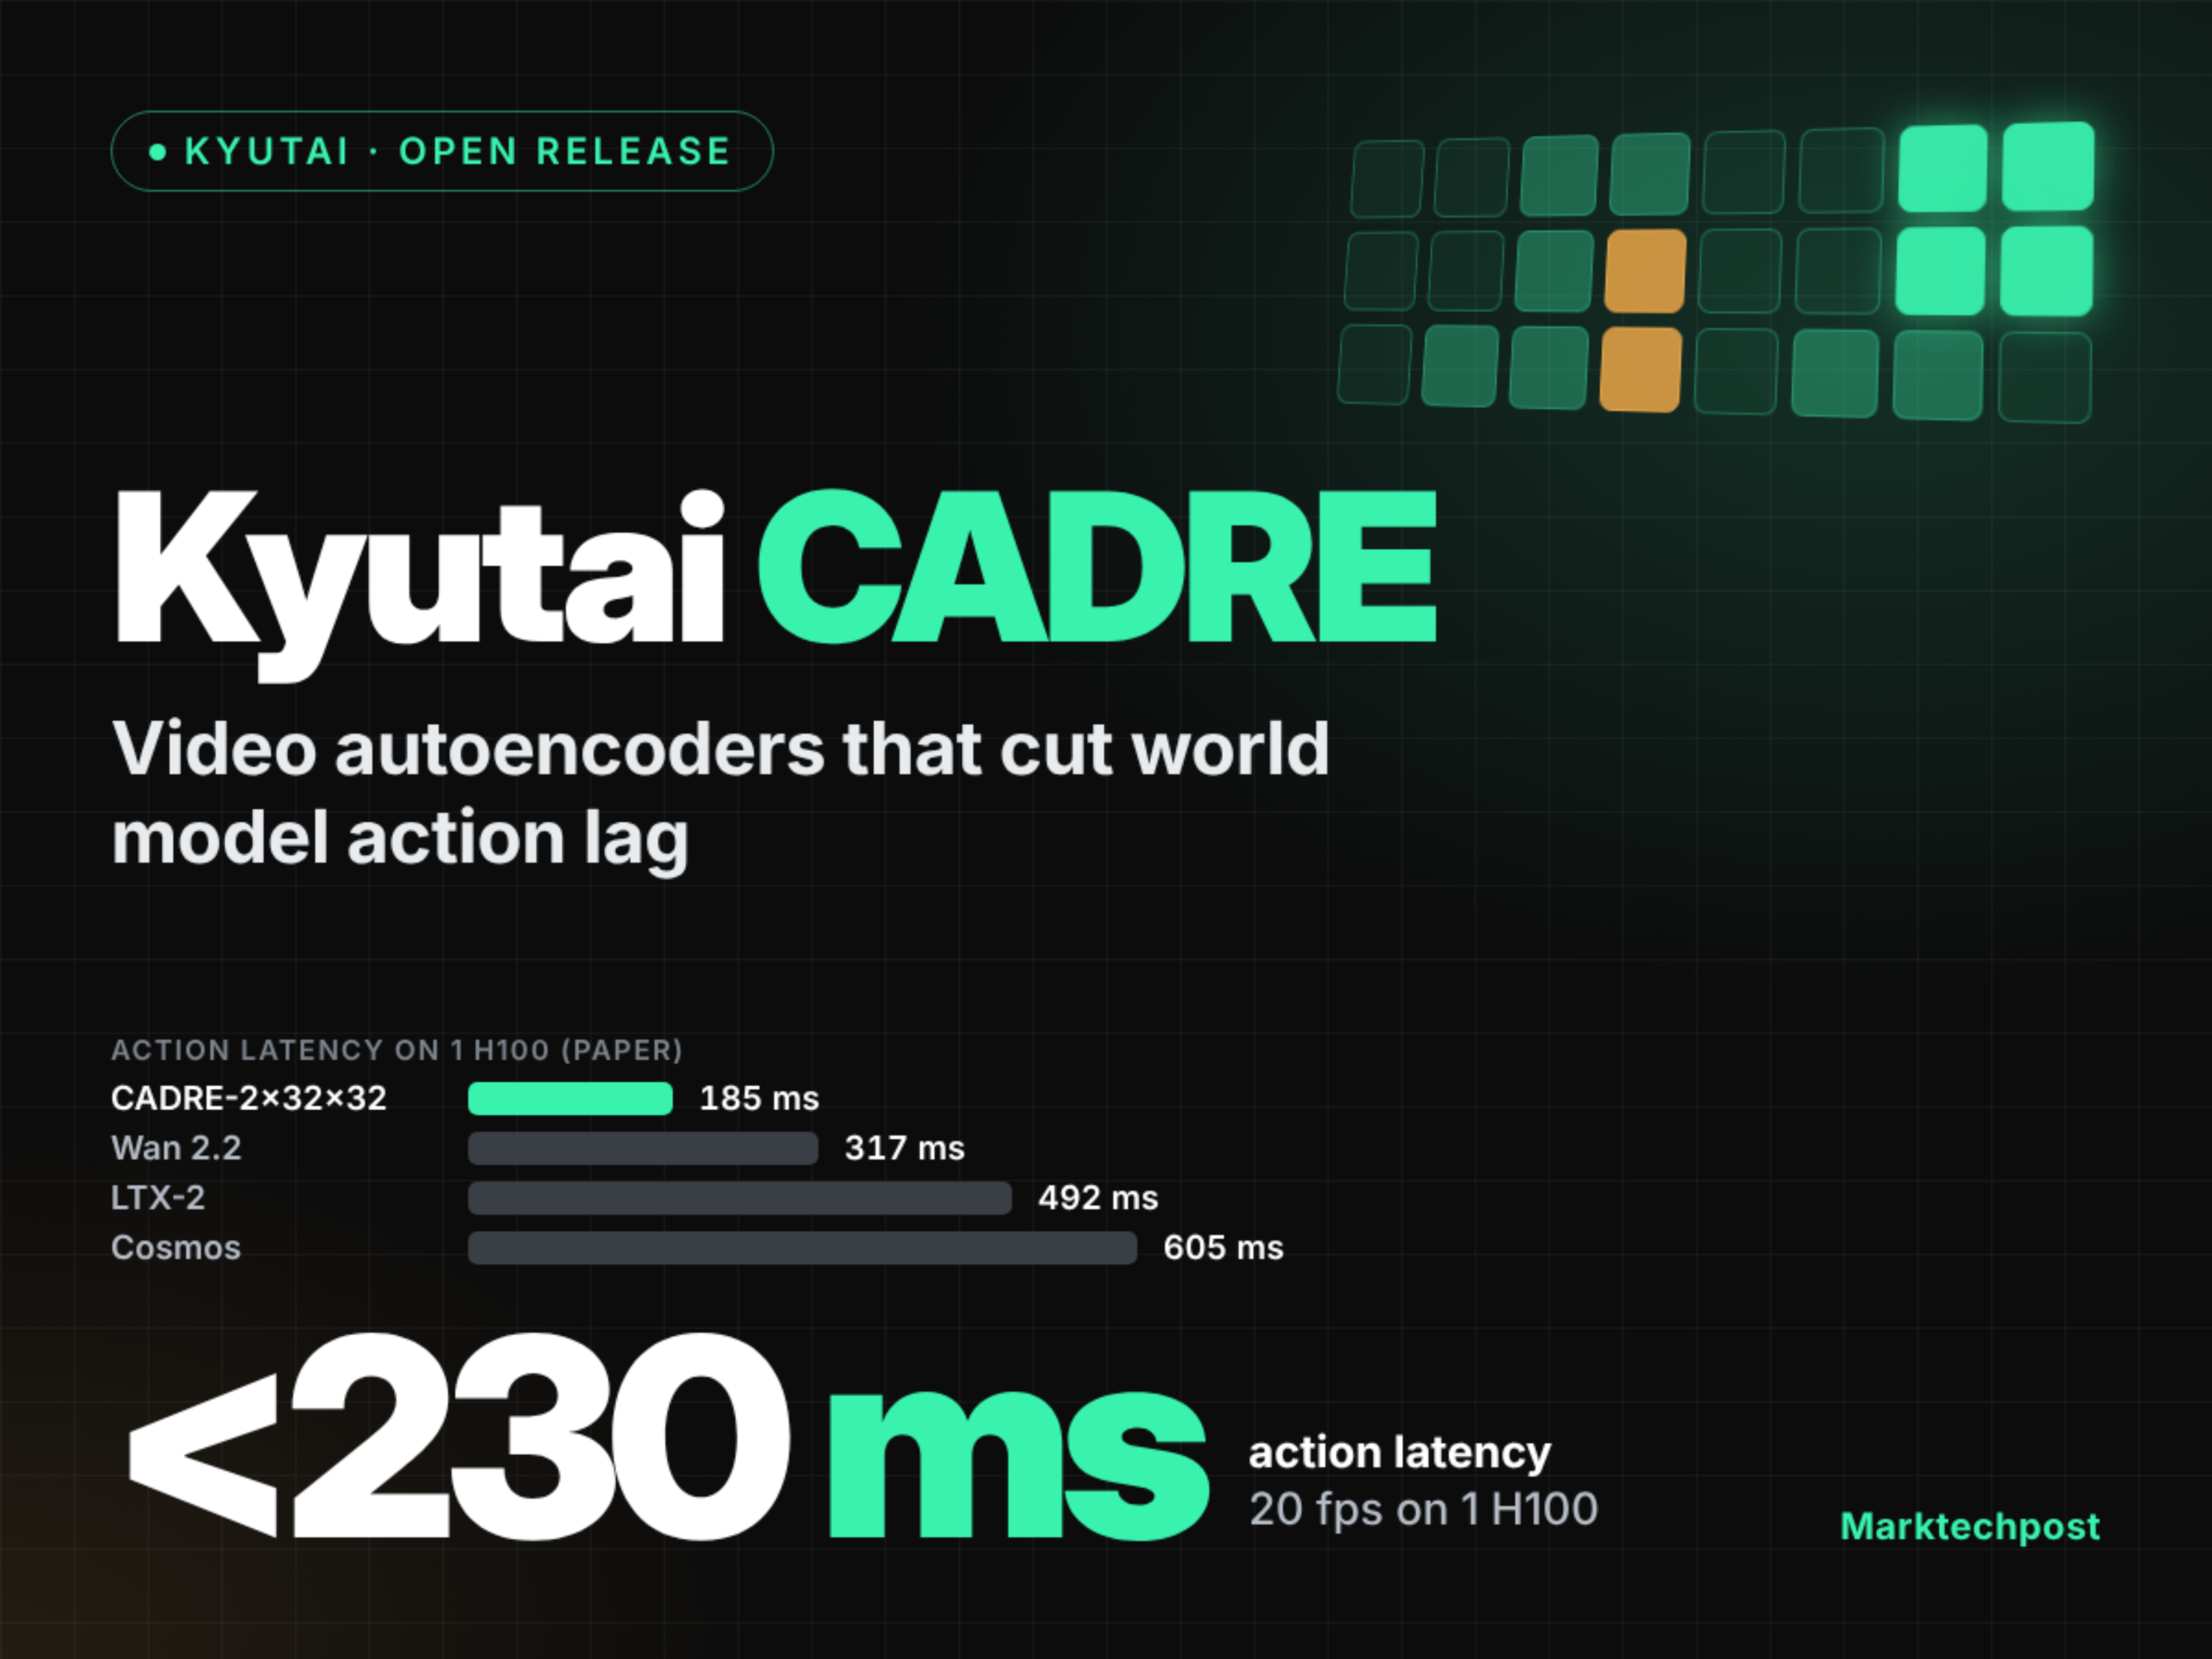
Kyutai发布CADRE视频自编码器家族:面向交互式世界模型,端到端动作延迟压至230毫秒以下

Kyutai于2026年10月23日公开CADRE——一套含7个开源因果扩散式视频自编码器的模型家族,专为降低世界模型的动作延迟而设计;在单张H100 GPU上实测反应延迟低至185 ms,推理达23.4 fps,驱动场景FVD指标降至162.6(Wan 2.2为599.7),但机器人操作任务中动作跟随率(ARR)弱于Wan 2.2与Cosmos。

Kyutai CADRE: Video Autoencoders That Cut World Model Lag Below 230 ms
事件进展与其他报道