
在 NVIDIA DGX Spark 上提升 MoE 推理的三种方法
更快地生成令牌,首先要明确哪些因素限制了推理性能。在 NVIDIA 上对 Inclusion AI 的 Ling-3.0-flash 进行的单批次评估中……
保留完整资讯流,用来源、主题和时间找到你关心的消息。
更快地生成令牌,首先要明确哪些因素限制了推理性能。在 NVIDIA 上对 Inclusion AI 的 Ling-3.0-flash 进行的单批次评估中……
K3.1 Pro发布之后,由于多位用户反馈额度烧得太快,月之暗面紧急发布公告,称“问题出在我们,我们也本应更早修复”,在补偿额度的同时,月之暗面也表示将“减少不必要的子Agent调用和输出长度”。就在模型上线前两天,Anthropic发了一篇文章,标题为《构建Agent:何时该把子Agent折叠回主循环》(Building agents: When to fold subagents into your main agent loop),它所讲的,刚好就是关于子Agent这件事。Anthropic的结论是,通过对比多家企业部署的Claude他们发现,一个带技能的Agent,质量反而胜过了“一群...
作者:Evin 编辑:刘致呈 审核:徐徐 出品:互联网江湖 这阵子,Meta AI智能体Muse,火了。 火到什么程度? 美国下载破千万,....
Mirendil 发布了 Fern 0.1,这是其首款模型,从零开始预训练,拥有 1000 万标记的上下文窗口。该模型面向智能体 AI 研发工作,在 1000 万标记的 RULER 单针测试中取得了 100% 的得分,但在智能体驱动的代码生成方面仍落后于前沿模型。文章《Mirendil 推出 Fern 0.1,首款拥有 1000 万标记上下文的模型》首发于 MarkTechPost。
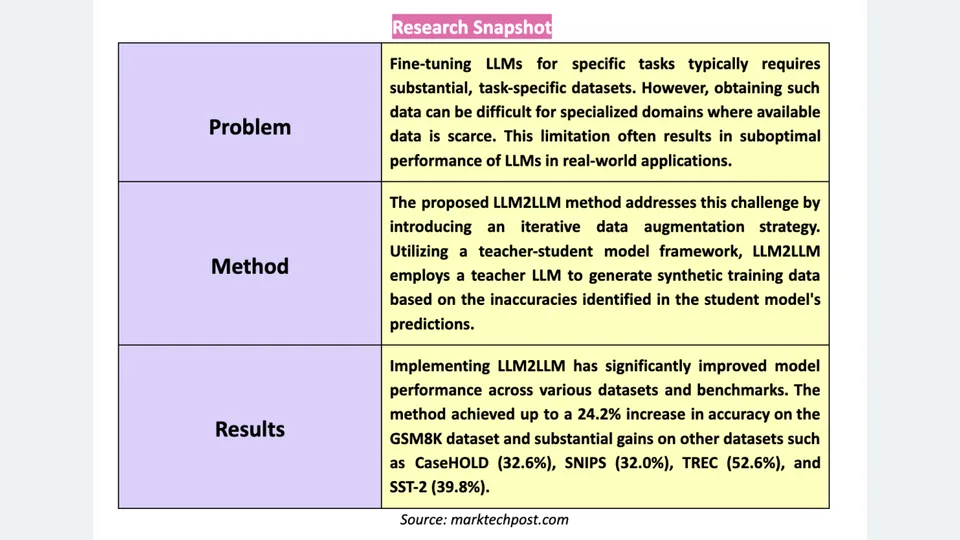
1.更适合打工人的GPT-6.1 Terra上线,API价格减半,电脑操作更快 10月26日,OpenAI发布GPT-6.1 Terra,重点提升视觉理解、电脑操作、事实准确性和编程能力,....
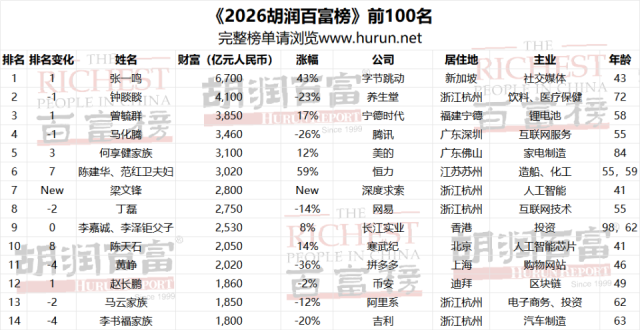
旧榜跑分逼近满分,新榜实战却集体不及格。当大模型评测本身变成生意,企业选型正从看排名转向算成本账。
旧有的“赛马+短周期考核”方式,已经难以为继。
闫德利 腾讯公司资深专家LLM是概率模型,不知因果大语言模型(LLM)并不理解语言,只是在预测下一个token(Next Token Prediction)。它是一个枯燥的“文字接龙”机器,走一步,算一步,不走回头路。LLM在本质上是概率模型,在统计共现结构里学习“什么经常和什么一起出现”,输出的是“通常如此”,不理解“为什么如此”,...
AI排行榜上的冠军会换,用户每天使用的产品却未必换。大模型的下一场竞争,不仅仅是谁的模型更强,而是把一次使用变成习惯。
MiniMax于2026年10月19日发布低价大模型M3.1Flash,综合评测得分42分,成本较前代降70%,但随即遭遇“背题”质疑——其在AA公开旧题上接近满分,改写题干后仍答原答案;猫老板与Binkg等测评者指出其新旧题能力割裂、Token消耗异常、知识测试幻觉率高达92.8%。10月23日MiniMax开源模型权重,供独立复验,但题目识别机制与中英文响应差异原因尚未澄清。
推荐理由:该报道基于多方实测(Binkg改题实验、作者复现、AA与Plotly-Mila双测评对比)、可验证数据(Token量、价格、正确率/幻觉率)及模型行为矛盾点(英文错/中文对、旧题稳/新题崩),系统呈现当前大模型评测可信度危机的核心症候:高分未必等于强泛化,低价优势与能力真实性形成张力。信息源为钛媒体授权发布的深度调查,含原始测试过程、截图佐证与时间戳,时效性与细节密度俱佳。
作者|Cynthia 编辑|郑玄 2026 年的 AI 3D 赛道,正站在一个微妙的分水岭上。 一级市场的热度仍在攀升,新模型、新创业公司层出不穷,单图生 3D 的正面渲染效果几乎已经做到了以假乱真。 但剥开炫目的 Demo 外壳:绝大多数生成结果依然停留在「转台展示」阶段:一个精致的角色或机械模型,在灯光下缓缓旋转,鳞片、衣褶和金属刻纹栩栩如生;可这些细节一旦进入游戏引擎装配、工业仿真以及 3D 打印的真实生产流程就立刻原形毕现:结构断裂、背面崩坏、细节粘连、网格不可编辑等问题开始集中爆发,大量人工修补成本吞噬了 AI 带来的效率红利。 正面视图保真度不等于 3D 质量成为新的行业共识。AI 3D 的竞赛,也从 能不能生成」的上半场,进入了能不能落地的下半场。 也正是在这个节点上,头部玩家 Hi3D 接连落下两枚棋子:正式开源经过生产验证的 Hi3D V1.0 底座,同时推出以创作者为核心的 Hi3D Agent,一头连接产业底层,一头深度扎根进入真实的创作全流程。 在此之前,这家成立不到三年的公司已经交出了一份扎实的成绩单:半年内连续完成两轮融资、总额近 5000 万美元,红杉中国、IDG 资本、美团龙珠等一线机构扎堆下注;旗下 Hi3D 平台覆盖120+ 国家与地区、200 万 + 创作者,与拓竹科技、xTool 等头部设备商深度集成。 从稀疏几何技术的学术突破,到生产级模型的开源开放,再到 Agent 创作系统的全链路打通,Hi3D 已经拿下了通往 3D 生成下半场的门票。 01 3D 生成,被高估的 Demo, 被低估的生产鸿沟 单图生 3D 的底层逻辑,天然带着视角偏见。随着ULIP、Uni3D 等指标被反复刷新,重正面、轻整体,重外观、轻内部逻辑的一度成为这个行业过去几年的共同写照。 但 3D 资产的本质,是可旋转、可编辑、可加工的立体对象。一张角色图片里,垂
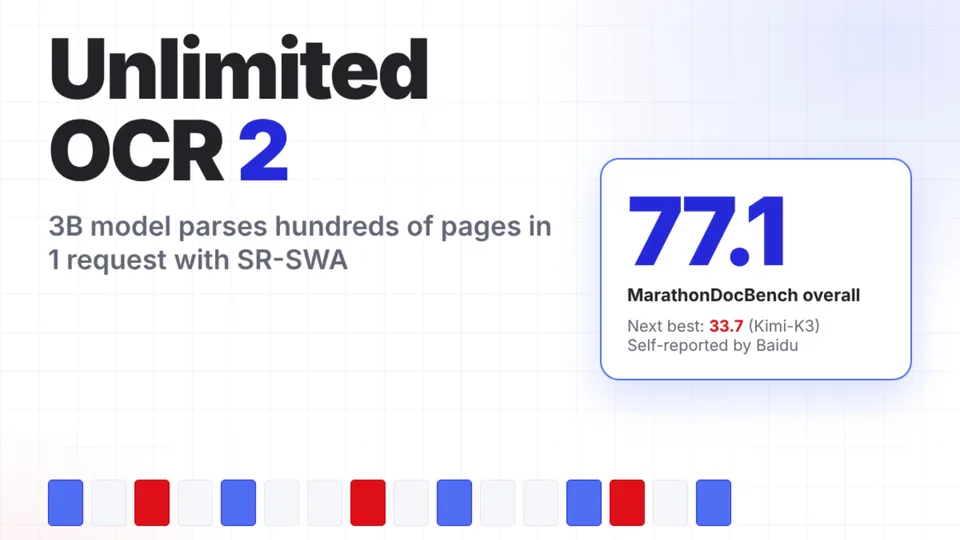
百度发布了 Unlimited OCR 2,这是一款采用 MIT 许可证的 3B 参数规模的 OCR 模型,能够在一次请求中解析百页文档。其 SR-SWA 注意力机制使每步解码开销几乎保持不变,在 MarathonDocBench 上取得了 77.1 的得分。该文章《百度开源 Unlimited OCR 2,用于百页文档解析》首发于 MarkTechPost。
OpenAI 又卷起了大模型的性价比。#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
arXiv:2610.33015v1 发布类型:新 摘要:长期记忆使大型语言模型(LLM)代理能够维持个性化且时间上连贯的交互,但为实现记忆的接纳、提取与组织而反复调用LLM进行推理,会带来显著的成本与延迟。我们提出了SLICE-Mem,一个轻量级的记忆框架,它将基于显著性引导的接纳与基于谓词的信息提取相结合。一个紧凑的分类器用于识别值得保留的用户发言,而基于语义依赖关系的提取器则将被接纳的发言转化为简洁的记忆条目。这一在线处理流程无需调用生成式LLM,同时跨条目的一致性校验被推迟至离线的整合阶段。我们在Memora和LongMemEval-S的每周子集上,使用8B a对SLICE-Mem进行了评估
arXiv:2610.33017v1 发布类型:新 摘要:在以英语为主语料库上训练的多语言分词器往往会对印度语系语言进行过度切分,导致令牌序列更长,并加剧了不同书写系统之间的分词差异。我们提出了 AdaptTok-Indic,这是一种针对印度语系语言的自适应分词扩展方法,它将 Unicode 规范化的预处理与显式的印度语系连字处理、基于书写系统的路由策略,以及与小型 Transformer 语言模型联合训练的字节级边界预测相结合。在孟加拉语和印地语上进行评估,并额外对古吉拉特语、泰米尔语和泰卢固语进行了测试,AdaptTok-Indic 在令牌生成密度方面优于面向印度语系的基准分词器 SentencePiece BPE,以及独立实现的 MAGNET 式基准。在五项已记录的
arXiv:2610.32429v1 发布类型:新 摘要:大型语言模型(LLM)代理正越来越多地以异步方式执行任务:主代理在子代理运行的同时继续工作,而任务状态可能在其结果到达之前就已发生变化。主代理必须决定哪些工作需要更新或保留、哪些检查需要重复,同时避免进行被禁止的修改。仅凭最终任务的成功并不能说明这些结果是否被正确处理,而且自然的异步到达现象也难以复现。我们提出了 Async-RBench,一个用于评估 LLM 代理中异步任务执行的基准测试,包含涵盖八种场景的 200 个可执行任务。场景控制器通过预定义的任务状态条件来调控结果的交付,而事件响应契约(ERC)则规定了每种响应应满足的要求
arXiv:2610.33012v1 发布类型:新 摘要:具备工具调用能力的大型语言模型(LLM)智能体,在从相同初始状态出发的多次独立运行中,表现出行为不一致的现象,例如调用不同的工具、产生相互矛盾的输出,或采取截然不同的策略。这种行为上的波动会随时间累积,从而削弱部署的可靠性。现有的评估指标主要通过基于任务完成度的得分来衡量正确性,而未能捕捉智能体在多次执行中的行为一致性。此外,对智能体行为的分析要么停留在词元层面,借助概率分布进行评估;要么聚焦于单次响应层面,采用语义聚类方法,但两者均无法刻画不一致性如何在轨迹的后续步骤中进一步传播。我们提出了递归语义发散(RSD),一种无
arXiv:2610.33007v1 发布类型:新 摘要:在集成的地面与非地面(TN/NTN)6G网络中,自然语言服务意图可能存在不完整、模糊或不一致的情况,这使得无约束的大型语言模型生成难以实现面向网络的可靠编排。本文提出了一种知识引导的大型语言模型框架,该框架将语法约束的语义解析与知识图谱驱动的澄清循环相结合,从而为四大典型服务类别生成经过验证、可直接用于编排的服务配置文件。在包含200个样本的意图数据集上,该框架实现了89%的分类准确率和95%的策略有效性,且每条请求平均只需0.66次澄清迭代。与纯大型语言模型基线相比,所提出的框架显著提升了策略的有效性及共
arXiv:2610.33039v1 发布类型:新 摘要:我们推出了 Nemotron 3.5 Bolt 74B-A9B 24GB,这是一种混合型 Mamba-Transformer 视觉语言模型,可在本地智能体驱动的工作负载中实现每 GB 内存的处理速度与智能性能的最优平衡。该模型源自 Nemotron 3.5 Super VL 120B-A12B 系列,通过结合 Star Elastic 压缩与 2 位量化感知蒸馏技术,适用于内存受限的部署场景。该模型针对推理、智能体工具调用以及网页与终端交互进行了优化。此外,我们还训练了一款名为 LiLiCorr 的投机式起草器,并随模型一同发布,以达到预期的推理速度。最终得到的模型在多项基准测试中,于相同内存占用和速度条件下,其准确率均高于同类领先模型,适用于通用智能体任务。

arXiv:2610.33014v1 发布类型:新 提要:谈判助手无需准确预测对方的反应,也能达成一笔不错的交易。我们探讨的是,针对社会世界模型的评估是否直接检验了这种预测能力。我们对1999年至2026年间发表的113篇相关研究进行了梳理。其中9项主要评估测量的是,当系统或实验者选定某一行动后,真实个体对该行动的反应。仅有2项还把明确的反应预测与实际反应进行了对比。这些研究的预测模型所使用的信息仅限于行动被选定之时,而用于评估的反应数据在拟合过程中已被排除;且两项研究均对干预措施进行了随机化处理。此外,我们对25篇有关语言模型的研究进行了全文核查,未发现任何一项实验同时满足上述条件。其余评估则侧重于当前状态推断、任务成功率或预测准确性等指标。