
02 / CAPABILITIES
주요 기능
WhisperX의 전사 결과를 바탕으로 의미적으로 연속된 영상 클립을 자동으로 식별하며, 단어 수준까지 정확한 시작 및 종료 타임스탬프를 출력합니다.
Pyannote를 활용하여 화자 디아라이제이션(speaker diarization)을 수행하고, 현재 발화자의 위치를 실시간으로 추적하여 9:16 등 다양한 비율로 지능적으로 프레임을 재조정하고 화면 초점을 맞춥니다.
03 / AUDIENCE & USE CASES
활용 사례와 대상
개발자
- 팟캐스트, 인터뷰, 강연, 설교 등 오디오 중심의 서사형 긴 동영상을 자동으로 여러 개의 짧은 클립으로 편집합니다.
- 16:9 가로형 비디오를 9:16 세로형 포맷으로 지능적으로 재구성하고, 현재 발화자에게 동적으로 초점을 맞춥니다.
- 영상의 텍스트 전사 결과를 기반으로 정보 밀도가 높거나 감정이 두드러지는 구간을 식별하여 2차 배포에 활용
입력
MP4 형식과 같은 긴 동영상 파일
출력
시작 및 종료 타임스탬프가 포함된 여러 개의 영상 클립과, 선택적으로 비율 재조정을 위한 자르기 좌표 시퀀스
자주 묻는 질문
영상 크기 재조정 시 Hugging Face 액세스 토큰이 필요합니까?
네, 영상 크기 재조정을 위해 Hugging Face 액세스 토큰을 제공해야 하며, 이는 Pyannote의 화자 분리(speaker diarization) 작업에 사용됩니다. 해당 서비스는 사용자에게 비용이 부과되지 않습니다.
Clips AI은 상업적 이용을 지원합니까?
원문에는 상용 라이선스 조건이나 제한에 대한 언급이 없으므로, 상업적 이용 범위는 알려져 있지 않습니다.
GETTING STARTED
사용 방법
- 01
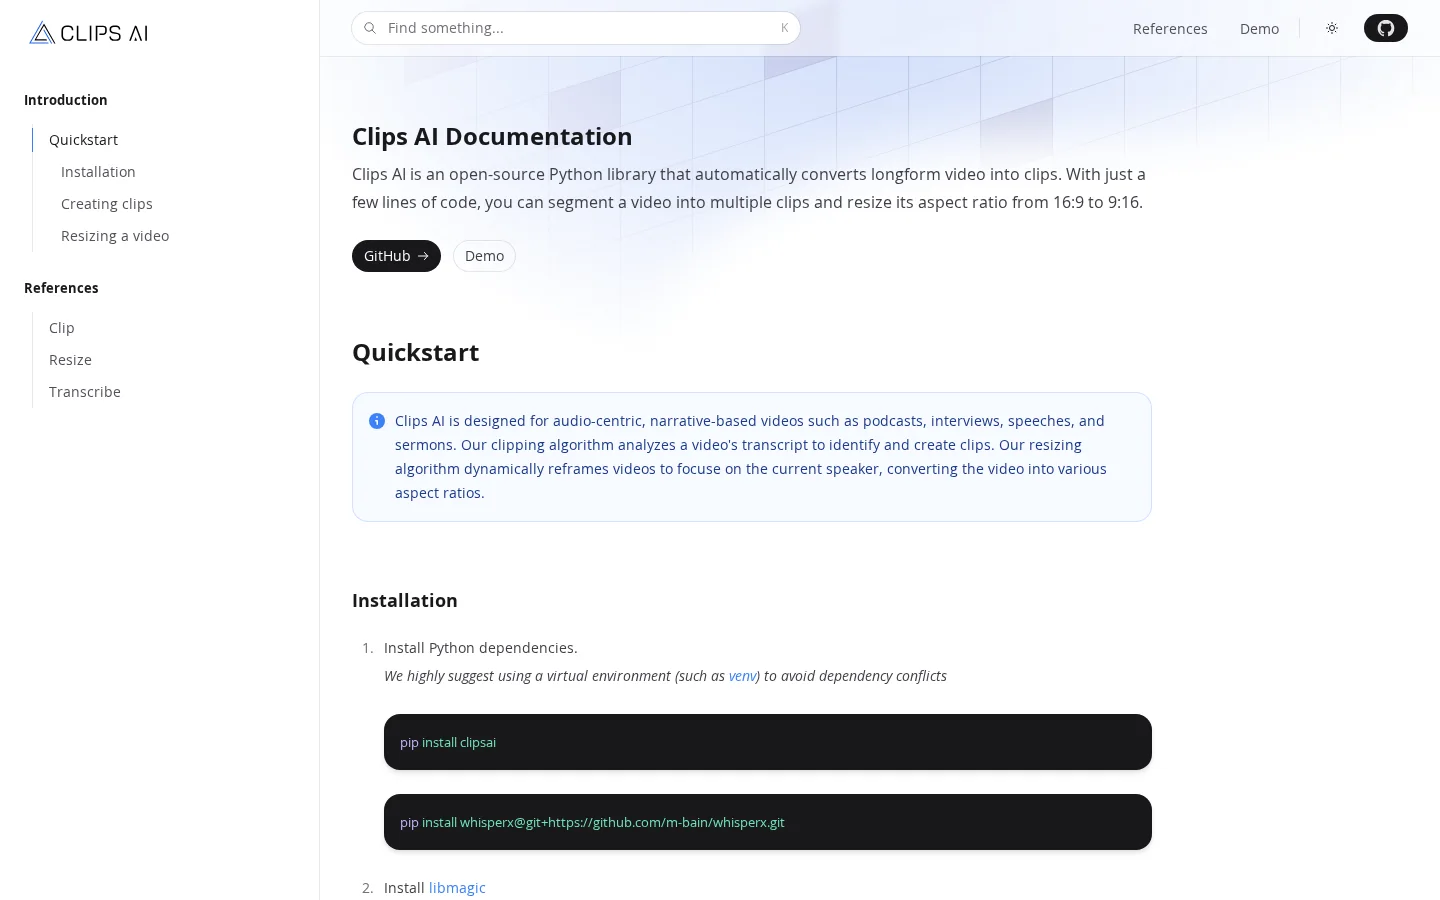
Python 의존성 설치: pip install clipsai
- 02
whisperx 추가 설치: pip install whisperx@git+https://github.com/m-bain/whisperx.git
- 03
Transcriber를 사용해 영상 파일의 음성을 문자로 변환하고, 타임스탬프가 포함된 단어별 원문을 확보합니다
- 04
ClipFinder.find_clips()를 호출하여 전사 결과에서 여러 개의 영상 클립을 자동으로 식별하고 추출합니다
BENEFITS & LIMITS
장점과 제한 사항
장점
- 콘텐츠 마케팅 팀의 시간 절약
- 소셜 미디어 참여도 증가
- 자동 동영상 재사용
- 맞춤형 Python 라이브러리 제공
- 오디오 중심, 스토리텔링형 영상 지원
제한 사항
- 라이브러리를 사용하려면 Python 지식이 필요합니다
- 크기 조정을 위해서는 Hugging Face 액세스 토큰이 필요합니다
- 편집 인식은 정확한 문자 변환 텍스트에 의존합니다
- WhisperX 및 ffmpeg 등과 같은 종속성의 설치가 필요합니다.
SOURCES
공식 웹사이트 및 출처
자료 업데이트 2026-10-30
RELATED COLLECTIONS
관련 주제
NEWS REPORTS
