본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

스탠퍼드 대학과 UC 버클리 대학의 연구진이 TokenGate를 발표했습니다: 토큰 기반 접근 제한 주의 메커니즘을 통해 장문 컨텍스트 사전 채우기가 최대 11.3배 더 빨라집니다.

스탠퍼드 대학교와 캘리포니아 대학교 버클리 캠퍼스의 연구진은 기존 대규모 언어 모델(LLM)에 적용 가능한 플러그 앤 플레이 방식의 학습형 토큰 가위 모듈인 TokenGate를 제안했습니다. 이 방법은 정확도를 유지하면서, 긴 컨텍스트를 사전 채워 넣는 첫 글자 생성 시간(TTFT)을 1.4배에서 최대 11.3배까지 가속화하고, 최대 메모리 사용량을 1.5배에서 최대 3.4배까지 절감합니다. 관련 코드와 체크포인트는 오픈소스로 공개되었습니다.

Researchers from Stanford and UC Berkeley Introduce TokenGate: Token-Gated Attention Makes Long-Context Prefill Up to 11.3x Faster
진행 상황 및 관련 보도

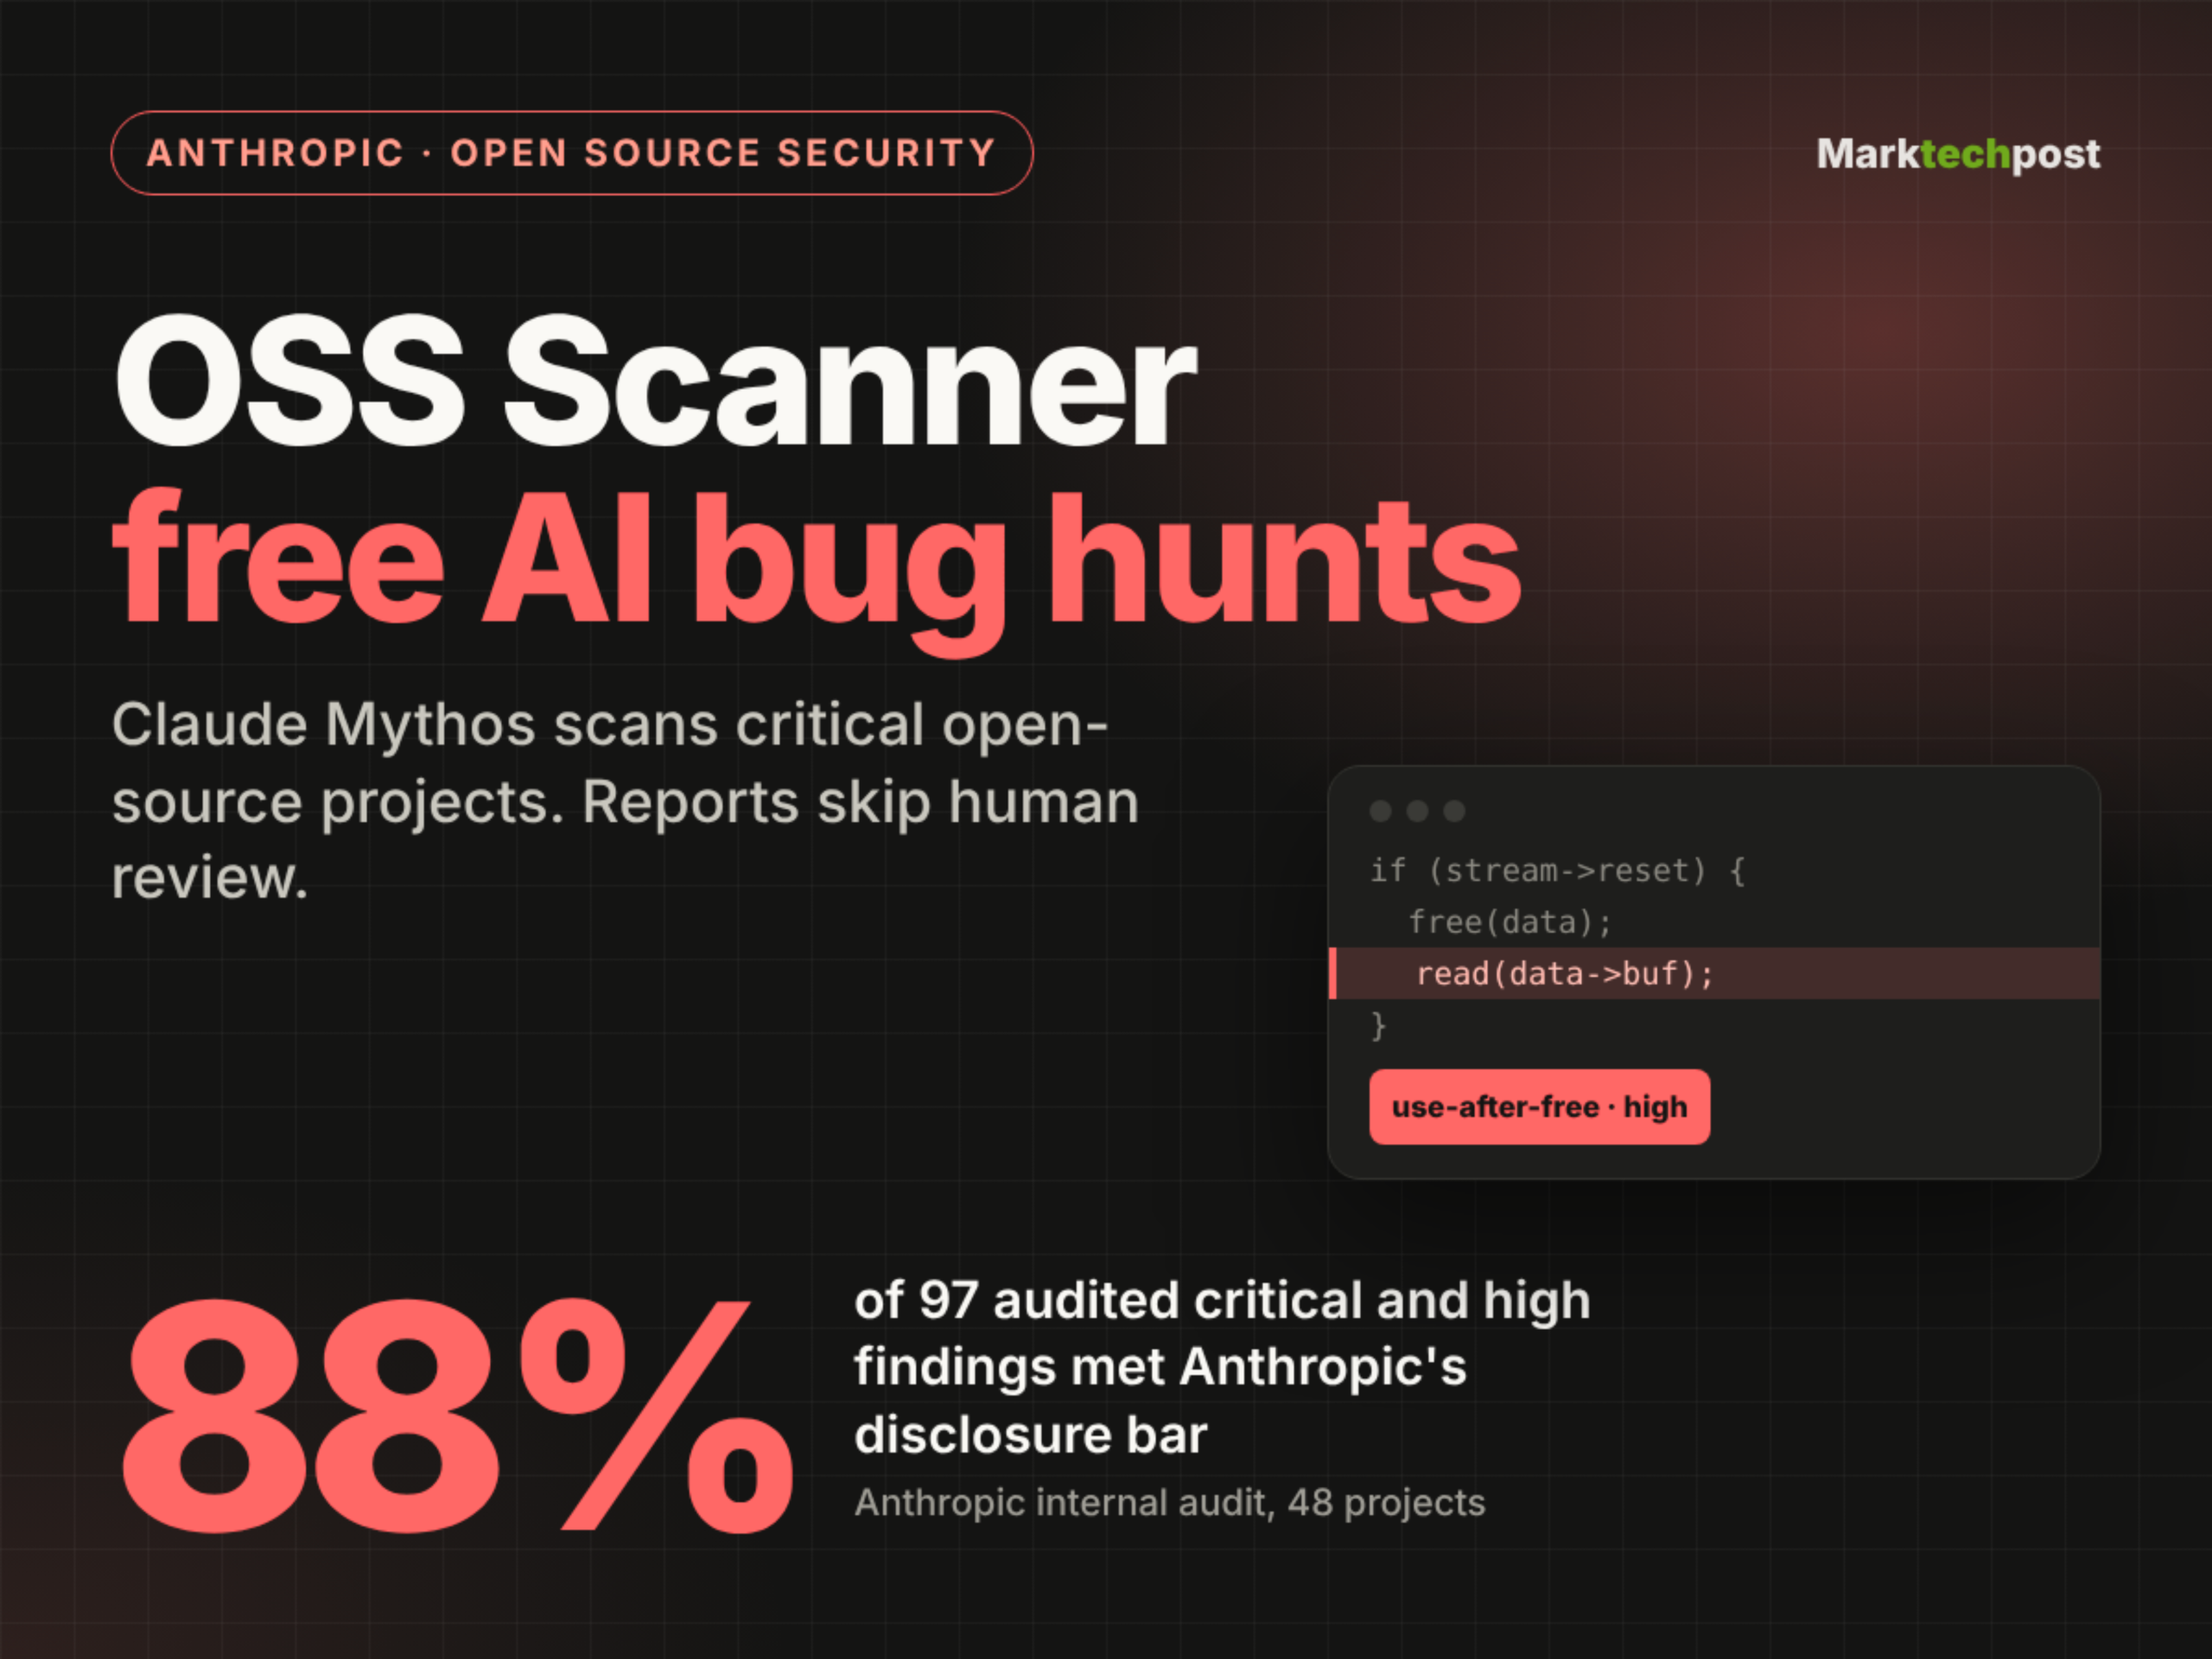
Anthropic이 주요 오픈소스 프로젝트를 대상으로 하는 무료 AI 취약점 스캐너 OSS Scanner를 출시했습니다.

Anthropic은 2026년 10월 8일, Claude Mythos 등 강력한 모델을 기반으로 한 무료이며 선택적 가입형 AI 취약점 스캐너인 OSS Scanner를 출시했으며, 이는 핵심 오픈소스 프로젝트를 위해 특별히 설계되었습니다. 10월 19일 현재, 총 114개의 프로젝트가 접수되었고, 11일 만에 심각 등급 취약점 77건과 고위험 등급 취약점 803건(모델 평가 기준)이 보고되었으며, 표본 검사 결과의 88%가 자사의 공개 기준을 충족했습니다.

Anthropic Launches OSS Scanner, a Free AI Vulnerability Scanner

추천 이유:이 도구는 오픈소스 보안 분야에서 LLM의 대규모 적용 사례를 대표하며, 무비용·전자동·오프라인 감사를 특징으로 하지만, 인력 검토 단계를 생략함으로써 오보와 중복 문제 발생 위험을 초래합니다. 그 정확도 데이터(유효율 88%, 거짓양성률 1%)와 실제 프로젝트 피드백(예: wolfSSL, curl)은 현재 AI 기반 취약점 탐지 능력에 대한 실증적 기준을 제공합니다.

진행 상황 및 관련 보도

Kimi, K3.1 Pro 출시: 엔드포인트 작업 능력이 최고 수준으로 도약했으며, 시뮬레이션 디버깅과 다중 모달 프로그래밍을 통해 몸을 가진 지능의 초기 모습을 보여줍니다

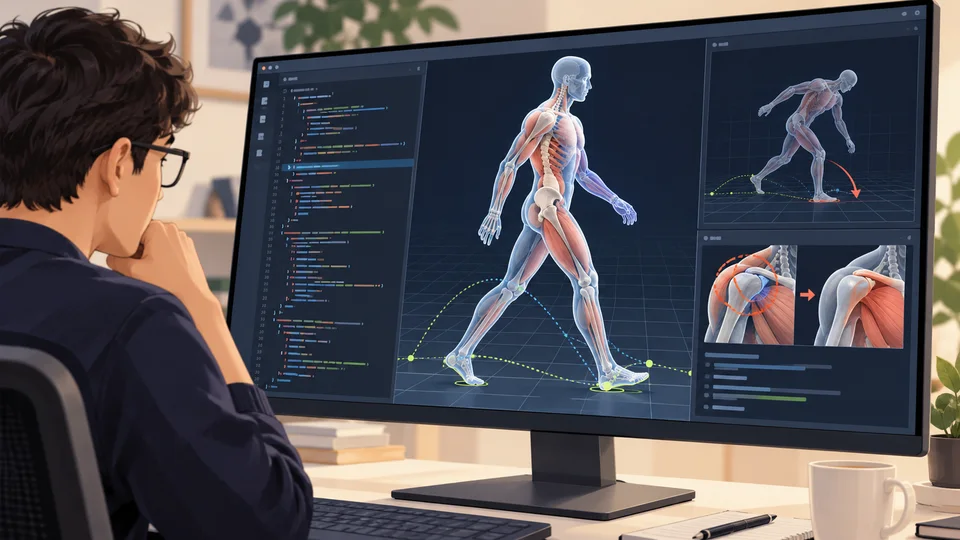
Kimi는 2026년 10월 25일 K3.1 Pro 모델을 출시했으며, Terminal-Bench 4.0 터미널 작업 테스트에서 67.2%의 성공률로 1위를 차지했습니다. 또한 자체적으로 에뮬레이터 오류를 복구하고 물리 시뮬레이션, 오디오 분석, 3D 장면 구축 및 영상 편집 등 다중 작업을 수행하는 능력을 갖추고 있어, 신체 기반 지능 기술의 발전 경로를 탐구하고 있음을 보여줍니다.

根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

추천 이유:본 자료는 티미디어의 공식 라이선스를 받아 발표된 실측 보고서를 기반으로 하며, Artificial Analysis, Terminal-Bench 4.0 등 권위 있는 제3자 평가 데이터와 공식 자체 테스트 결과, 그리고 필자의 다중 시나리오 기능 검증을 포괄합니다. 특히 K3.1 Pro의 실행 성능, 시뮬레이션 클로즈드 루프, 다중 모달 프로그래밍 분야에서의 실질적 진전에 초점을 맞추고 있으며, 동시에 Flash/Ultra가 아직 출시되지 않았다는 점 등 성능상의 한계와 미공개 정보를 명확히 표기하여 사실 확인과 출처 표기 요건을 준수하고 있습니다.

진행 상황 및 관련 보도

4분의 1 PR은 “AI 스팸”이다! 리눅스 재단이 새로운 보고서를 발표했다: AI가 코드 작성 속도를 52% 높였지만, 오픈소스 유지보수자는 오히려 더 힘들어졌다

리눅스 재단은 10월 20일 발표한 보고서에서 생성형 AI가 코드 작성에 소요되는 시간을 평균 52% 단축시켰지만, 오픈소스 프로젝트 유지관리자들은 풀 리퀘스트의 약 25%가 저품질의 ‘AI 슬롭’에 해당한다고 추정했다고 밝혔다. 대규모 프로젝트에서는 이 비율이 31%로 상승했다. 보고서는 효율성 향상의 혜택이 검토 및 거버넌스 비용 감소로까지 동반되지 않았음을 지적하며, 정식 AI 기여 정책을 마련한 프로젝트는 전체의 35%에 불과하고, 유지관리자들의 피로감과 신뢰 부족 문제가 두드러지고 있다고 강조했다.

진행 상황 및 관련 보도

마이크로소프트가 Agensh를 오픈소스로 공개: 1024개의 자율 협업 AI 코딩 에이전트를 지원하는 분산형 프레임워크

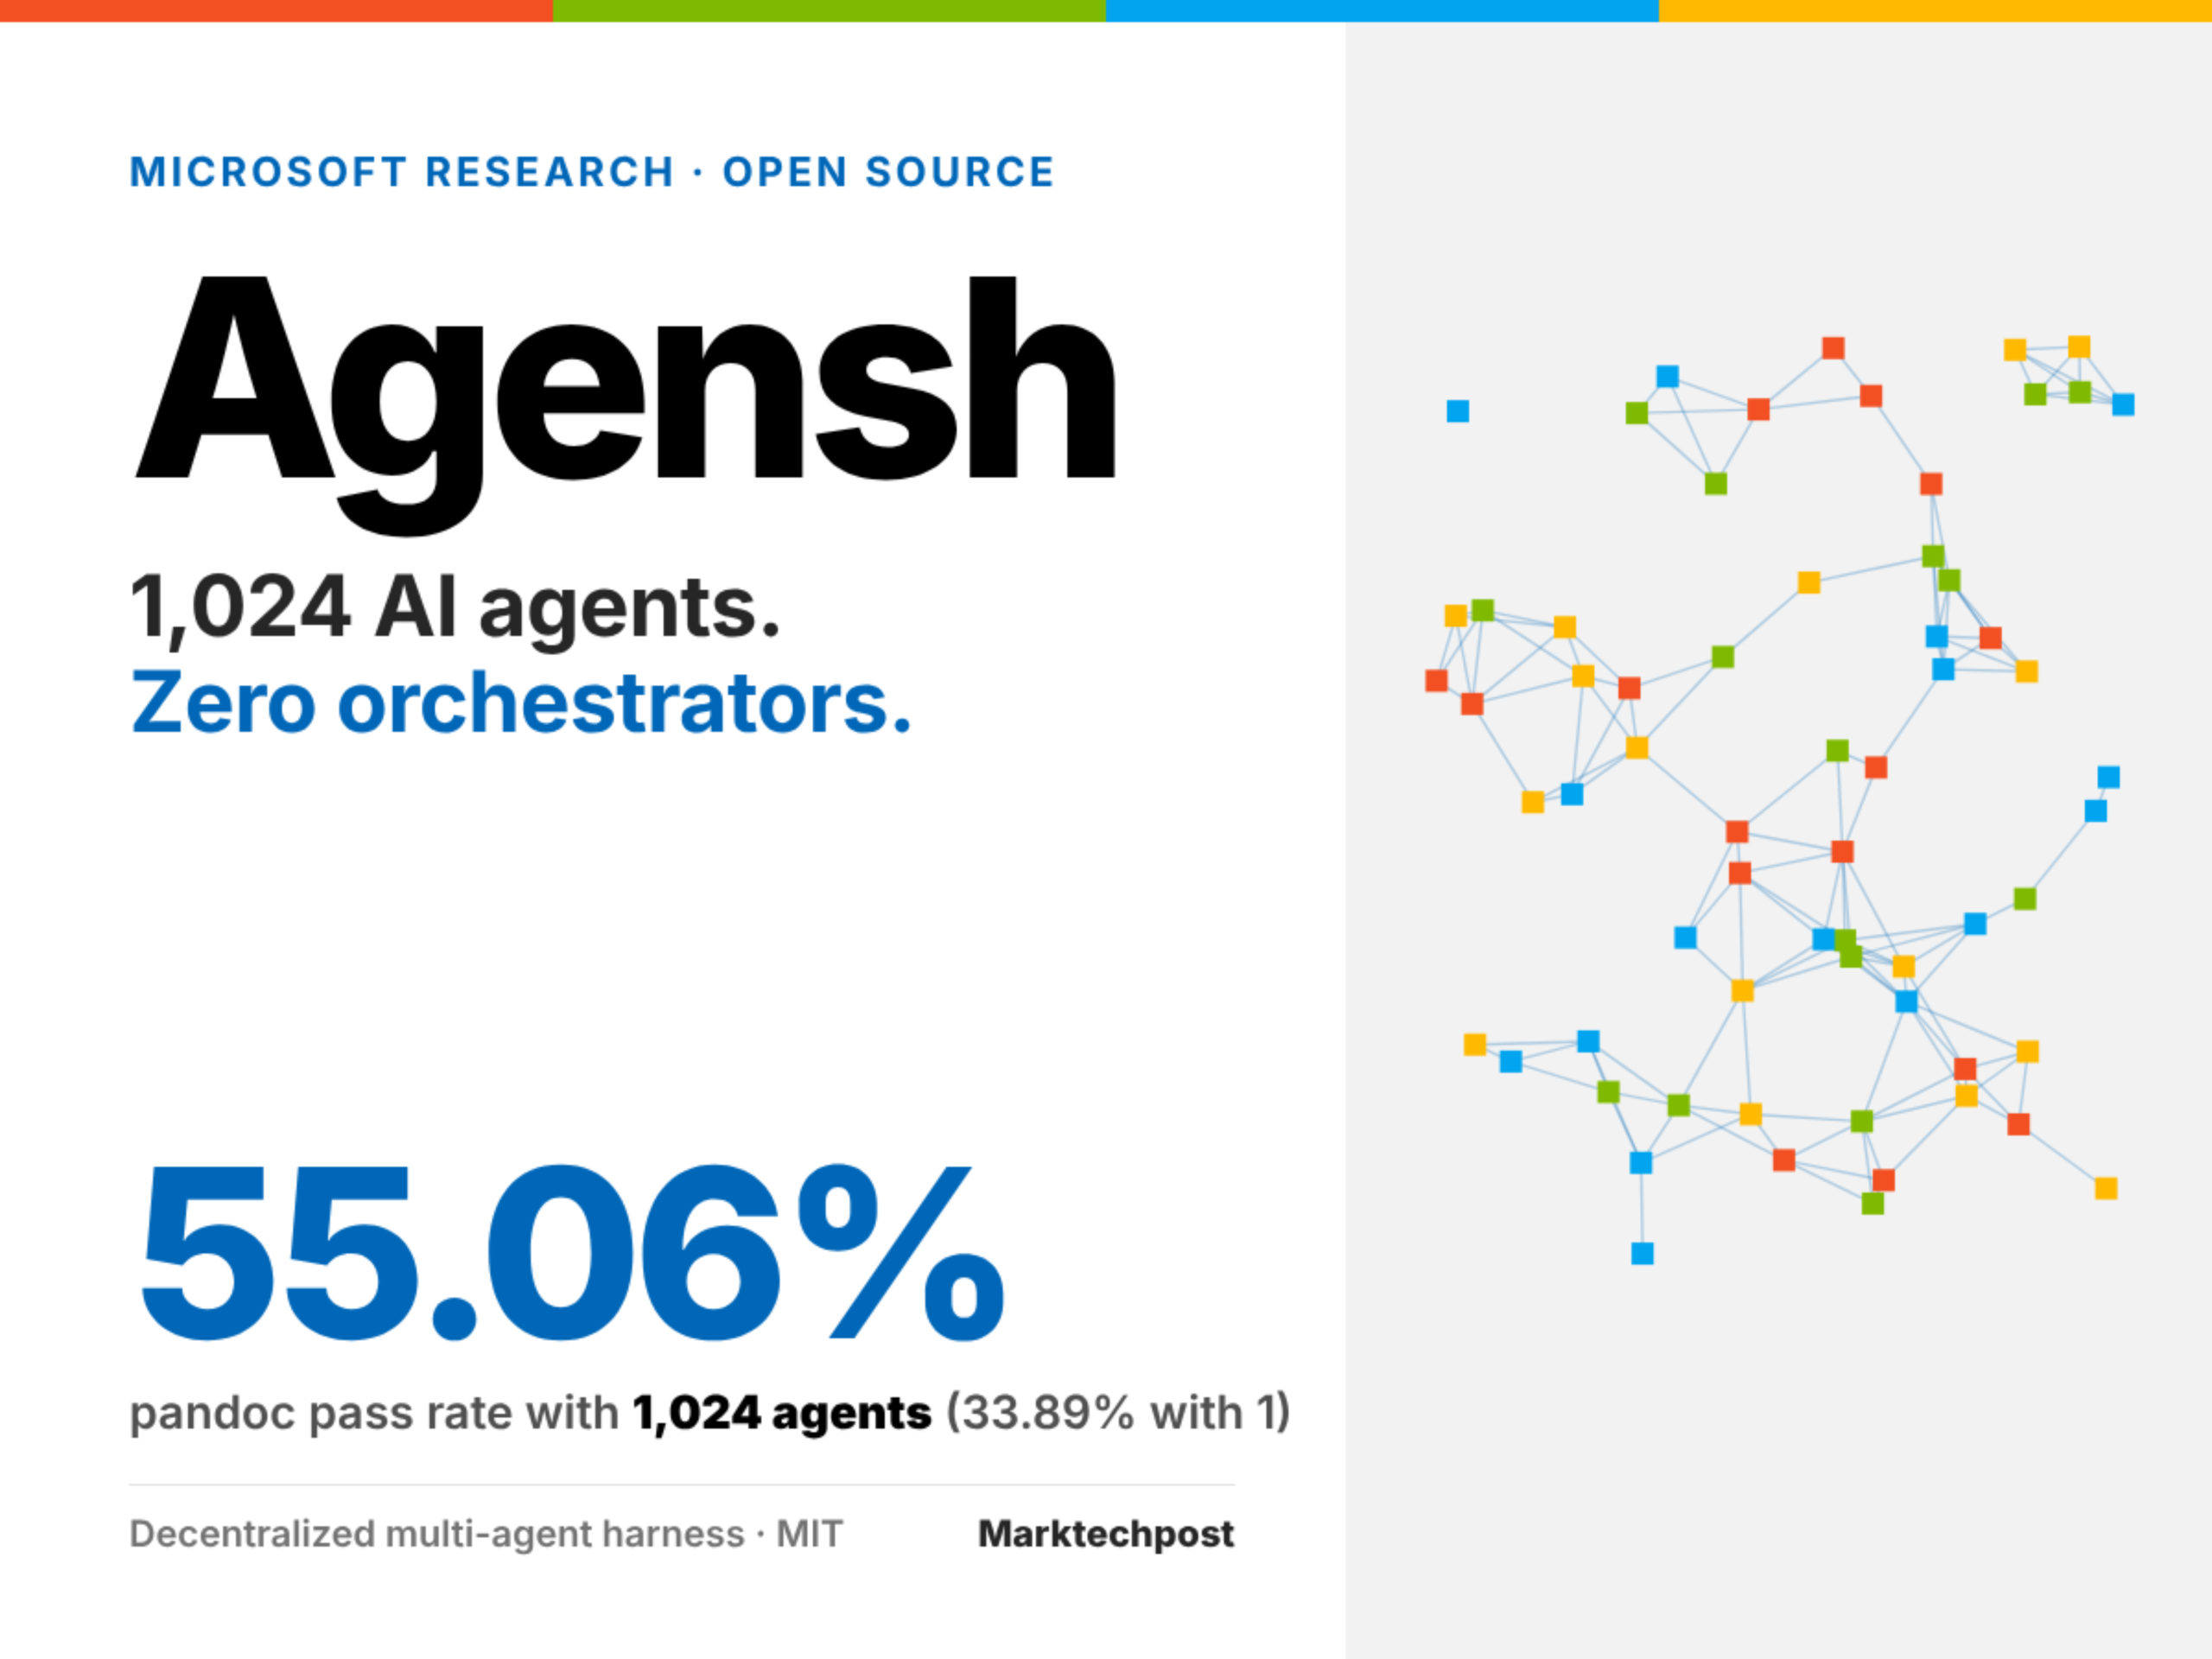
마이크로소프트 연구소는 2026년 10월 25일, 중앙 조정자를 필요로 하지 않는 다중 에이전트 런타임 프레임워크인 Agensh를 오픈소스로 공개했습니다. 이 프레임워크는 ProgramBench에서 1개부터 1,024개까지의 LLM 기반 코딩 에이전트가 자율적으로 협업하도록 지원합니다. 시스템은 Gitea, Mattermost 및 DeLM 스타일의 공유 보드를 기반으로 탈중앙화된 조정을 구현하며, 모든 에이전트는 동일한 프롬프트 기반 5단계 순환을 실행합니다. 또한 Linux와 Docker 환경에서 확장성을 검증했습니다.

Microsoft Open-Sources Agensh: A Multi-Agent Harness for 1,024 Agents

추천 이유:이 성과는 다중 에이전트 시스템 아키텍처의 중요한 발전을 나타냅니다—전통적인 ‘주제어 에이전트’ 패러다임을 탈피하고, 프롬프트 엔지니어링과 경량 서비스의 조합을 통해 대규모 자조직화를 구현합니다. ProgramBench에서 확보한 실증 데이터(예: 128개의 에이전트를 사용할 때 5개의 작업에 대한 평균 성능 향상이 49%에 달함)는 분산형 AI 엔지니어링의 새로운 기준점을 제시합니다. MIT 라이선스로 오픈소스화되어 있으며 Copilot CLI 등 주요 단일 에이전트 도구와도 호환되므로, 실제 개발에서의 참고 가치를 갖습니다.

진행 상황 및 관련 보도

언더독 살루키 27B: GSQ-RCO 기반 2비트 Qwen3.8-27B 도구 호출 모델 기술 분석

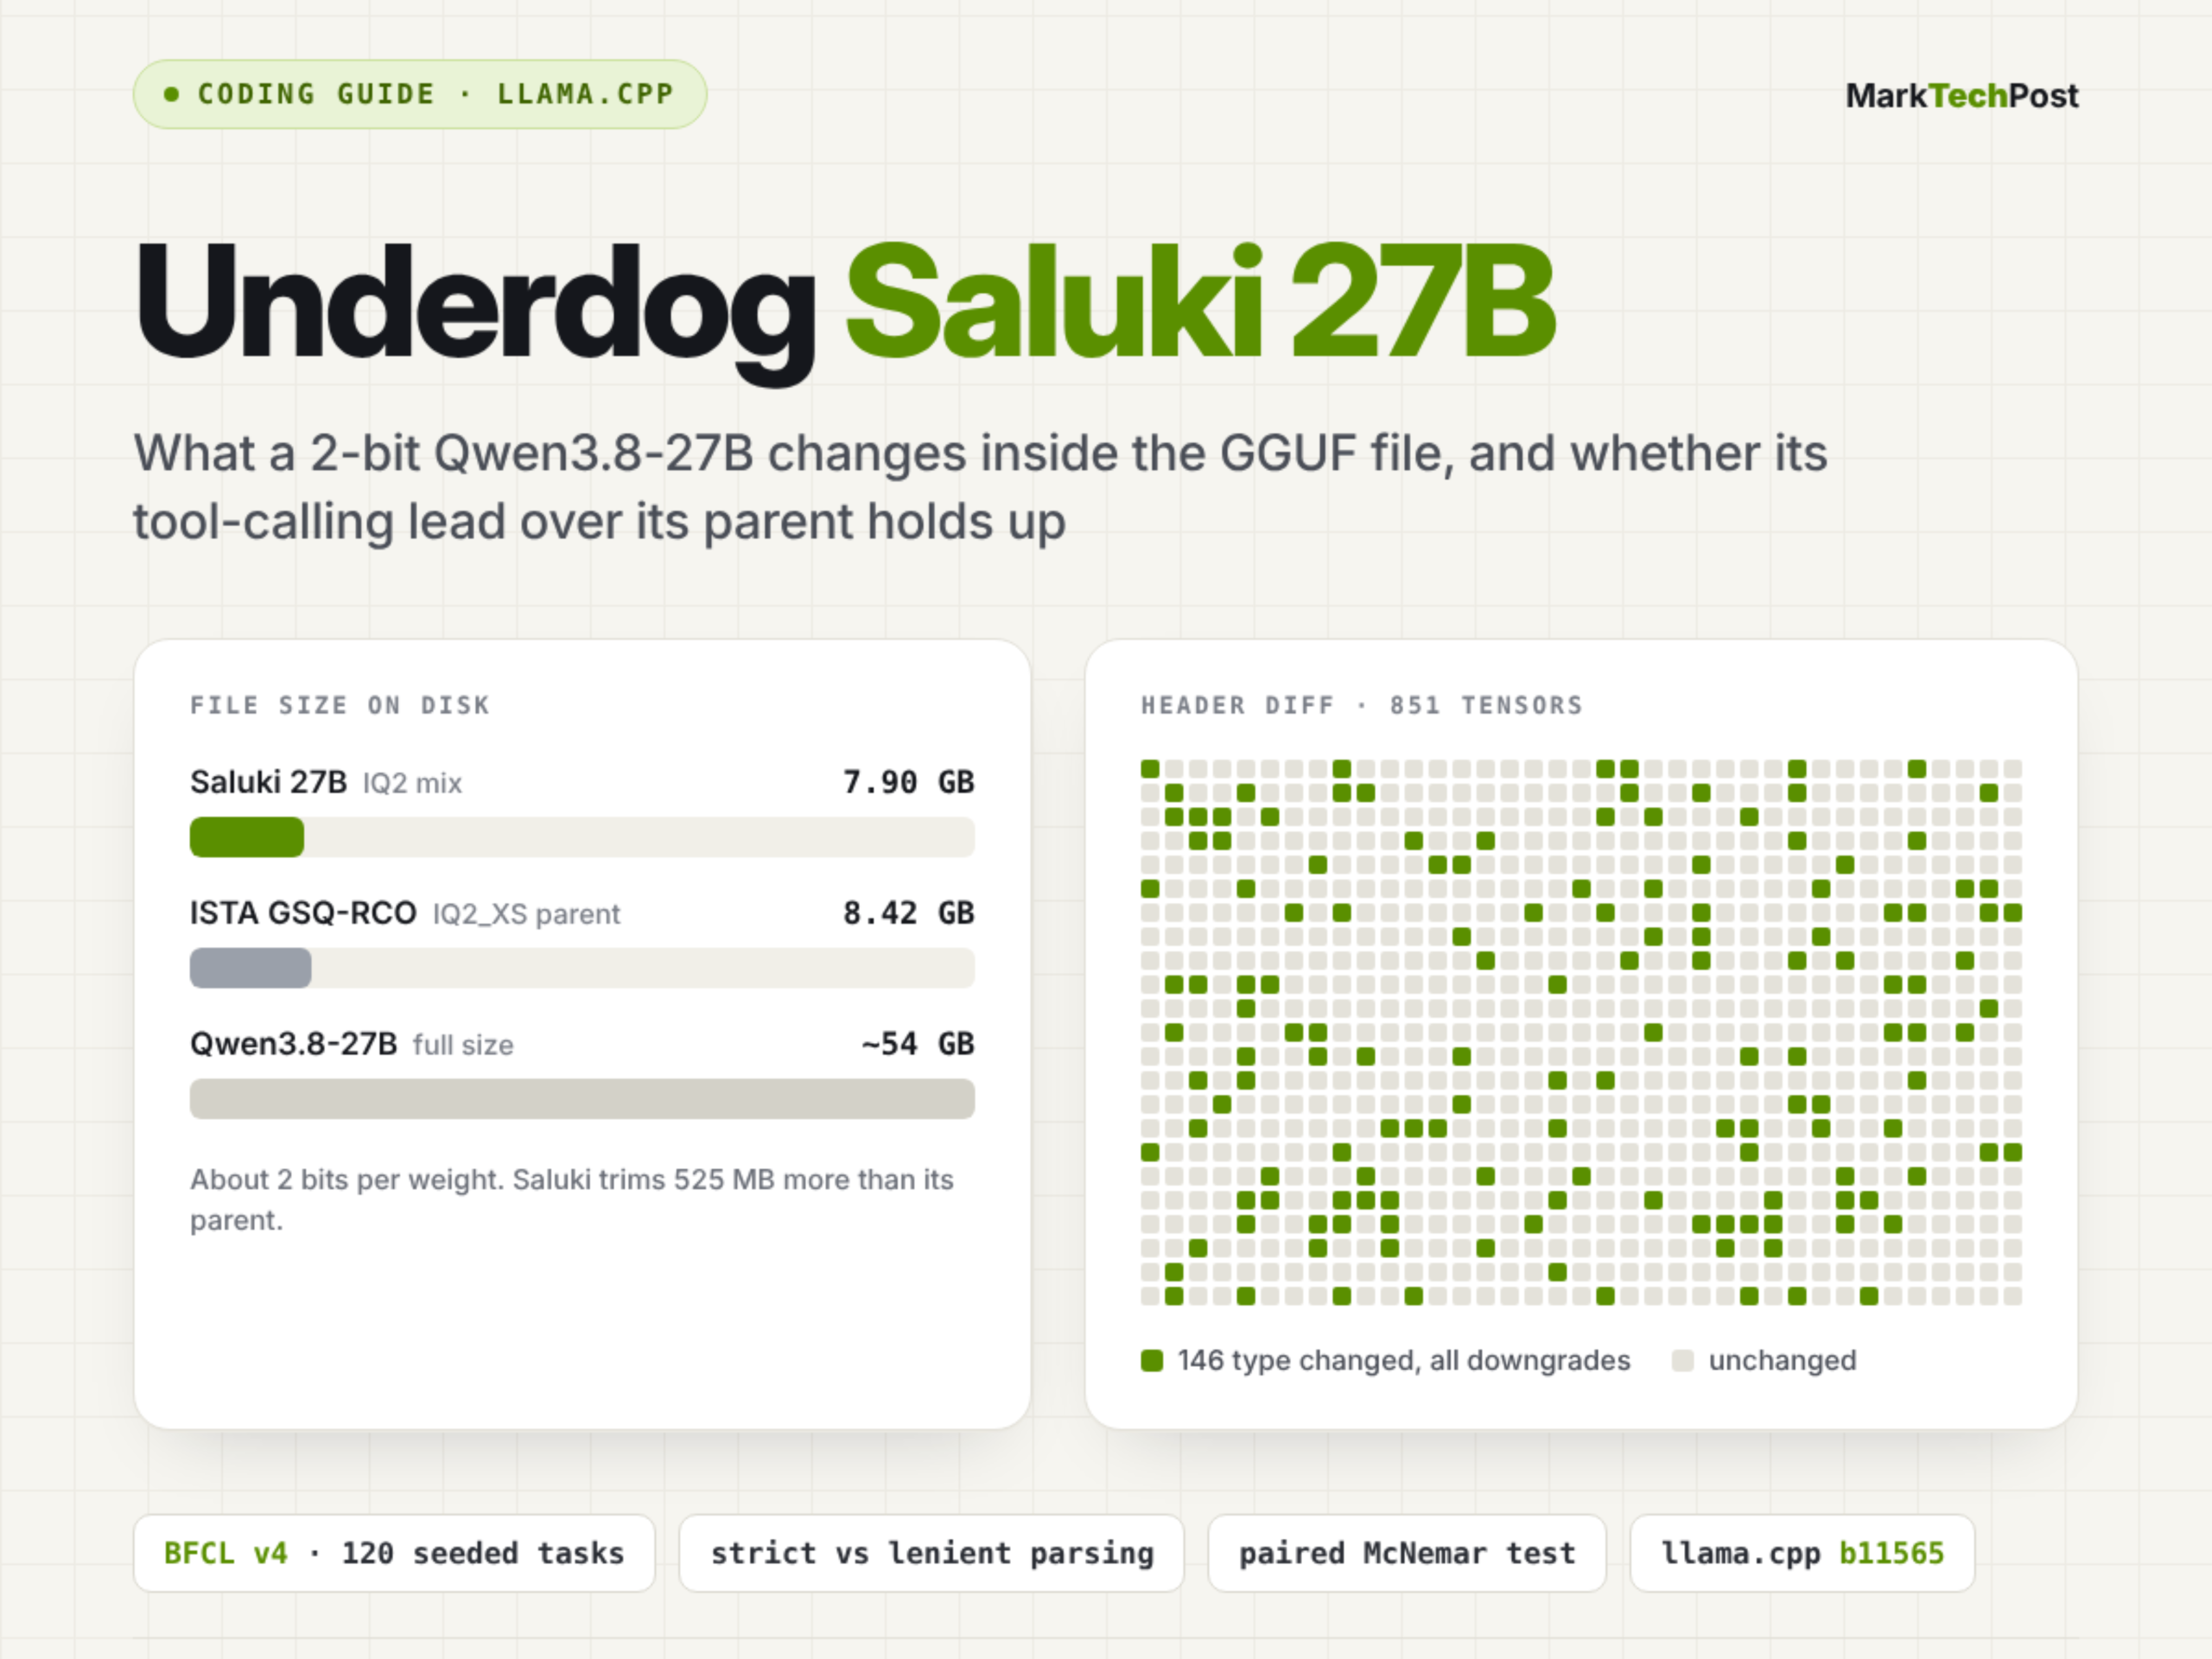
이 글에서는 Underdog가 발표한 Saluki 27B 모델을 소개합니다. 이 모델은 7.9 GB 크기의 2비트 양자화 Qwen3.8-27B 변형으로, ISTA-DASLab의 GSQ-RCO 방법을 기반으로 구축되었으며, 120개의 작업에 대한 BFCL v4 도구 호출 벤치마크에서 원래의 54 GB 풀 정밀도 모델을 능가한다고 주장됩니다. 다만 모든 성능 관련 결론은 해당 개발자의 발표에 근거한 것으로, 독립적인 검증은 이루어지지 않았습니다.

How to Run Underdog Saluki 27B: 2-Bit Qwen3.8-27B Tool-Calling Guide
진행 상황 및 관련 보도

PHP ‘멜트다운’ 사건은 AI가 기존 취약점의 위협을 어떻게 증폭시키는지 보여줍니다

보안 연구원들은 AI 도구를 활용해 수년간 존재해 왔으며 과거에는 악용이 어렵다고 여겨졌던 PHP 취약점(통칭 PHP2Shell)을 실제 공격 대상으로 전환했습니다. 해당 취약점이 공개된 지 불과 몇 시간 만에 수백만 건의 악용 시도가 발생했지만, 현재까지 성공적인 침입 사례는 보고되지 않았습니다.

추천 이유:이 사건은 AI가 새로운 취약점을 무작위로 창출하는 것이 아니라, 기존 취약점의 악용 문턱을 현저히 낮춘다는 점을 처음으로 명확히 보여주며, 공격과 방어 양쪽에서 기존 보안 환경의 변화를 가속화하는 AI의 이중적 역할을 부각합니다. 또한 모든 유의미한 발견은 인간과 기계 간의 협업에 의존합니다.

진행 상황 및 관련 보도

세바스티안 라슈카가 8개의 비디오 강좌 ‘제로부터 추론 모델 구축하기’를 발표했습니다.

세바스티안 라슈카는 2026년 10월 24일, Ahead of AI 매거진(magazine.sebastianraschka.com)에서 총 8강으로 구성된 11시간이 넘는 파이썬 및 파이토치 실습 동영상 강좌를 공개했으며, 추론 모델의 평가, 추론 시 확장, 강화학습(RLVR)과 지식 증류를 체계적으로 다루고, 모든 방법을 사전 훈련된 Qwen3-0.6B 모델을 기반으로 구현했습니다.

추천 이유:이 강좌는 저자가 ‘0부터 구축하는 대규모 언어 모델’에 이어 선보이는 심화 기술 교육 콘텐츠로, 현재 주류 LLM의 핵심 발전 방향인 추론 능력 강화에 초점을 맞추고 있습니다. 기초 환경 구축부터 GRPO 강화학습, 자기 증류 등까지 포괄하는 완전한 기술 체인을 다루며, 모든 구현은 ‘0부터 수작업으로 작성’되어 재현 가능하다는 점을 명시하고 있어 높은 교육적 가치와 엔지니어링 참고 가치를 갖습니다.

진행 상황 및 관련 보도

Anthropic의 오픈소스 OS 수준 샌드박스 sandbox-runtime: AI 에이전트에게 컨테이너 없는 파일 및 네트워크 격리를 제공합니다

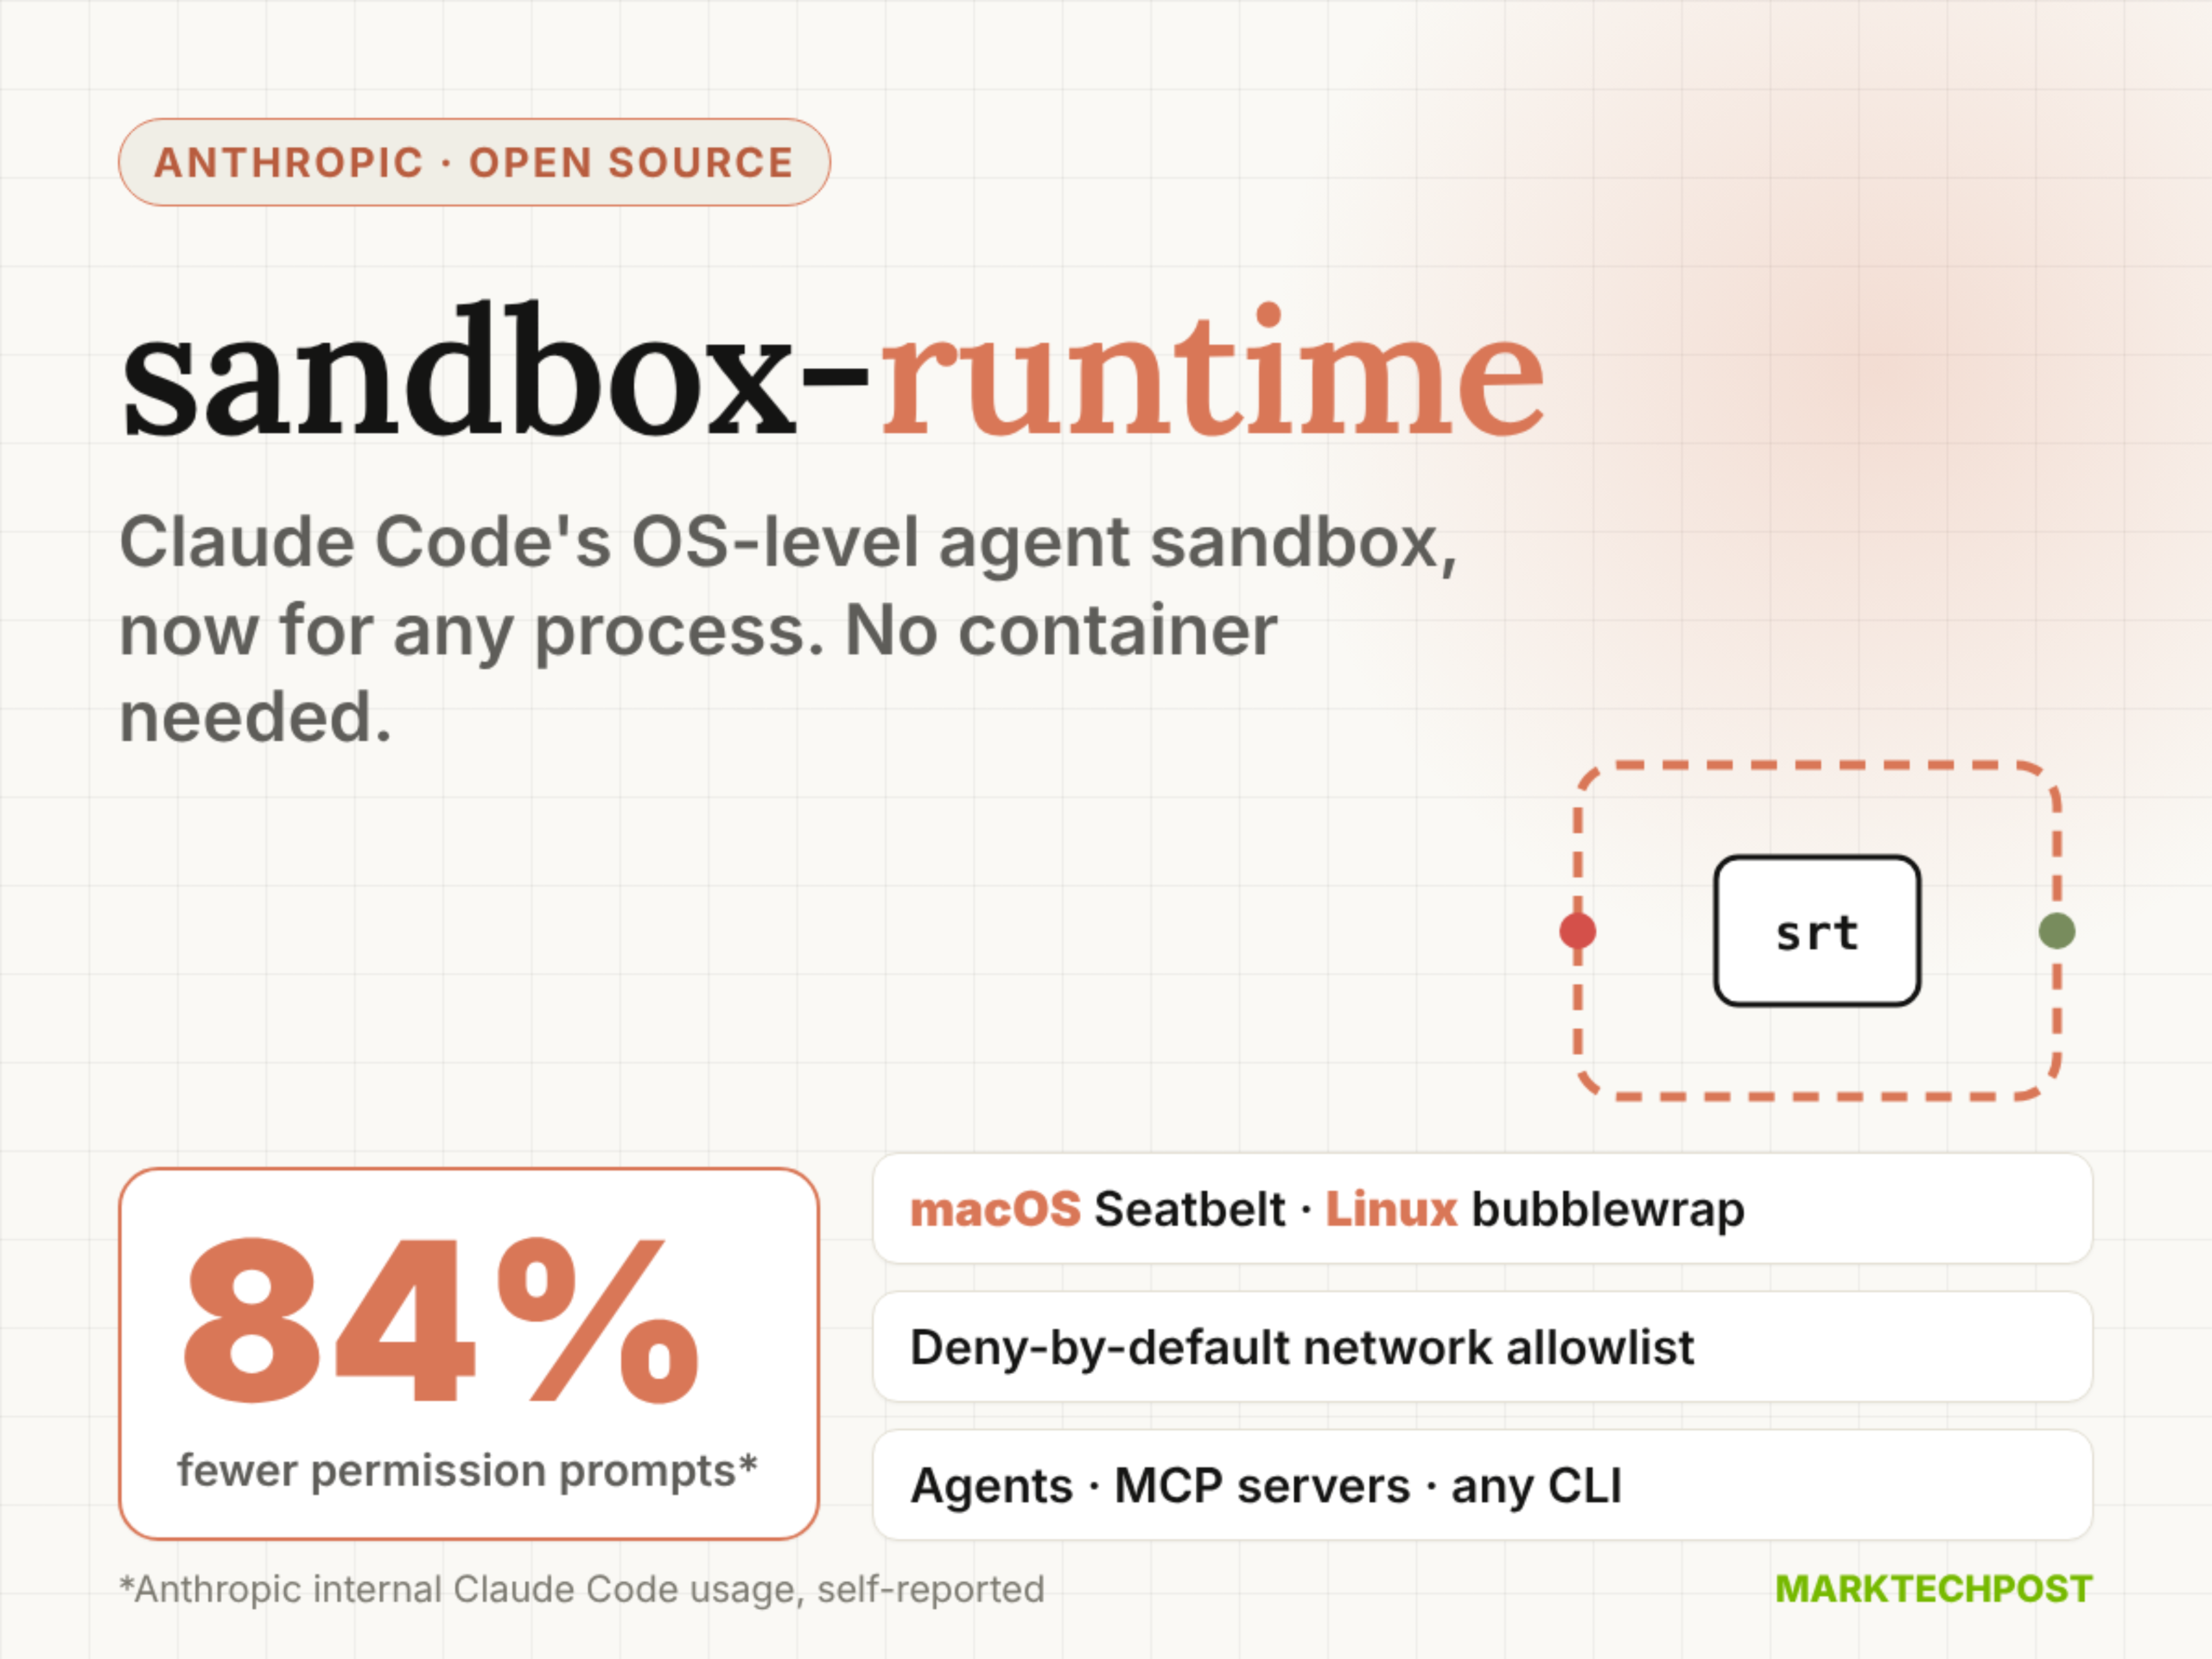
Anthropic은 2026년 10월 24일에 컨테이너에 의존하지 않는 OS 수준의 샌드박스 도구인 sandbox-runtime(srt)을 오픈소스로 공개했으며, 이는 AI 에이전트, MCP 서버 및 CLI 도구의 파일 읽기·쓰기와 네트워크 접근 권한을 제한하는 데 사용됩니다. macOS(Seatbelt), Linux(bubblewrap) 및 Windows(alpha)를 지원하며, npm 패키지 버전 v0.0.81이고 Apache-2.0 라이선스를 적용합니다.

Meet Anthropic’s sandbox-runtime: OS-Level Sandboxing for AI Agents, No Containers

추천 이유:이 도구는 AI 보안 인프라의 중요한 발전을 의미합니다—운영체제의 기본 제공 격리 메커니즘을 통해 세분화된 수준의 프로세스 트리 전면 커버리지 샌드박스 제어를 구현함으로써, 프롬프트 주입 및 권한 남용 위험에 직접 대응하며, 이미 Claude Code 내부에서 사용되어 그 효과가 검증되었습니다.

진행 상황 및 관련 보도

月之暗面发布Kimi K3.1 Pro:2.8万亿参数开源权重模型,11月4日开放权重

月之暗面于2026年10月22日前后发布Kimi K3.1 Pro,一款2.8万亿参数、1040亿激活参数的多模态MoE模型,宣称性能逼近Fable 5.1;官方承诺11月4日发布开源权重,但截至报道时权重尚未公开;独立评测显示其在智能指数、代码与网络安全基准中表现突出,但存在推理成本、本地部署可行性及营销透明度等争议。

[AINews] Kimi 3.1 Pro 104BA-2.8T: Fable-5.1-Class Open Weights narrows Closed-AI lead to 1 month... and Pro Highspeed API with 2-3× speed

추천 이유:该事件标志着当前最接近闭源前沿模型能力的开源权重模型正式进入发布倒计时,是AI开源生态关键进展;材料来源为Latent Space旗下AINews(2026年10月24日发布),内容基于对X平台、Reddit、Arena及Artificial Analysis等多方独立评测的整合,信息密度高且具时效性与交叉验证特征。

진행 상황 및 관련 보도

MemPlan: 부분 관측 가능한 텍스트 환경을 위한 기억 강화형 PDDL 계획 프레임워크

이 논문은 2026년 10월 24일 arXiv에 게재되었으며(번호 2610.30379v1), 대규모 언어 모델(LLM)을 언어와 기호 계획 간의 제한된 다리로 활용하는 메모리 조건부 PDDL 계획 프레임워크인 MemPlan을 제안한다. 이는 부분 관측 가능한 상호작용형 텍스트 환경에 적합하다.

MemPlan: Memory-Conditioned PDDL Planning for Partially Observable Text Environments

추천 이유:MemPlan는 정방향 그래프 기억과 역방향 기억 메커니즘을 통해 PDDL 문제를 동적으로 재구성함으로써, 작업 완료율과 단계 수 효율성을 크게 향상시키는 동시에 온라인 토큰 소모량도 대폭 감소시킵니다. 또한, 오프라인 미세조정을 위한 언어–기호 인터페이스는 TextWorld의 다양한 태스크 유형 간에 재사용이 가능하여 태스크별 특화된 미세조정이 필요하지 않으며, 이는 본 방법의 일반화 가능성과 실용성을 입증합니다.

진행 상황 및 관련 보도

IFC-MCQ: 건축 정보 모델링을 위한 LLM 에이전트 기반 자동 다지선다형 문제 벤치마크 생성 방법

연구자는 2026년 10월 24일 arXiv에 IFC-MCQ 방법을 발표했으며, 이는 건축·엔지니어링·건설(AEC) 분야에서 대형 언어 모델(LLM) 기반의 Industry Foundation Classes(IFC) 데이터 검색 시스템을 위해 정확한 점수 부여가 가능한 객관식 문제 벤치마크를 자동으로 생성하는 것을 목표로 한다.

IFC-MCQ: Automatically Generating Multiple-Choice Benchmarks for Evaluating LLM Agents on IFC Data Retrieval

추천 이유:이 연구는 IFC와 같은 전문적인 구조화된 데이터에 대해 LLM을 평가하는 데 있어 난이도와 비용 부담이라는 핵심 과제에 정면으로 도전하며, IFC 파일을 대상으로 한 최초의 자동화된 다지선다형 질문 생성 프레임워크를 제안합니다. 이 프레임워크는 15개 범주와 36개 하위 범주를 포괄하며, 재현 가능하고 확장 가능한 에이전트 성능 평가를 지원합니다.

진행 상황 및 관련 보도

FusionEval 발표: 대규모 언어 모델 통합을 위한 새로운 벤치마크 테스트

2026년 10월 24일, 연구자들은 arXiv에 논문 arXiv:2610.30162v1을 발표하여, 대규모 언어 모델의 통합 방법 평가를 위해 설계된 최초의 통합 벤치마크인 FusionEval을 제안했다. 이 벤치마크는 추론 체인 길이, 도구 호출 등 취약한 부분을 포괄하며, 학습 기반 및 학습 불필요형 통합 방법 간의 비교도 지원한다.

FusionEval: Benchmarking Model Fusion for Large Language Models

추천 이유:이 벤치마크는 기존 평가에서 장기 체인 추론과 도구 활용에 대한 포괄성이 부족한 점을 보완하며, 평균 성능과 최악의 성능 간의 명확한 구분을 제공하고, Qwen3/Llama 기반의 재현 가능한 전문가 풀, GPU 메모리 및 실행 시간을 포함한 다차원 지표, 그리고 오픈소스 코드를 제공하여 강력한 실무 지침성을 갖추고 있습니다.

진행 상황 및 관련 보도

谷歌I/O 2026发布Gemini for Science、WeatherNext与Antigravity 2.0等AI科研与健康工具

谷歌研究团队在I/O 2026大会上集中发布面向科学发现、气候预测、医疗健康与边缘计算的系列AI系统,包括多模态科研助手Gemini for Science、支持飓风预警的WeatherNext、可自主构建操作系统的Agentic平台Antigravity 2.0,以及开源量子芯片Willow等;所有成果均为实验性演示,尚无独立验证或监管批准。

추천 이유:人工审核

진행 상황 및 관련 보도