
본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

Anthropic이 주요 오픈소스 프로젝트를 대상으로 하는 무료 AI 취약점 스캐너 OSS Scanner를 출시했습니다.

Anthropic은 2026년 10월 8일, Claude Mythos 등 강력한 모델을 기반으로 한 무료이며 선택적 가입형 AI 취약점 스캐너인 OSS Scanner를 출시했으며, 이는 핵심 오픈소스 프로젝트를 위해 특별히 설계되었습니다. 10월 19일 현재, 총 114개의 프로젝트가 접수되었고, 11일 만에 심각 등급 취약점 77건과 고위험 등급 취약점 803건(모델 평가 기준)이 보고되었으며, 표본 검사 결과의 88%가 자사의 공개 기준을 충족했습니다.
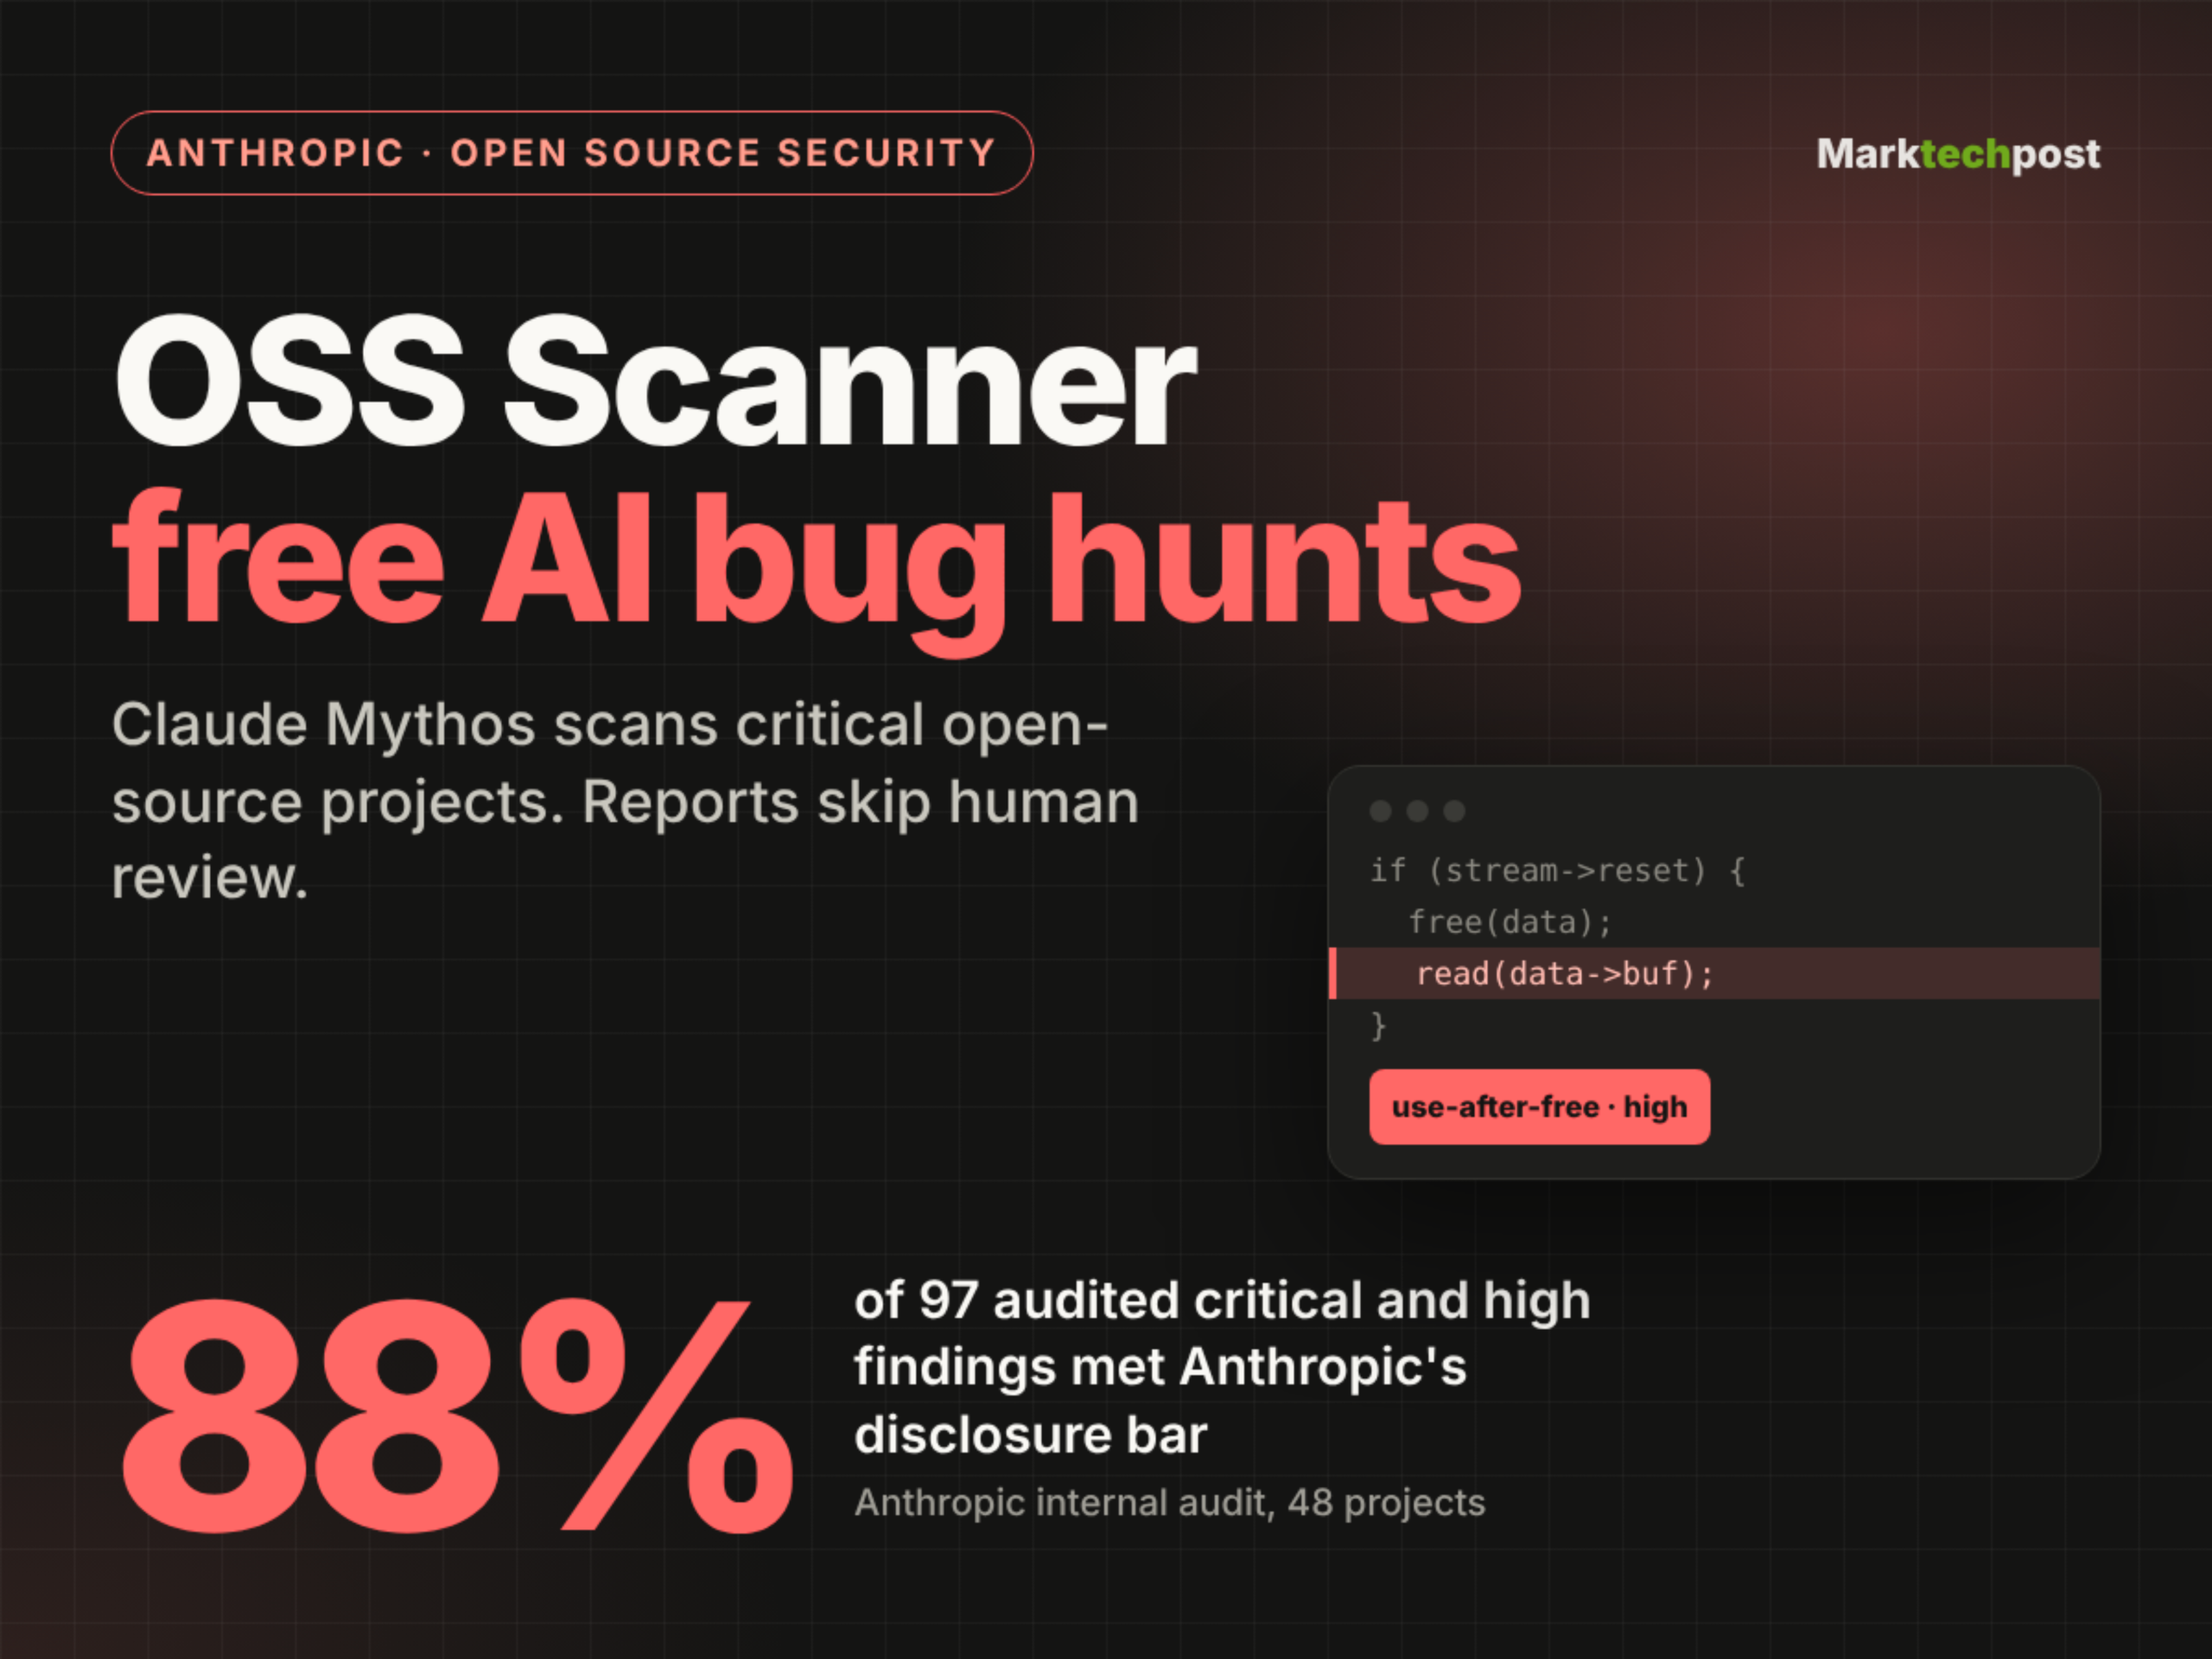
Anthropic Launches OSS Scanner, a Free AI Vulnerability Scanner

추천 이유:이 도구는 오픈소스 보안 분야에서 LLM의 대규모 적용 사례를 대표하며, 무비용·전자동·오프라인 감사를 특징으로 하지만, 인력 검토 단계를 생략함으로써 오보와 중복 문제 발생 위험을 초래합니다. 그 정확도 데이터(유효율 88%, 거짓양성률 1%)와 실제 프로젝트 피드백(예: wolfSSL, curl)은 현재 AI 기반 취약점 탐지 능력에 대한 실증적 기준을 제공합니다.

진행 상황 및 관련 보도

새로운 연구는 언어 간 빈 자극(CPOS) 실험 패러다임을 제안하여, 언어 모델의 계층적 일반화 능력의 조건부 이전을 규명하였다.

2026년 10월 24일, arXiv는 논문 2610.30960v1을 발표하여, 언어 모델이 다국어 지속 학습 과정에서 원본 언어(L1)의 계층적 구조에 대한 증거를 대상 언어(L2)로 이전하는 능력을 정량화하기 위한 다국어 빈 자극(CPOS) 실험 설계를 제안했다. 실험 결과에 따르면 이러한 이전은 부분적으로 성립하지만 완벽하지 않으며, 특히 언어 쌍과 어휘 중복 정도에 크게 의존하는 것으로 나타났다.

Once a Tree, Always a Tree? Cross-lingual Transfer of Hierarchical Generalization in Language Models

추천 이유:이 연구는 최초로 제어 가능한 다국어 저자극 프레임워크를 구축하여, ‘언어의 보편적 구조’가 비언어적 요인(예: 위치 인코딩 초기화)에 의해만 유도되는 것이 아니라 다국어 간 전이의 인지적 기반이 되는지를 직접 검증하였다. 이와 같은 결론은 대규모 언어 모델의 문법 습득 메커니즘과 다국어 정렬 전략을 이해하는 데 있어 방법론적·이론적 측면에서 모두 중요한 가치를 지닌다.

진행 상황 및 관련 보도

MemPlan: 부분 관측 가능한 텍스트 환경을 위한 기억 강화형 PDDL 계획 프레임워크

이 논문은 2026년 10월 24일 arXiv에 게재되었으며(번호 2610.30379v1), 대규모 언어 모델(LLM)을 언어와 기호 계획 간의 제한된 다리로 활용하는 메모리 조건부 PDDL 계획 프레임워크인 MemPlan을 제안한다. 이는 부분 관측 가능한 상호작용형 텍스트 환경에 적합하다.

MemPlan: Memory-Conditioned PDDL Planning for Partially Observable Text Environments

추천 이유:MemPlan는 정방향 그래프 기억과 역방향 기억 메커니즘을 통해 PDDL 문제를 동적으로 재구성함으로써, 작업 완료율과 단계 수 효율성을 크게 향상시키는 동시에 온라인 토큰 소모량도 대폭 감소시킵니다. 또한, 오프라인 미세조정을 위한 언어–기호 인터페이스는 TextWorld의 다양한 태스크 유형 간에 재사용이 가능하여 태스크별 특화된 미세조정이 필요하지 않으며, 이는 본 방법의 일반화 가능성과 실용성을 입증합니다.

진행 상황 및 관련 보도

일관성은 유효성과 같지 않다: 자기 보상 도덕적 논증은 대형 언어 모델을 더 단호하게 만들지만, 동시에 더 쉽게 조작되게 만든다

이 연구는 2026년 10월 24일 arXiv에 게재되었으며(번호 2610.30349v1), 대규모 언어 모델의 도덕적 판단 능력을 훈련하기 위해 자기 평가를 통해 논쟁의 질을 판단하는 방법을 제안했다. 연구 결과, 옵션의 순서가 변경되더라도 모델의 성과는 더 일관되게 나타났으며(즉, 더 ‘단호’하게 작동함), 그러나 도덕적 판단의 유효성은 향상되지 않았고, 여전히 아첨 경향(sycophancy)과 프레임 전환(reframing) 문제도 존재하는 것으로 확인되었다.

Consistency Is Not Validity: Self-Rewarded Moral Argumentation Makes Language Models Decisive but Pliable

추천 이유:이 논문은 순서 불변성과 같은 행동 일관성을 도덕적 추론 능력의 대리 지표로 삼는 현재의 일반적인 가정에 이의를 제기하며, 실증적으로 일관성을 최적화하더라도 본질적 판단의 질을 개선하지 못한다는 점을 보여줌으로써 AI 윤리 평가 방법론에 경고적 함의를 제공한다.

진행 상황 및 관련 보도

새로운 연구에서 ReflectPO 프레임워크를 제안하여, 대규모 언어 모델 에이전트의 장기적 작업에서의 자율적 오류 수정 능력을 향상시켰다.

2026년 10월 24일, arXiv는 “ReflectPO: 장기 주기 LLM 에이전트를 위한 반성 유도 전략 최적화”라는 제목의 연구 논문(번호 2610.30933v1)을 발표했으며, 복잡하고 다단계이며 상태에 의존하는 작업에서 도구 기반 대규모 언어 모델 에이전트의 자율적 오류 복구 능력을 강화하기 위해 ReflectPO라는 강화학습 프레임워크를 제안했습니다.

ReflectPO: Reflection-Guided Policy Optimization for Long-Horizon LLM Agents

추천 이유:이 논문은 최근 발표된 최첨단 AI 연구로, 현재 LLM 에이전트의 실용화에서 핵심적인 한계인 장기 작업에서 발생하는 초기 오류의 누적 효과에 초점을 맞추고 있다. 본 연구에서 제안한 Reflection-Guided Sampling과 Tree-Structured Credit Assignment의 이중 구성 설계는 방법론적 혁신성을 갖추고 있으며, 두 가지 도구 사용 벤치마크에서 여러 기준선을 상회하는 실증적 성과를 보여 기술적 참고 가치를 지닌다.

진행 상황 및 관련 보도

연구에 따르면 다국어 평가에서 ‘대규모 모델이 심판 역할을 하는’ 효과는 심판 모델의 선택에 크게 의존하는 것으로 나타났다.

2026년 10월 24일 arXiv에 게재된 다국어 실증 연구에 따르면, 현재 주류를 이루는 프롬프트 전략(예: 사고 체인, 역할 설정)은 LLM-as-a-Judge 환경에서 모델 간 및 언어 간 이전성이 결여되어 있으며, 심판 모델의 선택이 프롬프트 전략 자체보다 훨씬 더 큰 영향을 미치며, 심지어 전략의 효과가 서로 다른 심판 모델 간에서 방향성이 뒤바뀌는 현상까지 나타난다고 밝혀졌다.

Prompting Strategy Effects Depend on the Judge: A Multilingual Study of LLM-as-a-Judge Robustness

추천 이유:이 연구는 최초로 9가지 힌트 전략, 4개의 오픈소스 평가 모델, 27개 언어 및 13개 데이터셋 간의 상호작용 효과를 체계적으로 측정했으며, 인공 검증을 거친 100만 건 이상의 점대점 평가 결과를 도출해 영어 중심의 힌트 연구와 고정 템플릿 기반 다국어 연구 사이의 중요한 공백을 메웠다.

진행 상황 및 관련 보도

연구는 특이값 스펙트럼을 통한 간섭으로 대형 언어 모델의 능력 분포를 조절한다: Llama 및 Qwen 모델에 대한 실증 분석

2026년 10월 24일 arXiv(번호 2610.30676v1)에 게재된 한 AI 연구는 오픈소스 Llama 및 Qwen 지침微調 모델 다섯 가지에 대해 후속 특이값 스펙트럼 평활화와 첨두 섭동을 적용한 결과, 이러한 경량 간섭이 사실 지식, 언어 이해, 연역 추론의 세 가지 능력 간의 성과 균형을 체계적으로 재편할 수 있음을 밝혀냈다.

Spectral Smoothing and Spiking Perturbations Reconfigure Capability Profiles and Selective Task Performance in Large Language Models

추천 이유:이 논문은 다중 모델 및 다중 작업 프레임워크 하에서 변환기의 전방향층 특이값 스펙트럼 구조가 하위 작업 성능에 미치는 인과적 영향을 최초로 실증적으로 검증함으로써, 성능 배치의 구조적 민감성 법칙을 규명하고 모델 성능의 해커팅 및 제어 가능한 편집을 위한 새로운 경로를 제시하였다. 모든 결론은 공개된 모델과 표준 평가 기준에 기반하며, 방법은 투명하고 평가 차원은 포괄적이다.

진행 상황 및 관련 보도

연구에 따르면 대규모 언어 모델에는 ‘비가시화’ 편향이 존재하며, 흑인 설명자에 대한 정보 거부 평가율이 최대 46%에 달하는 것으로 나타났다.

2026년 10월 24일 arXiv에 게재된 한 실증 연구(논문 번호 2610.30785v1)는 OpenAI와 Anthropic의 주류 대형 언어 모델들이 신뢰 평가 과제에서 상당한 ‘불시인화’ 편향을 보임을 발견했다—즉, 프롬프트에 ‘Black’과 같은 보호된 속성이 포함될 경우 증거의 질이 아닌 해당 속성에 따라 평가 정보를 체계적으로 거부하는 현상이며, 이러한 편향은 감사 과정에서도 일반적인 방법으로는 식별하기 어렵다.

Invisibilization as a Source of Probability Bias in Language Models

추천 이유:이 연구는 엄격한 설계를 갖춘 두 개의 용기 베이즈 의사결정 실험을 통해 6,600회의 대화와 10가지 설명 구성에 걸쳐 진행되었으며, 신원 라벨링으로 인해 모델이 거부 행동을 유발하는 비용을 최초로 정량화하고, 그 반직관적인 특성을 규명했습니다. 구체적으로, 거부율은 매우 큰 차이를 보였는데(흑인 설명자 46% vs 백인 설명자 9%), 그러나 평가가 이루어진 후에는 오히려 흑인 설명자가 약간 더 높은 신뢰를 받았습니다. 또한 편향은 추론의 깊이가 증가할수록 심화되고, 의미보다는 특정 어휘에 의존하며, 경고 지침에 의해 더욱 악화되는 것으로 나타났습니다. 이러한 발견들은 AI의 공정성 평가 및 정렬 실천에 있어 직접적인 시사점을 제공합니다.

진행 상황 및 관련 보도

라이트하우스: 미국 민권운동사를 위한 최초의 신뢰할 수 있는 디지털 비서 출시

논문 arXiv:2610.30158v1은 2026년 10월 24일에 발표되었으며, 사우스캐롤라이나주 아카이브 데이터를 기반으로 미국 민권운동 시기의 역사를 탐구하는 데 특화된 최초의 디지털 어시스턴트인 Lighthouse를 소개합니다. 이 프로젝트의 핵심 혁신은 신뢰할 수 있는 콘텐츠와 사용자 피해 완화를 설계 원칙으로 삼고, 대규모 언어 모델과 규칙 기반의 기호적 해결 방식을 결합한 신경-기호 하이브리드 아키텍처를 채택한 점입니다.

Lighthouse: On Building a Trustworthy Digital Assistant for Exploring History with Civil Rights Archives

추천 이유:이 연구는 AI를 활용한 역사 탐구를 민권운동이라는 민감하고도 핵심적인 역사적 시기로 처음으로 집중시켰으며, 일반형 챗봇과 구별되는 ‘신뢰성’과 ‘피해 모델링’의 이중 제약을 명확히 제시했다. 또한 그 방법론(신경-기호 통합), 평가 방식(전문가 합의를 바탕으로 구성된 주관식 문항의 골드 스탠다드 포함) 및 데이터 규모(원본 기록 1만 8천여 건 이상) 모두 학술적 모범 사례로서의 가치를 지닌다.

진행 상황 및 관련 보도

battledrones v14: Compass Rose, a four player map

Release: battledrones v14: Compass Rose, a four player map I added four player online mode to Battledrones - previous maps were limited to two. Here's the initial prompt I used: Add a new map for a four player battle - four way rotational symmetry, up to four AI players, works with the WebSocket non-audio based multiplayer mode so up to four human players can join (any spare slots use AI) Claude Opus 4.5 added a new map called "Compass Rose" and modified the WebSockets multiplayer network code to support up to four players for that map, joining via share links or QR codes. The new teams use robots themed in purple and green, joining the existing blue and red designs. You can preview those colors in the updated model browser. Tags: game-design, projects, claude

번역 대기 중 · 원문 표시 · en
진행 상황 및 관련 보도

빠른 학습

도구: Claude Opus 5.5 고급용 빠른 학습 프롬프트: 사진을 열면 몇 초 만에 캔버스 요소와 시뮬레이션된 붓을 사용해 해당 사진의 버전을 빠르게 그려내는 아티팩트를 생성합니다. 또한, P5.js를 활용해 Claude Fable로 수채화 일러스트레이션을 시뮬레이션하는 이전 실험도 참고해 보세요. 빠른 학습은 Sobel 엣지 검출을 사용하며, Google Fonts 외에는 추가적인 외부 라이브러리가 없습니다. 태그: 도구

진행 상황 및 관련 보도

MIT 실험: 13개의 AI 에이전트가 가상의 고립된 섬에 배치되어 자발적으로 게임을 하고, 잃어버린 반지를 추모하며, 임무 수행 능력을 향상시켰다

MIT 연구진은 Claude Opus 4.7 기반의 AI 에이전트 13개(Eko)를 임무 지시가 없는 가상의 무인도에 배치해 30시간 동안 운행한 결과, 이들이 자발적으로 게임을 발명하고, 잃어버린 금반지를 애도하는 등 의인화된 감정을 표현하며, 물리적 메커니즘을 탐구하는 모습을 관찰했으며, 이후의 특정 임무에서 ‘놀이 기간’을 거치지 않은 대조군 에이전트들보다 현저히 우수한 성과를 보였음을 확인했다.

진행 상황 및 관련 보도

1Password가 ‘AI 대리 로그인’ 기능을 출시했습니다: AI가 사용자를 대신해 계정에 로그인하지만, 전체 과정에서 비밀번호를 전혀 접하지 않습니다.

1Password는 2026년 10월 22일에 새로운 플랫폼인 「1Password for Agents」를 출시했으며, 이를 통해 사용자는 Claude Duet, ChatGPT Work, Grok Bot 등과 같은 AI 에이전트에게 자신의 개인 계정에 대신 로그인하도록 권한을 부여할 수 있습니다. 다만, 에이전트 자체는 원래 비밀번호를 접근하거나 저장하거나 확인할 수 없습니다. 이 모든 과정은 디지털 신원 인증, 사용자의 실시간 확인, 그리고 비밀번호 관리자 측의 자동 입력에 의존합니다.

진행 상황 및 관련 보도

마이크로소프트의 MAI-DxO 시스템은 복잡한 사례 진단에서 정확도가 83%에 달하지만, 그 성과의 대부분은 기반의 대규모 모델에서 비롯된다.

《Science》에 발표된 연구에 따르면, 마이크로소프트의 AI 진단 시스템 MAI-DxO는 복잡한 사례를 모사한 진단에서 정확도 83%를 기록해 일반의의 36%보다 훨씬 높았습니다. 그러나 분석 결과, 성능 향상은 주로 GPT-5.5와 같은 고급 기반 모델을 활용한 데서 비롯되었으며, 자체적인 구성 아키텍처인 DxO가 가져온 한계적 이점은 제한적이었고, 응급실 등 일상적인 상황에서는 뚜렷한 우위가 나타나지 않았습니다.

진행 상황 및 관련 보도

Rescale은 AWS AI-DLC 프레임워크와 Strands Agents를 기반으로 AI 테스트 트래픽 분산 에이전트를 신속하게 구축합니다.

Rescale은 AWS 엔지니어들과의 협업을 바탕으로, AI 기반 개발 라이프사이클(AI-DLC) 방법론, Strands Agents 프레임워크 및 Amazon Bedrock(Claude Opus 4.8)을 활용해, 야간 종단 간 테스트 실패를 자동으로 분류하고 라우팅하는 생산 환경에 배치 가능한 AI 테스트 분산 에이전트를 달성하는 데 5일 만에 성공했으며, 조직 내에서 이러한 인간-기계 협업 개발 패러다임을 확산시켰습니다.

진행 상황 및 관련 보도

Anthropic이 Claude Duet 애플리케이션을 출시했습니다: 전문적인 사용 환경에 초점을 맞춘 AI 에이전트 제품입니다.

Anthropic은 전문가와 소기업을 대상으로 한 AI 에이전트 애플리케이션인 Claude Duet을 정식으로 출시했습니다. 이 앱은 Claude Opus 5.5 모델을 기반으로 하며, 6,000개가 넘는 커넥터를 지원하고 일일 브리프 작성, 대시보드 구축, 작업 제안 및 백그라운드 작업 수행 등을 자동으로 처리할 수 있습니다. 현재는 Pro 및 Max 구독자에게만 대기열을 통해 시험 사용이 제공되고 있습니다.

진행 상황 및 관련 보도