
llama.cpp 发布 b11871 版本:新增 JSON 嵌套深度限制以防止服务崩溃
llama.cpp 在 b11871 版本中引入关键安全修复,对请求中 JSON 嵌套层级实施 128 层硬性限制,避免因深度递归解析导致 HTTP 线程栈溢出、服务崩溃(macOS 触发 SIGBUS,Linux 触发 SIGSEGV)。该策略覆盖 chat 接口多类输入场景,并统一返回 HTTP 400 错误。
注目する理由:按信源设置仅收录,不参与自动精选
見出し・要約・本文から、情報のつながりを探します。
llama.cpp 在 b11871 版本中引入关键安全修复,对请求中 JSON 嵌套层级实施 128 层硬性限制,避免因深度递归解析导致 HTTP 线程栈溢出、服务崩溃(macOS 触发 SIGBUS,Linux 触发 SIGSEGV)。该策略覆盖 chat 接口多类输入场景,并统一返回 HTTP 400 错误。
注目する理由:按信源设置仅收录,不参与自动精选
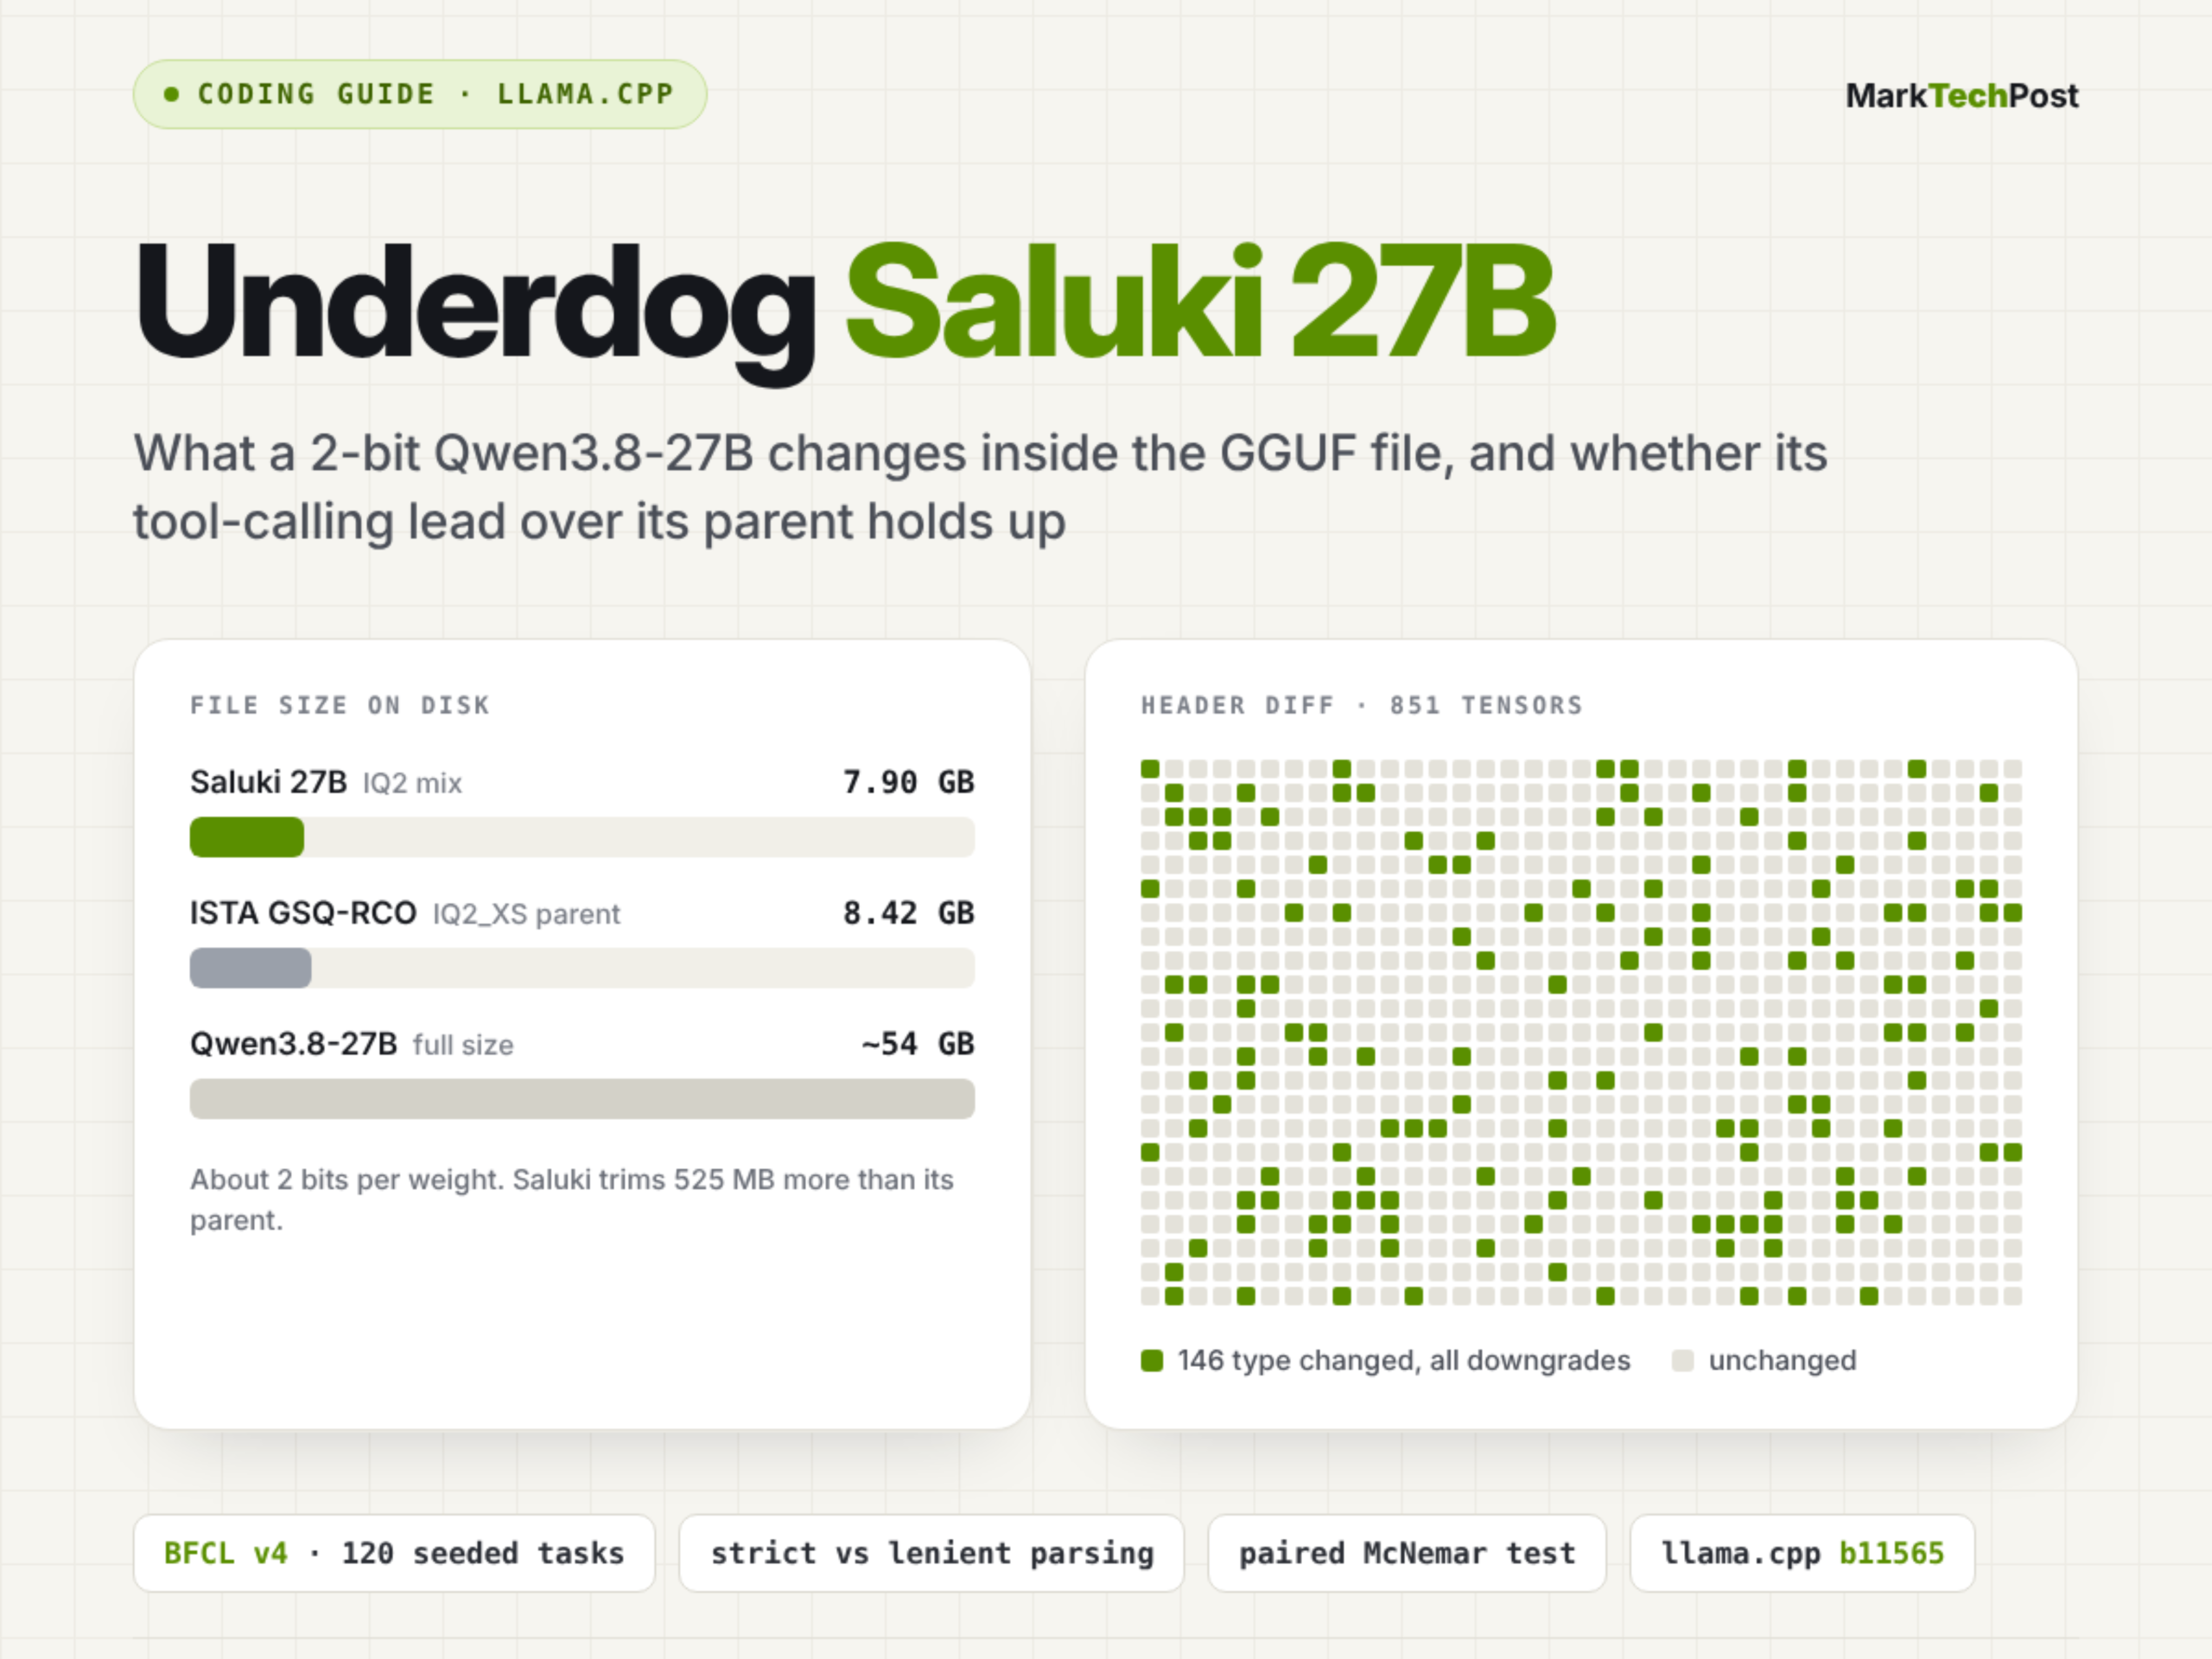
本記事では、Underdogが公開したSaluki 27Bモデル——7.9 GBの2ビット量子化を採用したQwen3.8-27Bの変種——について紹介します。同モデルはISTA-DASLabのGSQ-RCO手法を用いて構築されており、120タスクにおけるBFCL v4ツール呼び出しベンチマークにおいて、元の54 GBのフル精度モデルを上回るとされています。ただし、すべての性能に関する結論は開発者による声明に基づくものであり、独立した検証は行われていません。
llama.cpp 在版本 b11870 中新增对 DeepSeek-V4.1-Flash(deepseek41)模型的支持,并针对其 Engram 架构进行多项底层优化,包括 KV 缓存计算简化、BF16 精度替代 MXFP8、in-graph 行 gather 等;同步提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的多平台二进制构建。
注目する理由:按信源设置仅收录,不参与自动精选
llama.cpp 项目发布构建版本 b11869,主要修复 Jinja 模板中 select 和 selectattr 函数的参数解析逻辑,并提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的数十种硬件与后端组合的预编译二进制包。
注目する理由:按信源设置仅收录,不参与自动精选
llama.cpp 于 GitHub 正式发布 b11867 版本,核心变更包括服务端(server)入口点重构(PR #31113),新增 server_role 机制;同时提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的 40+ 预编译二进制包,支持 CPU、CUDA(12.4/12.8/13.4)、Vulkan、ROCm 10.0、OpenVINO、SYCL(FP16/FP32)、Snapdragon(Adreno+Hexagon)等多元硬件后端。
注目する理由:按信源设置仅收录,不参与自动精选
llama.cpp 项目发布构建版本 b11865,核心变更包括在 RDMA 接收逻辑中增加内存边界检查(PR #30399),并显著扩展硬件加速支持,覆盖 CUDA 13.4、ROCm 10.0、Vulkan、OpenVINO、SYCL 及高通 Snapdragon(CPU+Adreno+Hexagon)全栈异构计算后端;macOS KleidiAI 支持与 openEuler 构建被明确标记为 DISABLED。
注目する理由:按信源设置仅收录,不参与自动精选
llama.cpp v.b11861 修复了 minimax-m3 模型在 NVFP4/MXFP8 量化下因 scale 张量未注入计算图而导致的权重失真问题,避免‘token soup’与残差淹没;同步提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的多平台二进制构建。
注目する理由:按信源设置仅收录,不参与自动精选