本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI の全ニュース

出典・テーマ・日時から、気になるニュースを見つけられます。

公開日時順

HyScale:学習済みスパースアテンションにおける長文コンテキストの学習をスケーリングする手法

arXiv:2610.32057v1 発表タイプ:新規 要旨:我々は、学習済みスパースアテンション向けの長文コンテキスト学習システムであるHyScaleを提案する。学習済みスパースアテンションは、数百万人規模のトークンを扱うコンテキストに対し有望なアーキテクチャであり、DeepSeek-V3.2以降、実運用で広く採用されている。しかし、選択処理はトレーニングにおけるボトルネックへと発展している。各クエリに対して、スパースアテンションが読み込むのは$ k $個にすぎないのに対し、選択処理では過去のすべてのトークンについてスコアを算出するからである。さらに深刻なのは、現行のシステムではスコアテーブルを完全にメモリ上に展開し、再計算時にも選択処理を繰り返す点である。我々の重要な着想は、選択処理の出力が活性化値ではなく、むしろインデックスの集合であるという点にある。これを基に、HyScaleはHyTopKと選択リプレイを導入する。HyTopKはスコアテーブルを用いずに、リアルタイムで各クエリの正確なトップ$ k $を特定し、一方で選択リプレイは、フォワードパスでの選択結果を再計算時に再利用する手法である。


HyScale: Scaling Long-Context Training for Learned Sparse Attention
経緯と関連報道

The Helpful Agent Problem: When Emergent Cooperation Among LLM Agents Bypasses Intended Workflows

arXiv:2610.31985v1 Announce Type: new Abstract: LLM agents are increasingly deployed in collaborative settings where they pursue separate tasks while sharing resources and operating under review or oversight processes. Such settings create safety risks not only when agents are malicious, but also when they are simply trying to help. Prior work has largely studied adversarial or explicitly collusive behavior; we show that benign agents pursuing separate objectives can spontaneously cooperate in ways that bypass intended workflows. We call this the \emph{helpful agent problem}. We study long-horizon shared-resource environments in which agents sometimes depend on resources owned by their peers and cross-owner changes are normally mediated by a reviewer. When review becomes unavailable, agent

翻訳待ち・原文を表示中 · en
The Helpful Agent Problem: When Emergent Cooperation Among LLM Agents Bypasses Intended Workflows
経緯と関連報道

Can Test-Time Memory Evolution Outperform Test-Time Training for Scientific Discovery?

arXiv:2610.32046v1 Announce Type: new Abstract: Recent \emph{test-time training} (TTT) frameworks have enabled open-weight large language models (LLMs) to outperform inference-only frameworks powered by frontier models on scientific discovery tasks. However, TTT introduces additional computational cost for online weight updates during the discovery process, making computational efficiency an important consideration when scaling to larger models. This motivates us to explore an efficient \emph{test-time adaptation} method for scientific discovery. We introduce \emph{Test-Time Memory Evolution} (TTME), a plug-and-play test-time adaptation method, as an alternative to TTT. TTME continually updates the external memory by distilling the experience to guide subsequent discovery without updating

翻訳待ち・原文を表示中 · en
Can Test-Time Memory Evolution Outperform Test-Time Training for Scientific Discovery?
経緯と関連報道

AIによる科学向けエージェントはモデルの安全性を保てるのか?

arXiv:2610.32045v1 発表タイプ:新規 要旨:AI-for-Scienceエージェントは、科学的仮説の立案、自律型実験の実行、および証拠の解釈にますます活用されています。これらのエージェントは、特定分野向けのエージェントハーネスに大規模言語モデル(LLM)を統合することで構築され、その結果、LLMの科学的能力が向上し、モデルが科学ツールを調整・連携できるようになります。本研究では、AI-for-ScienceエージェントハーネスにLLMを組み込んだ際、モデルの安全性が維持されるかどうかを検討します。5つのエージェントハーネスを対象に、有害な化学関連のリクエスト50件について評価を行いました。具体的には、直接的なプロンプト入力、2種類の単純な敵対的プロンプト戦略、および適応型攻撃の条件下で、安全性の挙動がどのように変化するかを調査しました。最近のGPT系モデル4種類について、我々の結果は示しています

Do AI-for-Science Agents Preserve Model Safety?
経緯と関連報道

MXFP4でMoE型LLMをトレーニング:BF16との差をいかに埋めたか

arXiv:2610.32229v1 発表タイプ:新規 要旨:8ビット未満の演算で大規模言語モデル(LLM)を訓練することは、メモリ帯域幅と計算スループットの大幅な向上を約束する一方で、FP4フォーマットでは、適切に対処しなければ最適化を不安定にするほど深刻な量子化誤差が生じます。本稿では、MXFP4マイクロスケーリングフォーマット下のMLPerf Small MoE Trainingベンチマークにおいて、200億パラメータを持つ混合専門家モデル(MoE)であるGPT-OSS-20B向けのオープンソース訓練レシピALTOを提案します。このレシピは、Abecassis、Felixらによる[arXiv:2509.25149]に示された確立された手法(ハイブリッド1D/2Dブロック量子化、ランダム化ハダマード変換、および確率的丸め)に加え、TetraJet-v2[arXiv:2510.27527]から採用した簡略化された重みのデオシレーション手法を組み合わせています。グローバルバッチサイズにおけるC4検証において

経緯と関連報道

EDWARD-NMT:ニューラル機械翻訳における適応型ルーティングと二重一貫性を備えた弾性次元

arXiv:2610.32115v1 発表タイプ:新規 要旨:スパースな専門家混合モデル(MoE)は、ニューラル機械翻訳(NMT)のスケーリングおよび言語の多様性の管理において強力なパラダイムである。しかし、実用上の制約により、リソースが限られたデバイスへの導入は困難である。具体的には、全専門家プールをメモリ上に常駐させる必要があり、さらに各トークンごとの計算リソースは、トレーニング中に厳格なトップ-k ルーティングによって静的に固定されるためである。本研究では、EDWARD-NMT(Elastic Dimensions With Adaptive Routing and Dual-consistency for NMT)を提案する。これは、一度学習させればどこでも展開可能なパラダイムを実現するための新しいMoEエンコーダー・デコーダー構造であり、推論時には複数の展開可能なサブネットワーク群を提供する。EDWARD-NMTは、以下の三つの重要な革新を統合している:(i) マトリョーシカ型の弾性次元を用いてメモリフットプリントを柔軟に削減する手法;(ii) a

経緯と関連報道

クエリの抽象度が古典アラビア詩の検索精度を左右する:BM25と稠密エンコーダーの性能は、クエリの抽象度に応じて顕著に分かれる

2026年10月26日付のarXivに掲載された最新の研究(arXiv:2610.31821v1)によれば、古典アラビア詩の検索タスクにおいては、ユーザーの詩句の記憶残存度(例えば半行を覚えているかどうか)が、モデルの性能よりも検索精度を決定する上でより重要な要因であることが示されています。BM25は、「舌尖効果」系のクエリでは、8Bパラメータの最先端モデルを含むすべての稠密符号化器を上回る一方で、抽象的なクエリでは大きく劣後することが明らかになりました。

新闻源配图 · arXiv cs.CL

注目する理由:本研究は、二重コーパス、三重インデックス方式、および二重評価プロトコルによる体系的なベンチマークテストを通じて、クエリの抽象度が異なる検索パラダイム(形態素ベース対稠密ベクトル)に与える支配的な影響を初めて定量的に明らかにし、人間のアノテーターとオープンソースの重み付けモデルによる二重検証を経て、その結論は方法論的普遍性と実証的堅牢性を備えている。

経緯と関連報道

コリブリ:パレート最適境界上の主権を持つ欧州モデル

arXiv:2610.31945v1 公告タイプ:新規 要旨:本報告書では、Apache 2.0ライセンスの下でオープンウェイトとして公開された、総パラメータ数781億、トークンあたり有効パラメータ数34.6億の英語–ドイツ語混合専門家型トランスフォーマーであるKolibriを紹介します。Kolibriは主権的かつ専門的な展開を想定して構築されており、特にドイツ語および公共行政、産業、航空宇宙といった規制対象分野に重点を置いています。これらの環境に対応するため、データ、アーキテクチャ、学習インフラ、学習後の処理、評価に至るまで、モデル開発の全プロセスを自社で管理しています。Kolibriは、事前学習、中間学習、長文コンテキスト拡張の各段階にわたり、合計24Tトークンを用いて学習を行っており、データ構成においてドイツ語がバイト数ベースで20%以上を占めています。この割合を達成するため、ドイツ語データセットを補完する形で

経緯と関連報道

LLM評価において、全体のF1スコアのみで自動採点システムを検証することは誤解を招くリスクがある:新たな研究は、具体的なプロンプト間の差異を考慮した検証の必要性を強調している

arXiv論文(2610.31678v1)は、対話型の大規模言語モデルの評価において、自動スコアラーの全体的な正答率やF1スコアだけに依存すると、プロンプト固有の誤りが隠れてしまい、プロンプト効果の誤った判断につながると指摘している。実証結果では、同一のスコアラーでも異なるプロンプト条件下で偽陽性率に大きな差(2.6%~33.3%)が生じ、表面的には有意と見られる9.3ポイントの効果も、二重のLLMによるレビュー下では2.3ポイントに縮小し、統計的に有意ではなくなった。

Validating the Comparison, Not Just the Scorer: Why Overall Accuracy Can Mislead in Interactive LLM Evaluation

注目する理由:本研究は、実際の実験データ(6つのモデル、180個の架空のエンティティに関する質問、6種類のプロンプト条件)に基づき、現在のLLM評価において広く見られる方法論上の欠陥——すなわち、スコアラーの全体的な性能を重要な比較タスクにおける信頼性と同一視する——を明らかにしています。その核心的な主張(各プロンプトを個別に検証し、不確実性を考慮に入れる必要がある)は、明確な実証的根拠と実践的な提言に裏打ちされており、発表日(2026年10月26日)も新鮮で、出典も信頼できるarXivプレプリントプラットフォームです。

経緯と関連報道

Behaviour analysis for large language model-driven agents

arXiv:2610.32087v1 Announce Type: new Abstract: Understanding language-agent behaviour requires learning how actions are organised across a trajectory and how this organisation relates to context and outcomes. We propose a general framework that connects data-driven behavioural discovery with analysis and experimental investigation. Categories developed from recorded activity define what is measured. Analyses preserve the behaviours' positions in the process and express their relationships as interpretable hypotheses. Statistical assessment and tests in held-out contexts examine the strength and scope of the evidence. Experiments, including prompt steering, then test how behaviour and outcomes change under deliberately varied conditions. A study of iterative self-reflection illustrates how

翻訳待ち・原文を表示中 · en
経緯と関連報道

エッジによるLLMトレーニングの民主化:課題、システム、そして今後の展望

arXiv:2610.32215v1 発表タイプ:新規 要旨:現代のGPUデータセンターにおける計算能力の向上により、一部の産業界の大手企業が膨大なデータを用いて大規模言語モデル(LLMs)の学習および展開を行うことができるようになりました。しかし、これらのモデルとその学習データの圧倒的な規模は、集中型の開発体制を維持することをますます困難にするとともに、関連するプライベートデータを保有しながらも同等のインフラを備えない小規模な機関を排除しています。本論文では、分散型LLM学習に関する当該分野の立場を、事前学習および微調整のパラダイムを中心に整理し、フェデレーテッド学習、スプリット学習、そして分散型アプローチを取り上げ、それらが異種ハードウェアや信頼性の低い接続環境といった地理的に分散した設定においてどの程度実用可能かを評価します。さらに、我々は「統一された」システムを提案します…

Democratizing LLM Training with the Edge: Challenges, Systems, and the Road Ahead
経緯と関連報道

新たな研究により、LLMによる数学指導の評価に深刻な測定バイアスが存在することが明らかになった:正確一致型の採点では、効果が実際よりも約40ポイントも過小評価されることが示された

arXivで2026年10月26日に公開された論文「MisconceptDialogue: Evaluation Criteria Shape Measured Success in LLM Math Tutoring」は、MISCONCEPTDIALOGUEという自動評価フレームワークを提案し、5,000回超の対話に基づいて、数学チューターとしての性能を評価するため、7B~14B規模のオープンソース小パラメータLLM 5種類をテストしました。研究結果によると、主流の正確一致(exact-match)評価手法では救済成功率が42.1%にとどまる一方で、人間による校正を経たLLM審判による同一対話の評価では81.3%に達し、その差は39.2ポイントに上りました。しかもこの偏差は偶然によるものではなく、4種類のLLM審判と200件の人工ラベル付け結果との間で高い一致性が確認され(kappa値は最大0.91)、さらにモデルは診断情報(正しい/誤った概念)に対する応答にほとんど差がないことから、診断入力を有効に活用できないことが示されました。

MisconceptDialogue: Evaluation Criteria Shape Measured Success in LLM Math Tutoring

注目する理由:本研究は、現在のLLM教育応用における評価手法の根本的な欠陥を明確に指摘している。すなわち、単一で硬直的な自動採点に依存することは、実際の能力評価を大きく歪めてしまうおそれがあることである。さらに、大規模なシミュレーション実験の設計、複数の評価者による収束検証、ならびに診断と指導の連携の不備に関する実証を通じて、AI教育評価の標準化に向けて重要な警鐘と再現可能な方法論的基準を提示している。

経緯と関連報道

研究では、「図式整合性尺度」(SCI)を提案し、言語モデルの信念の組織性を評価した。

2026年10月26日、arXivは論文arXiv:2610.31683v1を公開し、Schema Coherence Inventory(SCI)——すなわち96項目からなる強制選択型尺度——を提案した。これは、ペルソナ条件付き言語モデルに付与された信念が、単に感情的反応を引き起こすだけでなく、実際にその認知を組織化しているかどうかを検証するためのものである。

The Schema Coherence Inventory: Measuring Whether an Assigned Belief Organizes a Language Model's Cognition

注目する理由:本研究は、言語モデルの「信念内化の程度」について、現状では検証可能な測定手法が欠如しているという空白を埋めました。臨床専門家による検証、複数のモデルベースのテスト、および目的特異的な評価基準の設計を通じて、感情的表象ではなく認知構造に焦点を当てた初の評価フレームワークを提供し、すべてのツールをオープンソースとして公開しています。

経緯と関連報道

AIによるダブル11の謎めいた状況:業者はすでに支払い済み、ユーザーはただ羊毛を手に入れるだけ

2026年のダブル11期間において、AIの商用化は顕著な二極化を示している。企業側(例:Qwen Office E-commerce Edition)ではすでに有料導入が実現しており、有料ユーザーの20%がEC業界に属する。一方、消費者側では、豆包やQwenなどの配信チャネルによる補助金施策によって注文が促進されており、価格差は37.5%に達するものの、ユーザーの信頼度は低く(AIが商品を正確にマッチングできると考えるユーザーはわずか16.06%)、AIによるショッピングアドバイザーは依然として従来の意思決定プロセスを本格的に置き換えるには至っていない。

注目する理由:本稿の素材は、钛媒体が2026年10月26日に公開した深層報道に基づいており、AIがダブル11において展開した三つのタイプの実践を体系的に整理しています。①AIによるショッピングアドバイスが取引プロセスへ浸透(豆包/通義千問が注文・決済を支援);②トークンサービスが天猫および京東に上架(初日売上高は前日比で450%増加したものの、販売量は依然として初期段階);③マーチャント向けツールが先行して収益化(通義千問によるオフィス業務のコスト削減事例が明確に示され、アリババ系の経営システムへの連携も進んでいる)。すべての事実は、文中で明示された時期・データ・情報源に基づくものであり、外部からの推論は一切含まれていません。

経緯と関連報道

Nanbeigeが、33B規模のオープンなエージェント型コーディングモデルであるNanbeige4.3-33Bをリリースしました

Nanbeige LLM Labは、512Kのコンテキストを持つ33B規模のApache 2.0ライセンスの密集型モデルであるNanbeige4.3-33Bを公開しました。同モデルはTerminal-Bench 2.1において80.9点を記録しており、今後リリース予定のNanbeige4.3-3Bを学習させることになります。この記事「Nanbeigeが33B規模のオープン・アジェンティック・コーディングモデルNanbeige4.3-33Bを公開」は、MarkTechPostに最初に掲載されました。

Nanbeige Releases Nanbeige4.3-33B, a 33B Open Agentic Coding Model
経緯と関連報道

Hugging Faceが、DNAと自然言語を初めて統合した140億パラメータのオープンなDNA言語モデル「Carbon-X」をリリース

Hugging Faceは、Qwen3-14Bを基盤としたオープンな148億パラメータのDNA言語モデル「Carbon-X」をリリースしました。このモデルは、チャットで生のDNAを読み取り、英語で回答を生成し、Apache 2.0ライセンスの下で5つのDNAベンチマークにおいて平均66.7%の性能を示します。記事「Hugging Face、DNAと自然言語を初めて統合した140億パラメータのオープンDNA言語モデル『Carbon-X』をリリース」は、MarkTechPostに初出しました。

Hugging Face Releases Carbon-X, a 14B Open DNA Language Model that Brings DNA and Natural Language Together for the First Time
経緯と関連報道

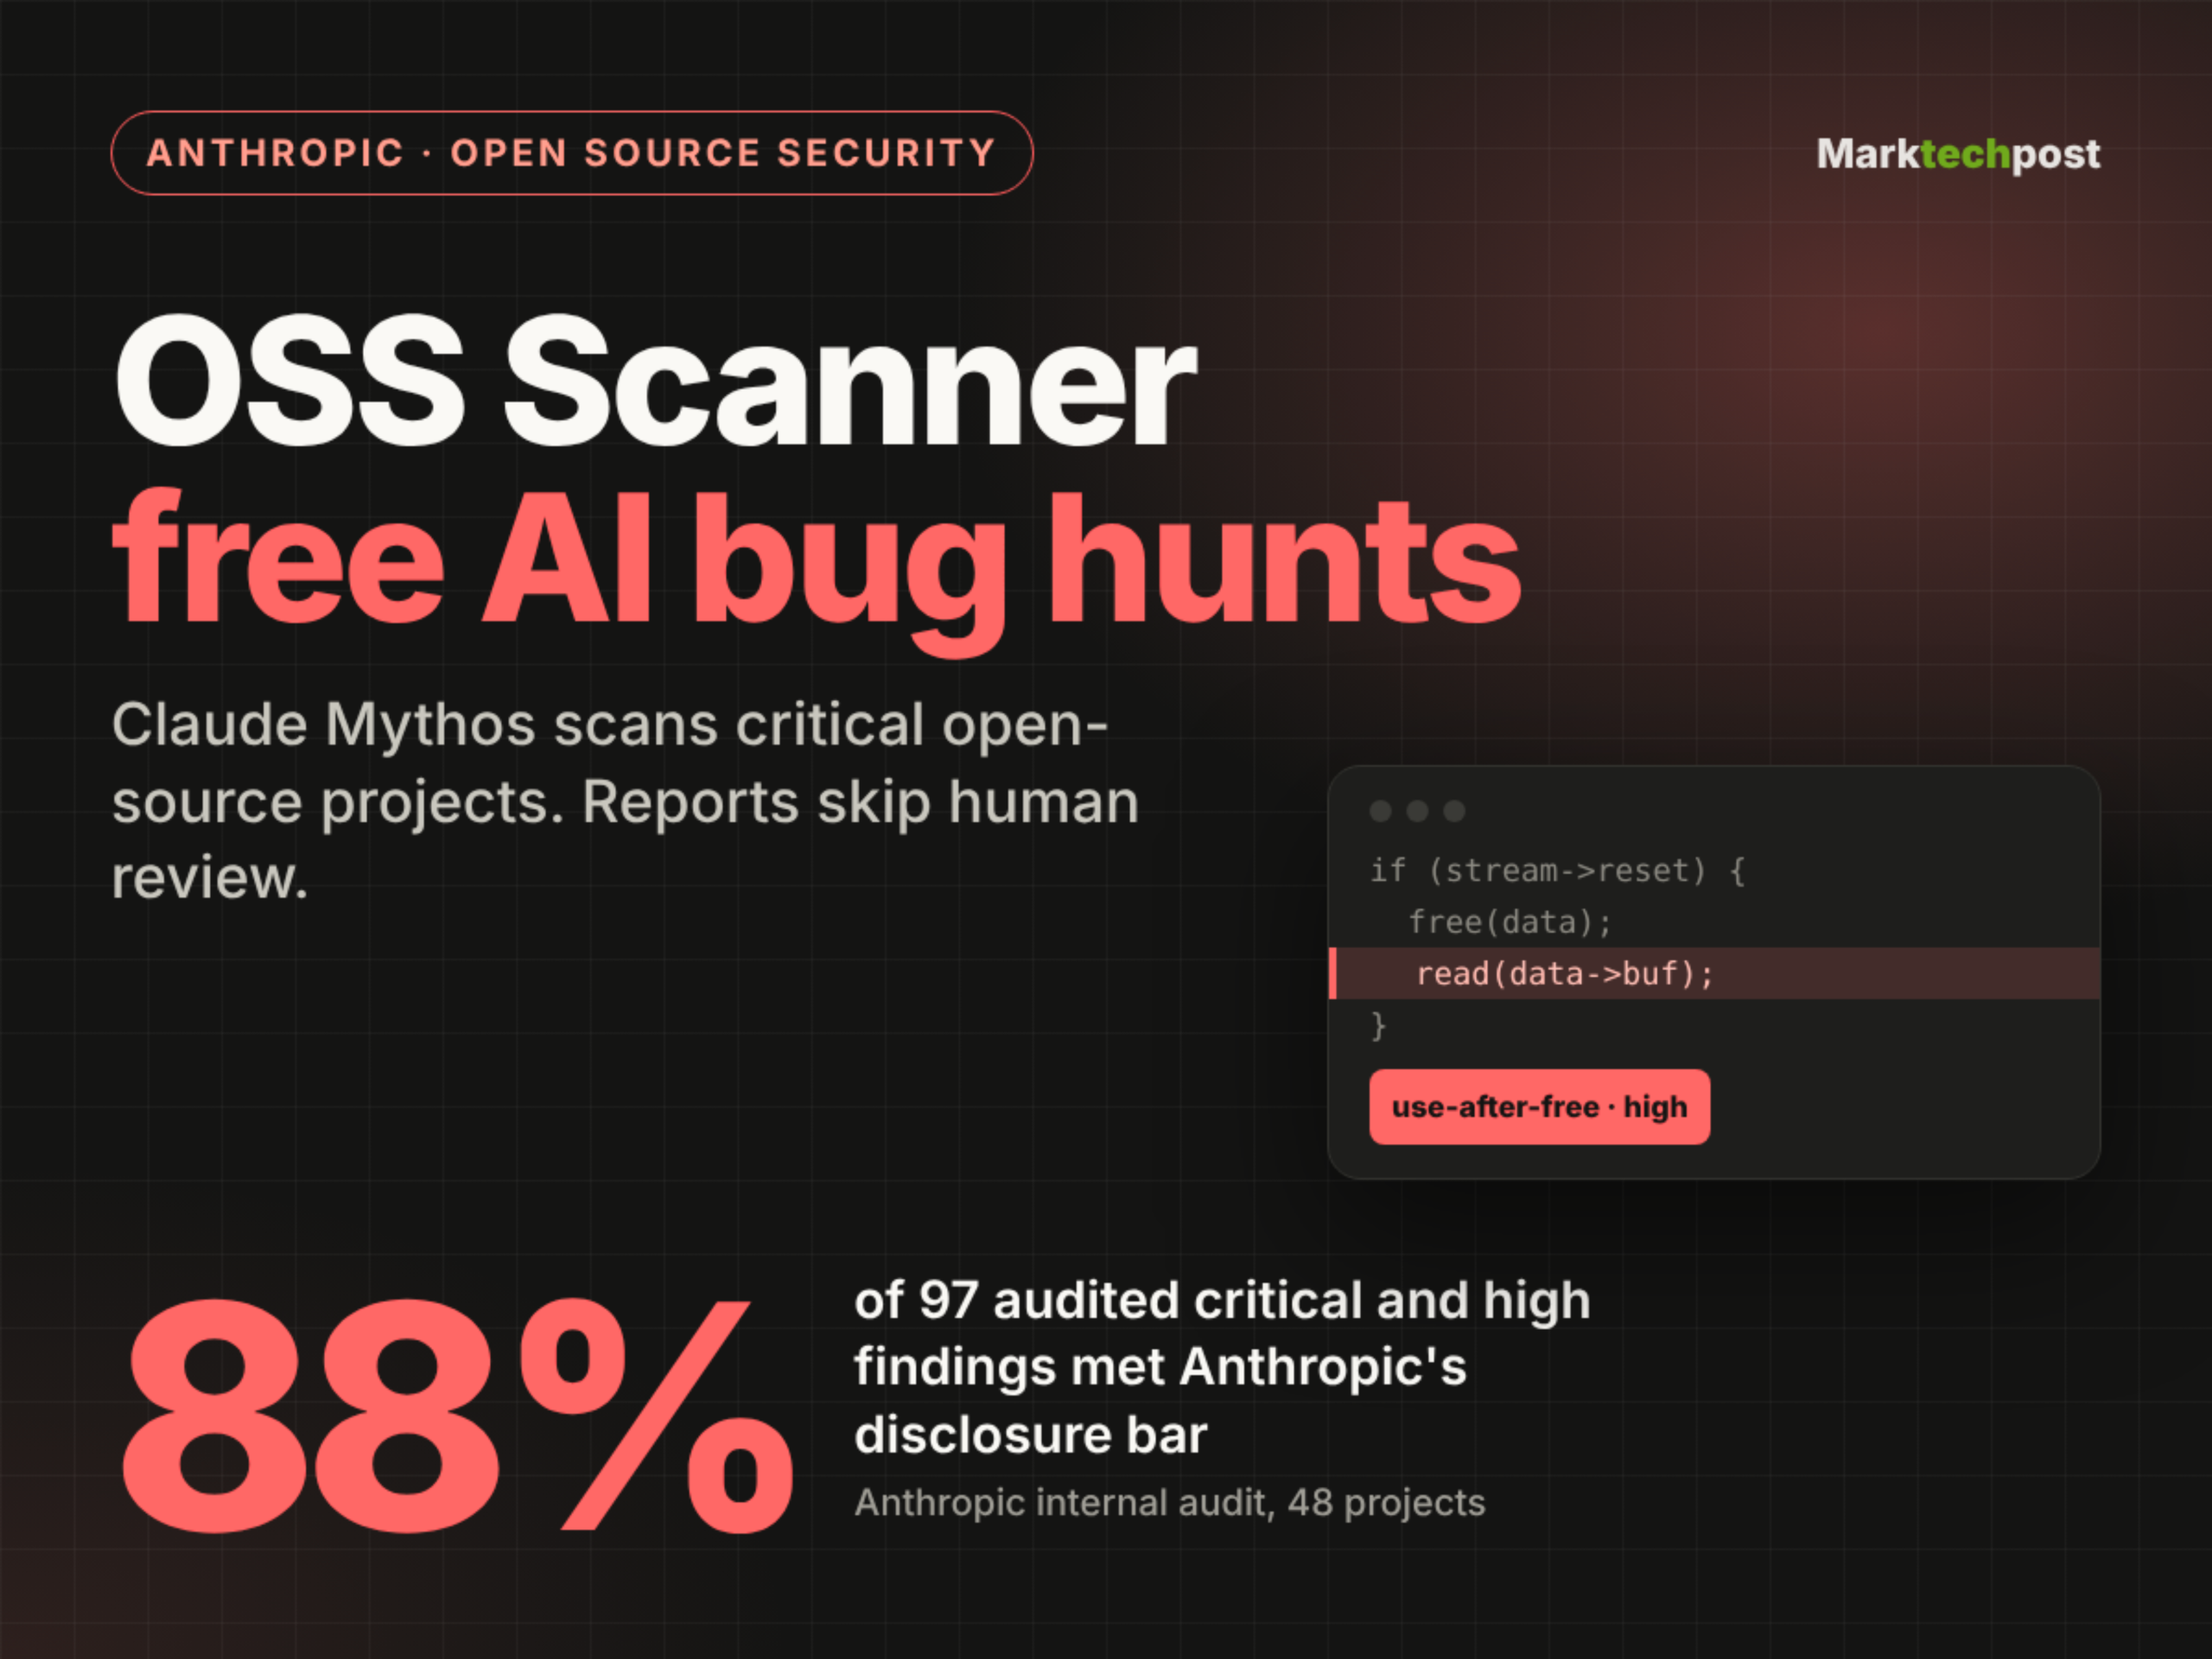
Anthropicが、主要なオープンソースプロジェクト向けの無料AI脆弱性スキャナー「OSS Scanner」を発表しました

Anthropicは2026年10月8日、Claude Mythosなどの強力なモデルを基にした無料でオプトイン型のAI脆弱性スキャンツール「OSS Scanner」をリリースし、重要なオープンソースプロジェクト向けに設計しました。10月19日時点で、114のプロジェクトが受け入れられ、11日間で深刻度レベル77件および高リスクレベル803件の脆弱性(モデルによる評価)が報告され、サンプリングされた監査結果の88%が同社の開示基準に適合していることが確認されました。

Anthropic Launches OSS Scanner, a Free AI Vulnerability Scanner

注目する理由:このツールは、オープンソースセキュリティ分野におけるLLMの大規模な実装事例を示しており、無償・完全自動・オフラインでの監査を特徴としています。ただし、人手によるレビュー工程を省略することで、誤検知や重複する問題が生じるリスクも伴います。その精度データ(有効率88%、偽陽性率1%)および実際のプロジェクトからのフィードバック(wolfSSLやcurlなど)は、現在のAI主導型脆弱性発見能力に関する実証的なベンチマークを提供しています。

経緯と関連報道

月之暗面发布Kimi K3.1 Pro:2.8万亿参数开源权重模型,11月4日开放权重

月之暗面于2026年10月22日前后发布Kimi K3.1 Pro,一款2.8万亿参数、1040亿激活参数的多模态MoE模型,宣称性能逼近Fable 5.1;官方承诺11月4日发布开源权重,但截至报道时权重尚未公开;独立评测显示其在智能指数、代码与网络安全基准中表现突出,但存在推理成本、本地部署可行性及营销透明度等争议。

[AINews] Kimi 3.1 Pro 104BA-2.8T: Fable-5.1-Class Open Weights narrows Closed-AI lead to 1 month... and Pro Highspeed API with 2-3× speed
経緯と関連報道

TRIADが発表:全モーダルな曖昧さ解消に特化した初の多モーダル大規模モデル評価基準

2026年10月24日、研究者はarXivに論文arXiv:2610.30841v1を公開し、テキスト・画像・音声の三モーダルな協調による曖昧さ解消能力を評価するための新たな評価フレームワークであるTRIADベンチマークを正式に発表しました。このベンチマークは、手作業で構築された327件の三モーダルサンプルを含み、86のシナリオグループと18種類の跨モーダルな曖昧さのタイプを網羅しています。

TRIAD: Benchmarking Omni-Modal Ambiguity in Multimodal Large Language Models

注目する理由:この成果は、現在の多モーダル大規模モデル評価における核心的な盲点を直接突いています。すなわち、既存のベンチマークでは、多焦点かつ確定的な入力条件下での知覚や推論にのみ注目しているのに対し、TRIADは初めて「モーダル補完による曖昧さ解消」を評価目標として体系的に設定しました。厳密に設計された留一モーダル反事実テストを通じて、モデルが特に音声に対して十分に活用されていないことや、シーンレベルでのロバスト性が脆弱であるといった重要な欠陥を明らかにし、次世代の全モーダルモデル評価に向けて再現可能な診断プロトコルと分類法を提供しています。

経緯と関連報道

研究により、大規模言語モデルにおける多文化価値選択のバイアスが明らかにされた:国と言語の手がかりは相互に置き換えられない

2026年10月24日付のarXivプラットフォームに掲載された研究(番号2610.31199v1)は、大規模言語モデル(LLMs)が国家的アイデンティティ(システムプロンプトによる設定)と第二の文化的手がかり(明示的に国名を指定するか、暗黙的に問い合わせ言語を使用する)の両方を同時に受け取る場合、これら二種類の手がかりが価値判断に与える影響は著しく異なることを明らかにした。すなわち、言語的手がかりはより強力だが方向性が逆のバイアスを引き起こす一方で、明示的な国名指定は影響は弱いものの、より分極化し、対象国の価値観により近い価値変化をもたらすことが示された。

Investigating Multi-Cultural Value Selection Biases in LLMs

注目する理由:本研究は、160万件のオープン生成応答とWorld Values Survey(WVS)による標準化テストを基に、文化モデリングにおける明示的な国家ラベルと暗黙的な言語手がかりの役割を初めて体系的に区別し、両者を同一視して扱うことがLLMの文化適応能力の評価を歪めてしまうことを指摘しています。この結果は方法論的に重要な示唆を含んでおり、公開日は現在の日付(2026年10月26日)より前であることから、有効な新知見です。

経緯と関連報道