跳到正文
AI NEWS JOURNAL
AI, IN PERSPECTIVE

搜索 AI 资讯

检索标题、摘要与正文,把分散的信息连起来。

按发布时间排序

b11918

opencl:首次支持 q3_k (#31172) * opencl:添加 q3_k AOS 移动 * opencl:添加 q3_k SOA 移动及分块矩阵乘法 * opencl:为 adreno 添加 q3_k 无混洗 gemm/gemv * opencl:为 adreno 添加 q3_k dp4a gemm 共同作者:王洪强 * opencl:针对 adreno 调优 q3_k 内核 共同作者:王洪强 --------- 共同作者:王洪强 **网站:** - **证明文件:** - **macOS/iOS:** - [macOS 苹果芯片(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b11918/llama-b11918-bin-macos-arm64.tar.gz) - macOS 苹果芯片(arm64,启用 KleidiAI)[已禁用](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS 英特尔(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b11918/llama-b11918-bin-macos-x64.tar.gz) - [iOS XCFramework](https://github.com/ggml-org/ll)

事件进展与其他报道

把15个国民级App接入灵光后,我造出了最舒适的国产Personal Agent

自从拿到蚂蚁灵光2.0这个Personal Agent的内测,它已经成为我的私人管家了。到现在,我已经通过Skill、MCP、GitHub项目或者内置的方式,把15个国民级App都接进去了。基本上我打开「帮我管」那一栏里,定时任务里会定时刷新值得关注的信息。灵光不是我用的第一个Personal Agent,前前后后一共测了12个,测到后面,我越来越觉...

把15个国民级App接入灵光后,我造出了最舒适的国产Personal Agent
事件进展与其他报道

vLLM 语义路由器发布 d3-ultra:一款 270 亿参数的开源多模态决策模型

vLLM 语义路由器发布了 d3-ultra,一款拥有 270 亿参数的开源多模态决策模型。它能够一次性读取文本、图像和视频,并为每个可能的答案返回概率,在该团队的 SR-Text 测试中取得了 87.2 分。原文“vLLM 语义路由器发布 d3-ultra:一款 270 亿参数的开源多模态决策模型”首发于 MarkTechPost。

新闻源配图 · MarkTechPost
事件进展与其他报道

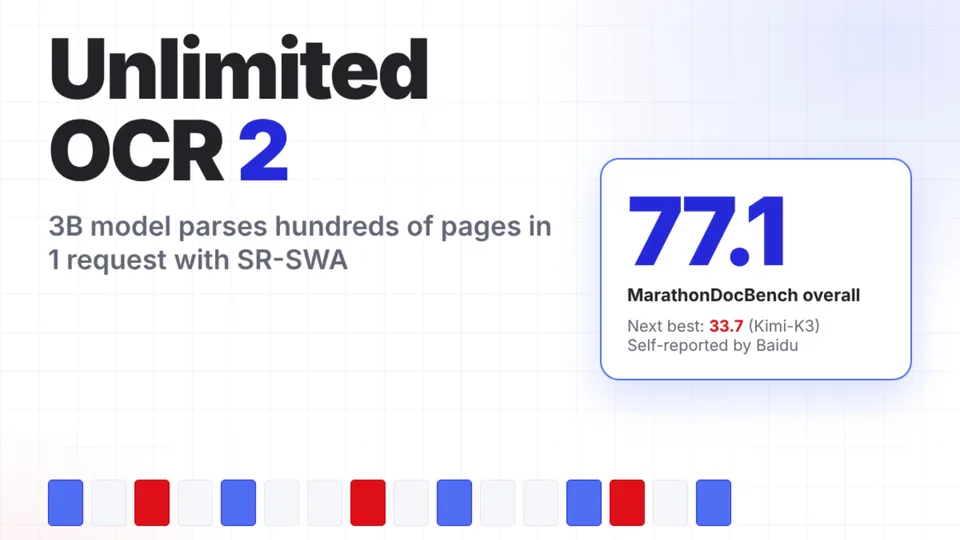
百度开源无限OCR 2,用于百页文档解析

百度发布了 Unlimited OCR 2,这是一款采用 MIT 许可证的 3B 参数规模的 OCR 模型,能够在一次请求中解析百页文档。其 SR-SWA 注意力机制使每步解码开销几乎保持不变,在 MarathonDocBench 上取得了 77.1 的得分。该文章《百度开源 Unlimited OCR 2,用于百页文档解析》首发于 MarkTechPost。

新闻源配图 · MarkTechPost
事件进展与其他报道

思科合作伙伴峰会:五大洞见将定义人工智能时代的渠道格局

在其30年的历史中,思科合作伙伴峰会大多聚焦于合作伙伴如何销售思科系统公司的技术。而今年在温哥华举行的这场盛会则着眼于一个全新的议题:在交易已不再是核心环节的当下,合作伙伴该如何实现盈利。思科携强劲势头亮相此次盛会,其股价正处于[…]。文章《思科合作伙伴峰会:五大洞见将定义AI时代的渠道生态》首发于SiliconANGLE。

事件进展与其他报道

GPT-6.1 Terra发布,评论区:拉完了

在Anthropic正式公开提交IPO招股书的同一天,OpenAI发布了新模型GPT-6.1 Terra。这是Terra系列时隔三个多月的首次更新,距离9月29日GPT-6.1 Sol发布也已经过去了27天。OpenAI在官方宣传中着重强调:“以更低的价格,提供快速且强大的电脑操作能力。”但网友们似乎并不买账。“老兄,我们需要的是比Opus 5.5更强的模型。没人关心它是不是更快、更便宜。”这位网友毫不客气地表示,自己已经几乎不再使用Codex订阅服务,因为它实在没什么用处了。过去一段时间,Anthropic凭借Claude Opus 5.5在编程等领域赢得了大量关注。不少用户都在期待Open...

GPT-6.1 Terra发布,评论区:拉完了
事件进展与其他报道

ProtoEEG:用于脑电图视觉解码的结构化原型对齐

arXiv:2610.33065v1 发布类型:新 摘要:由于头皮记录存在噪声、空间分辨率较低,且在不同试验和受试者之间具有较大差异,脑电图(EEG)的视觉解码仍然十分困难。大多数系统将每次试验与一个密集的图像嵌入对齐,然而该嵌入同时混杂了语义内容以及与具体实例相关的纹理、姿态和背景信息。这种做法往往需要EEG本身并不具备的细节信息,且未能明确说明支持预测的视觉因素。我们提出\textbf{ProtoEEG},一种基于原型的框架,它将EEG与图像的对齐问题重新表述为在共享的可学习视觉码本之上进行软性组合。一个可训练的EEG编码器与一个冻结的视觉教师共同生成针对同一$K=64$个原型的分配分布。它们的加权重构构成了一种结构化的表征

事件进展与其他报道

雅可比透镜的数学理论

arXiv:2610.31955v1 发布类型:新 提要:Anthropic 的最新研究提出了一种名为“雅可比透镜”(J-lens,Gurnee 等人,2026)的新可解释性工具。该方法在前沿语言模型的隐藏状态中识别出一些线性方向,这些方向表现出类似工作记忆表征的特性。然而,尚不清楚究竟是哪些机制特性使这类特征能够被 J-lens 检测到。为此,我们提出了 J-lens 的数学理论,并证明它倾向于识别相干特征——即那些类似于主导、在空间上具有连贯性的李雅普诺夫模态的方向。沿着这些方向施加微小扰动时,其放大效应会逐层传递,在各个标记位置大致保持不变,并且在不同上下文中也具有一致性。尽管 w

新闻源配图 · arXiv cs.LG
事件进展与其他报道

MANTA:在异步BFT中解锁DAG的灵活性

arXiv:2610.34419v1 发布类型:新 摘要:基于有向无环图(DAG)的拜占庭容错(BFT)协议通过用并行的区块提案取代单主节点的提案路径,并借助共享图结构将这些提案相互连接,从而在共识设计上实现了重大转变;其中,引用机制用于编码共识证据。然而,在异构广域网(WAN)环境下,现有方案由于拖后腿效应而面临轮次延长和性能下降的问题。其根本原因在于僵化的轮次推进机制:各副本以同步的方式按固定轮次推进,必须等待前一轮中足够多的引用后才能继续前进。我们提出了一种适用于异步BFT共识的灵活DAG扩展框架。我们的关键观察是:尽管引用法定人数对于安全性和活性至关重要,但并不需要在每一轮推进时都予以阻塞;相反,连通性r

事件进展与其他报道

PRISM:通过隐式随机调制促进大型语言模型的采样多样性

arXiv:2610.32101v1 发布类型:新 摘要:大型语言模型(LLMs)会表现出模式坍缩现象,即其输出分布集中于熟悉的语义模式。当多样性消失时,反复采样便沦为语义上的重复,而非新的发现,导致那些罕见但更优的解决方案难以浮现,从而使模型的自我进化与持续学习难以维持。大多数应对措施仅在推理阶段发挥作用,通过调整采样结果来实现多样性,却并未将多样性真正内化为模型的一项能力。我们提出了 PRISM,一种在训练阶段就将多样性内化的框架。PRISM 结合了:(i) 子模性策展机制,为每个提示配以多样且正确的多教师解;以及 (ii) 随机嵌入调制,将特殊标记的扰动转化为 impl

事件进展与其他报道

TraceQuery:从扩散语言模型的完整去噪轨迹中学习哪些部分需要重新计算

arXiv:2610.33008v1 发布类型:新 摘要:扩散大型语言模型(dLLMs)通过迭代式掩码去噪实现灵活的生成,但由于在每一步去噪过程中都需要反复重新计算标记表示,因此带来了巨大的推理开销。现有的基于缓存的方法通过在各步去噪中复用中间结果,并且仅在每一步重新计算一部分位置来降低这一开销,这些位置要么按固定的时间间隔选择,要么依据变化的启发式信号确定。相比之下,我们的轨迹实验表明,解码轨迹才是更为相关的指标。当缓存生成的结果始终接近完整去噪轨迹时,其准确性依然较高;误差主要集中在未掩码顺序的偏差上,并且随着较长参考前缀的逐步恢复而逐渐减小。这表明

新闻源配图 · arXiv cs.CL
事件进展与其他报道

SLICE-Mem:用于高效LLM智能体记忆的显著性门控轻量级信息策展

arXiv:2610.33015v1 发布类型:新 摘要:长期记忆使大型语言模型(LLM)代理能够维持个性化且时间上连贯的交互,但为实现记忆的接纳、提取与组织而反复调用LLM进行推理,会带来显著的成本与延迟。我们提出了SLICE-Mem,一个轻量级的记忆框架,它将基于显著性引导的接纳与基于谓词的信息提取相结合。一个紧凑的分类器用于识别值得保留的用户发言,而基于语义依赖关系的提取器则将被接纳的发言转化为简洁的记忆条目。这一在线处理流程无需调用生成式LLM,同时跨条目的一致性校验被推迟至离线的整合阶段。我们在Memora和LongMemEval-S的每周子集上,使用8B a对SLICE-Mem进行了评估

事件进展与其他报道

AdaptTok-Indic:面向印度语系的脚本感知自适应分词

arXiv:2610.33017v1 发布类型:新 摘要:在以英语为主语料库上训练的多语言分词器往往会对印度语系语言进行过度切分,导致令牌序列更长,并加剧了不同书写系统之间的分词差异。我们提出了 AdaptTok-Indic,这是一种针对印度语系语言的自适应分词扩展方法,它将 Unicode 规范化的预处理与显式的印度语系连字处理、基于书写系统的路由策略,以及与小型 Transformer 语言模型联合训练的字节级边界预测相结合。在孟加拉语和印地语上进行评估,并额外对古吉拉特语、泰米尔语和泰卢固语进行了测试,AdaptTok-Indic 在令牌生成密度方面优于面向印度语系的基准分词器 SentencePiece BPE,以及独立实现的 MAGNET 式基准。在五项已记录的

事件进展与其他报道

明智地低语:用于ASR微调的智能子集选择

arXiv:2610.32997v1 发布类型:新 摘要:诸如OpenAI的Whisper等自动语音识别(ASR)模型在语音识别质量上已取得显著提升,但微调成本依然高昂,尤其是在拥有大量已转录音频的情况下。这使得许多从业者难以将这些模型适配到新的语言或领域。在本研究中,我们提出了一种基于嵌入的子集选择方法,用于为ASR微调挑选更小规模的训练集。我们利用Whisper的预训练编码器,将每个音频样本映射到一个固定维度的嵌入空间,并采用贪心的k中心算法来选取多样且具代表性的训练数据子集。我们在希伯来语和丹麦语上对该方法进行了评估,结果表明,k中心选择往往能有效

新闻源配图 · arXiv cs.CL
事件进展与其他报道

OpenESM:能量引导模型具有可扩展性,是基础学习者

arXiv:2610.33005v1 发布类型:新 摘要:基于能量的模型在特定领域任务中表现出良好的性能,但在建模通用场景时仍面临挑战。为弥合这一差距,我们设计了用于基础语言建模的能量引导模型(ESMs)。ESMs 将能量引导与标记生成整合于同一架构之中,利用能量引导的搜索来优化标记生成。具体而言,ESMs 首先在能量景观上优化潜在状态,随后基于优化后的潜在状态进行标记生成。通过在大规模语料库上开展此类能量引导的预训练,ESMs 学习到一种普遍有效的能量景观,其中有利的标记对应较低的能量值。为探究 ESMs 的规模扩展特性,我们对 ESM 进行了预训练

新闻源配图 · arXiv cs.CL
事件进展与其他报道

神经网络矿井中的金丝雀:捕捉图像分类器的无声而自信的失误

arXiv:2610.33063v1 发布类型:新 摘要:部署后的视觉模型会自动接受置信度较高的预测,因此高置信度错误会在不知不觉中传播。作为标准的故障预测指标,最大 softmax 概率(MSP)存在一个结构性盲点:作为一种从分类器头部读取的标量,它对与其置信度梯度正交的特征变化在一阶上是“视而不见”的。通过对特征空间检测器进行因子分析,我们发现了一条条件冗余原则,用以解释为何这些检测器无法有效补充 MSP:它们所衡量的类别可分性几何结构实际上早已被编码在 MSP 中,并且在融合后会完全失效。最终幸存下来的信号,是位于流形外残差上的类别条件典型性——而由于这一残差的分布因骨干网络的不同而异,从接近高斯分布到重尾分布不等。

事件进展与其他报道

EKT路由器:面向具身视觉-语言模型的专家证据对齐

arXiv:2610.33044v1 发布类型:新 摘要:具身视觉-语言模型必须根据部分且不断变化的观测结果来回答问题。其成功既取决于所选用的推理能力,也取决于该能力所能获取的证据。专家路由器通过调整内部计算来应对,而工具增强型系统则通过获取外部证据来弥补;若单独选择其中一种方式,可能会导致合适的专家缺乏其所需的证据。我们提出了 EKT-Router,这是一种有限框架,能够同时选择合适的推理能力专家、可选的知识以及感知工具。基于结果的特征表示了通用推理、空间推理与时空推理专家之间的优势互补。一个联合效用函数在调用预算范围内对完整的专家—证据路径进行评分。获取完成后,数据包验证器会确认有效数据包

新闻源配图 · arXiv cs.CV
事件进展与其他报道

ReMedI:用于可控分子优化的推理阶段精化与自蒸馏

arXiv:2610.32103v1 发布类型:新 摘要:在药物研发中,先导化合物的优化需要同时提升各项性能指标,例如提高渗透性并降低毒性,同时尽量减少骨架结构的改动,以免影响化合物的活性。基于强化学习的后训练方法,如 C-MORAL,通过微调分子语言模型,直接针对目标优化分子先导化合物,但这种方法依赖于昂贵的任务特定数据集,并且在实现多目标优化(MOO)方面面临诸多挑战。我们认为,预训练模型可能已经蕴含了有益的分子修饰信息,而零样本生成难以高效地触及这些信息。鉴于零样本生成的搜索能力有限,我们提出了一种高效的 Metropolis-Hastings 搜索策略,以……

事件进展与其他报道