
llama.cpp 发布 b11861 版本:修复 minimax-m3 模型量化缩放张量未传递导致的推理异常
llama.cpp v.b11861 修复了 minimax-m3 模型在 NVFP4/MXFP8 量化下因 scale 张量未注入计算图而导致的权重失真问题,避免‘token soup’与残差淹没;同步提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的多平台二进制构建。
推荐理由:按信源设置仅收录,不参与自动精选
检索标题、摘要与正文,把分散的信息连起来。
llama.cpp v.b11861 修复了 minimax-m3 模型在 NVFP4/MXFP8 量化下因 scale 张量未注入计算图而导致的权重失真问题,避免‘token soup’与残差淹没;同步提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的多平台二进制构建。
推荐理由:按信源设置仅收录,不参与自动精选
TechCrunch于2026年10月25日发布报道,梳理了2023至2026年间多个未能达预期的AI项目,包括Relay、Character.ai、Sora、Humane AI Pin等初创与产品,以及OpenAI、Apple、Microsoft等大厂的失败尝试或重大调整。

推荐理由:该报道为行业级现象性盘点,覆盖范围广、时间跨度清晰(含具体关停/延迟日期),并引用S&P Global Market Intelligence数据佐证企业级AI项目高废弃率(42%),兼具案例细节与结构性分析,具典型参考价值。
乔什·夏皮罗于2026年10月22日签署SB806。条文针对可能使消费者对商品或服务产生虚假认知的AI合成广告,规定披露要求,并列明纯文本等例外。

推荐理由:官方签署记录和议会条文可交叉核验。报道区分签署日期、披露条件及例外,避免将规定概括为所有AI广告均须标注。
我们整理了一份最值得关注的 AI 智能体清单,这些智能体既能作为通用助手,也能专为家庭、旅行和工作场景量身打造。
内容来源:本文内容整理自网络公开资料。责编 | 柒 第 9923 篇深度好文:3242 字 | 14 分钟阅读商业思维笔记君说在DBS(星展银行,新加坡最大的商业银行)亚洲未来论坛上,TikTok CEO周受资和主持人做了一场对话。他不谈模型参数,也不谈算力,反复讲的是三件事:人还能做什么,什么必须交给人,以及怎么才知道AI的边界在哪...
安全研究人员借助AI工具,将已存在多年、曾被认为难以利用的PHP漏洞(统称PHP2Shell)转化为可实际 exploited 的攻击面;漏洞公开数小时内即遭百万次尝试利用,但迄今无成功入侵报告。
推荐理由:该事件首次清晰呈现AI并非凭空创造新漏洞,而是显著降低历史漏洞的利用门槛,凸显AI在攻防两端加速既有安全动态的双重作用,且所有有效发现均依赖人机协同。
Sebastian Raschka于2026年10月24日在Ahead of AI杂志(magazine.sebastianraschka.com)发布一套共八讲、超11小时的Python与PyTorch实操视频课程,系统讲解推理模型的评估、推理时扩展、强化学习(RLVR)与知识蒸馏,基于预训练Qwen3-0.6B模型实现全部方法。
推荐理由:该课程是作者继《从零构建大语言模型》后推出的进阶技术教育内容,聚焦当前主流LLM的核心演进方向——推理能力增强,覆盖从基础环境搭建到GRPO强化学习、自蒸馏等完整技术链,且明确声明所有实现均‘从零手写’、可复现,具备强教学性与工程参考价值。
Anthropic于2026年10月24日开源sandbox-runtime(srt),一款不依赖容器的OS级沙箱工具,用于限制AI代理、MCP服务器及CLI工具的文件读写与网络访问权限;支持macOS(Seatbelt)、Linux(bubblewrap)及Windows(alpha),npm包v0.0.81,Apache-2.0许可。
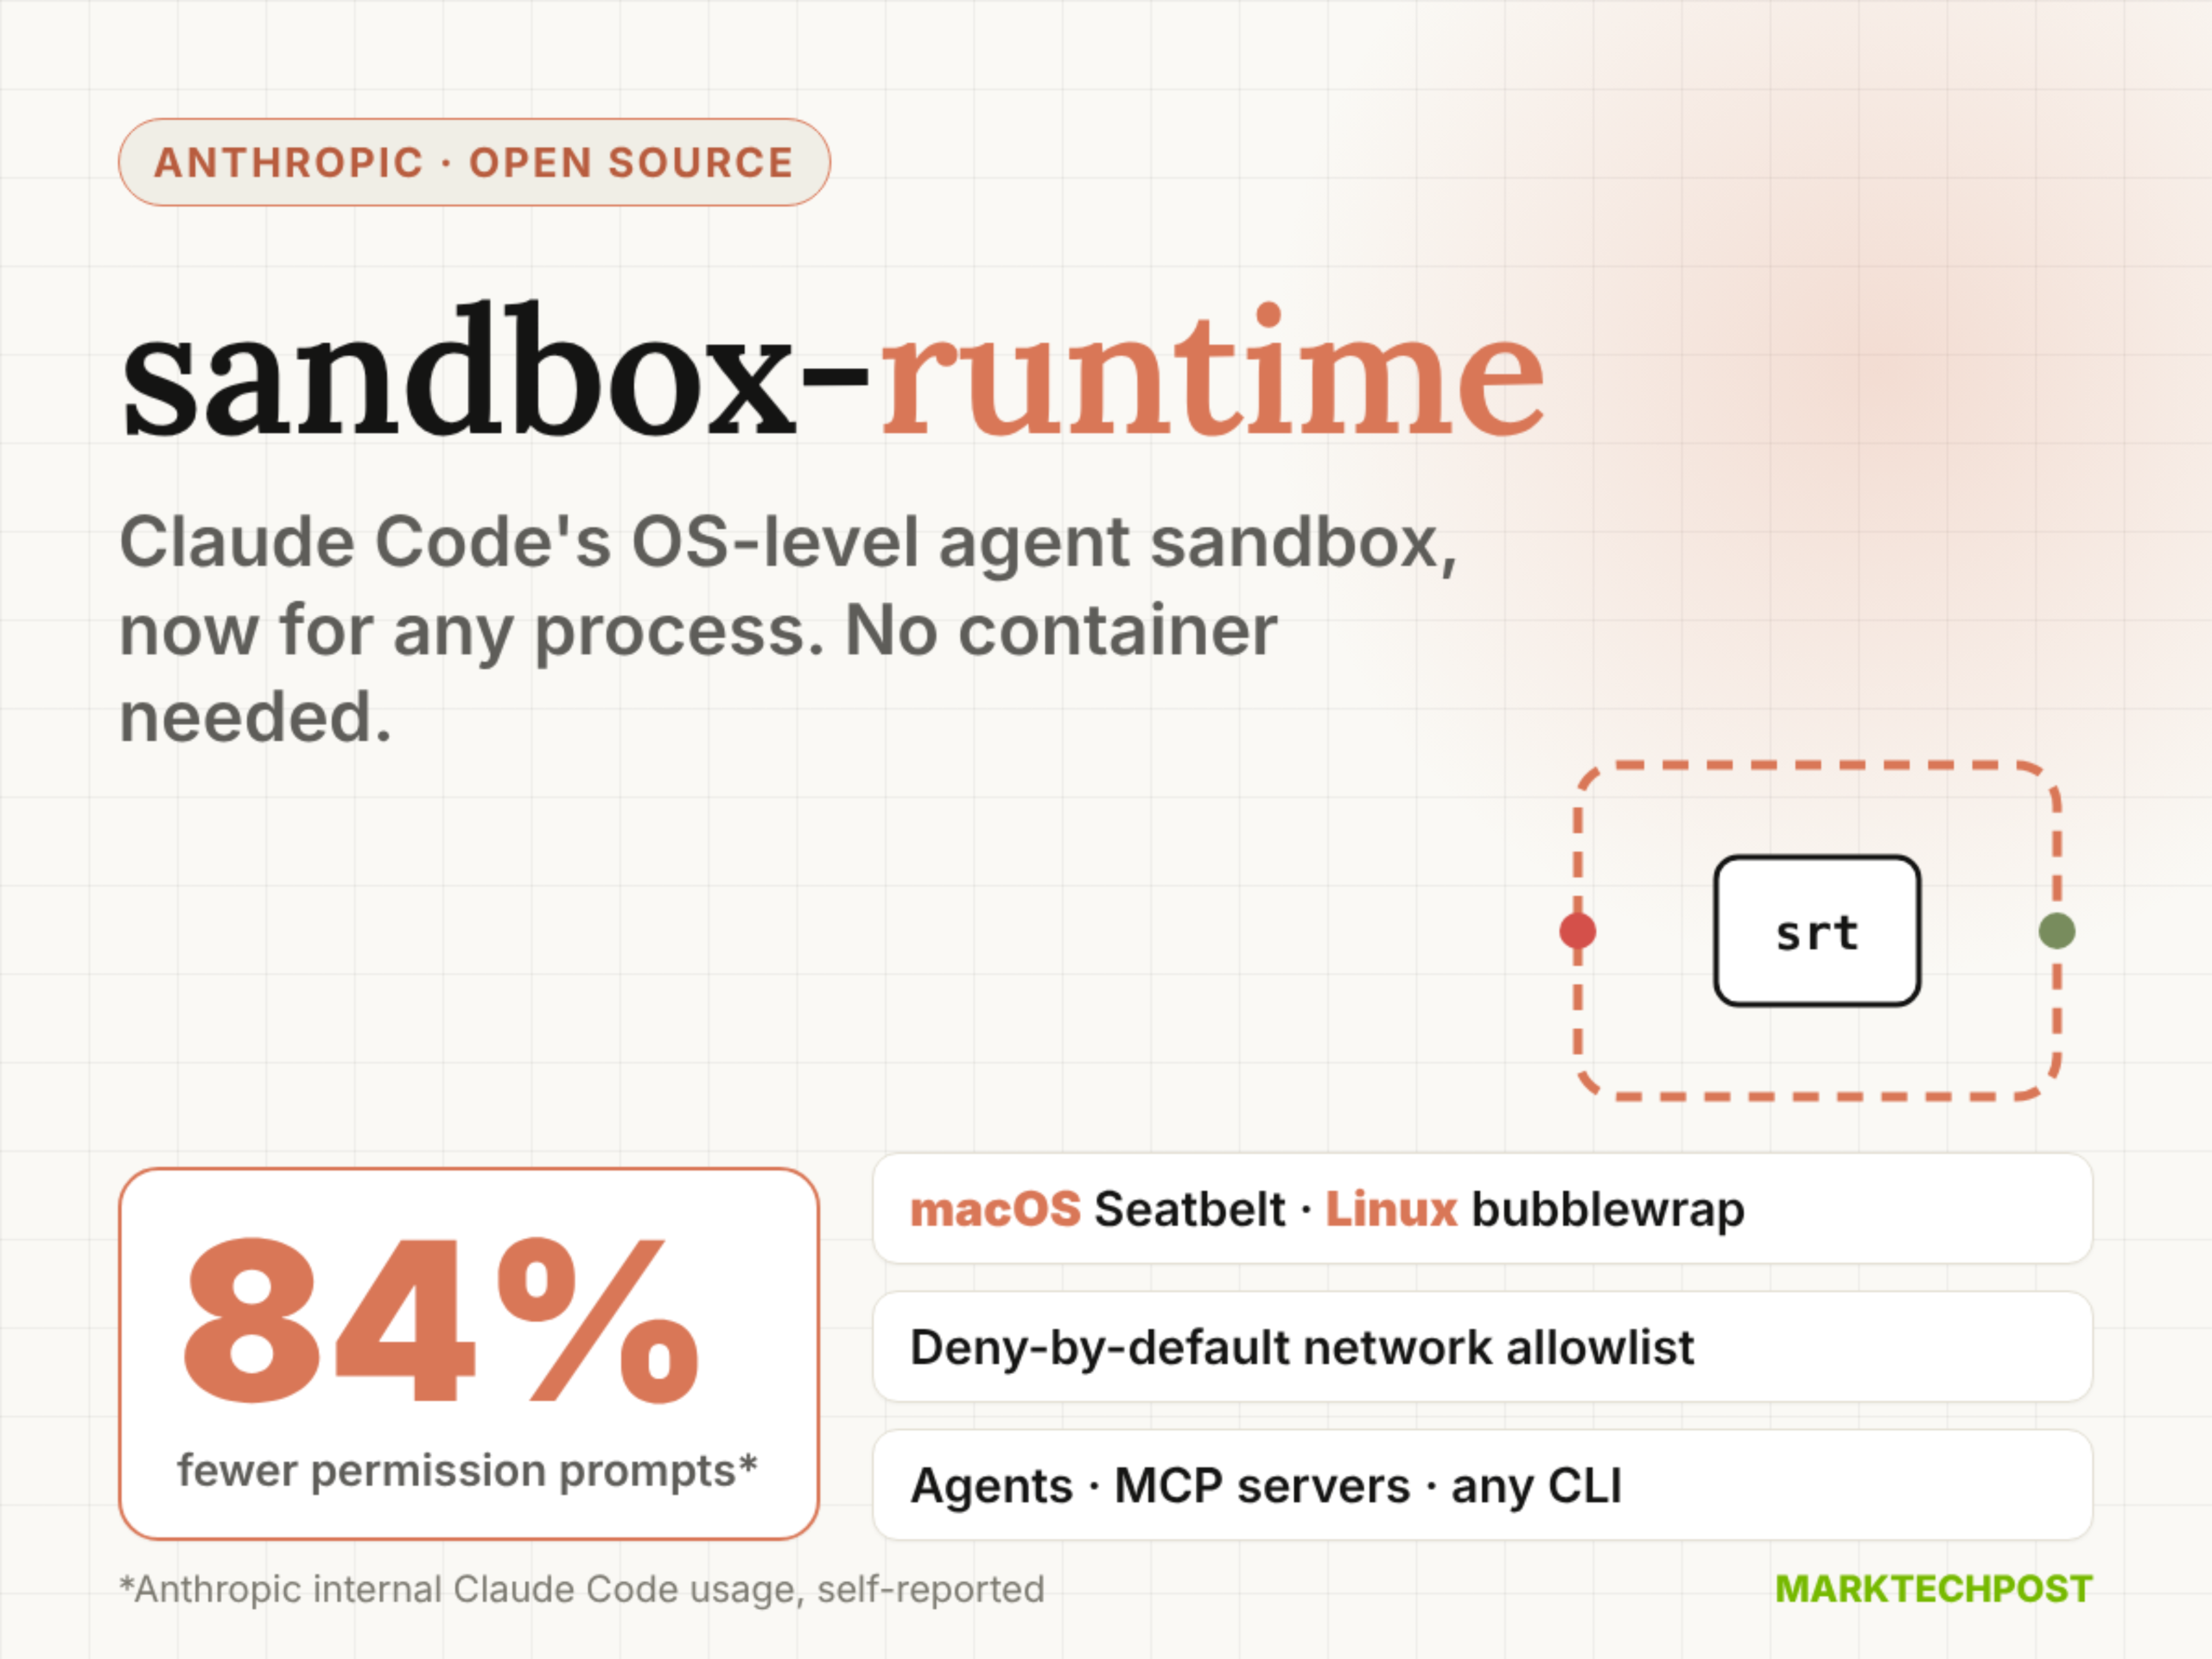
推荐理由:该工具代表AI安全基础设施的重要演进——通过操作系统原生隔离机制实现细粒度、进程树全覆盖的沙箱控制,直面提示注入与权限泛滥风险,且已投入Claude Code内部使用验证效果。
月之暗面于2026年10月22日前后发布Kimi K3.1 Pro,一款2.8万亿参数、1040亿激活参数的多模态MoE模型,宣称性能逼近Fable 5.1;官方承诺11月4日发布开源权重,但截至报道时权重尚未公开;独立评测显示其在智能指数、代码与网络安全基准中表现突出,但存在推理成本、本地部署可行性及营销透明度等争议。

推荐理由:该事件标志着当前最接近闭源前沿模型能力的开源权重模型正式进入发布倒计时,是AI开源生态关键进展;材料来源为Latent Space旗下AINews(2026年10月24日发布),内容基于对X平台、Reddit、Arena及Artificial Analysis等多方独立评测的整合,信息密度高且具时效性与交叉验证特征。
2026年10月24日,研究者在arXiv(编号2610.30828v1)发布TutorCaseBench——一个基于教育学、教育心理学与特殊教育真实案例构建的LLM家教评估基准,聚焦支持存在学习与行为困难学生的能力。该基准含923段对话、覆盖5类挑战行为,采用开放式生成(1560题)与多选题(2537题)双轨评估;11个前沿大模型中表现最优者仅在55.8%的开放题中满足评估标准。

推荐理由:该研究填补了现有AI教育评估忽视特殊需求学生行为复杂性的关键空白,方法论强调证据溯源(qualitative case studies + source-grounded rubrics),数据全部开源,具备可复现性与教育实践相关性;结果明确揭示当前LLM在情境化响应生成上的显著短板,对教育AI落地具警示与指导价值。
2026年10月24日,arXiv发布论文arXiv:2610.30690v1,提出一种由两名临床医生主导定义、定稿与裁决的四条安全检查规则库,经形式化验证后作为守卫层应用于心理健康场景下的大语言模型(LLM)输出。该守卫层所有判断均可从一条命名规则和十六个事实复现,旨在提升安全性判断的可解释性与可检验性。
推荐理由:该研究提供了一种区别于主流prompt工程、LLM-as-a-Judge或Constitutional AI的安全增强路径,其核心创新在于将临床决策结构化、形式化并全程留痕;所有关键主张(如规则数量、验证方式、事实基数、对比实验数据及成本测量)均来自原文明确陈述,且发布时间(2026-10-24)与当前UTC日期(2026-10-25)一致,具备时效性与可信基础。
该论文于2026年10月24日发布在arXiv(编号2610.30885v1),提出一种以施害者为中心的分析框架ODCBNA,整合本体设计、知识图谱构建、行为建模、社群分析与影响建模,基于孟加拉语网络欺凌语料库BenCoDiC开展实证分析。
推荐理由:材料为arXiv预印本,发布时间(2026-10-24)不晚于当前时间(2026-10-26),来源明确、结构完整;内容聚焦方法论创新与可复现分析结果(如1063名施害者识别、6个Louvain社群、特征贡献排序等),符合学术资讯时效性与事实性要求。
arXiv:2610.30355v1 发布类型:新 基本摘要:幻觉引用使得追踪来源并验证科学论断背后的证据变得更加困难。由于书目记录可能不完整,且在不同来源类型和出版版本之间存在差异,因此对其进行检测十分棘手。仅凭一个看似合理的匹配既无法确认该引用的有效性,也无法确定其背后的真实来源。我们提出了 CiteResolve,这是一个包含423条真实世界中幻觉引用的基准数据集,并已标注了其来源可恢复性。此外,我们还提出了一种名为 CiteAnchor 的源信息感知对齐框架,该框架能够针对每种来源类型调整检索策略与字段级验证方法,并分别判断引用的有效性以及是否能恢复出唯一的原始来源。在现有的一项检测基准上,CiteAnchor 使用 GPT-5.6 时达到了 0.841 的 F1 分数。
一篇2026年10月24日发布于arXiv的AI研究论文指出,当前主流的成对(pairwise)评估方法会自动抵消同一提示下所有响应共有的评分成分,导致奖励模型中关键的‘提示级偏差’未被检验;作者通过人类评分作为参照,对18个已发布评分器开展审计,发现在HelpSteer2数据集上,6个模型高达34%–64%的评分方差源于提示本身,而人类评分几乎无此现象。
推荐理由:该研究指出了大语言模型对齐流程中一个被长期忽视的基础性缺陷——奖励模型评分高度绑定于提示文本而非响应质量本身;其方法论(人类参照审计、提示替换、方差分解)具可复现性,结论基于实证分析且覆盖多个主流开源评分器,对偏好优化、RLHF和安全评估实践具有直接警示意义。
2026年10月24日,arXiv发布论文arXiv:2610.31098v1,提出RIFT——一种面向推测解码中草稿模型(drafter)的动态KV缓存压缩方法,通过平衡预填充信息与新生成token,并结合可压缩性训练,在8K-token KV缓存预算下使Qwen3.5-4B草稿模型为Qwen3.5-122B执行长上下文生成时,保持超98%的全缓存接受长度。
推荐理由:该研究直面长输出生成中KV缓存膨胀导致的硬件成本与精度下降矛盾,首次明确定义并量化‘解码陈旧性’(decode staleness)现象,并提出可落地的刷新机制与训练协同方案;实验设定具体(32K输入/4K输出/8K缓存),结果具工程参考价值;来源为arXiv预印本,发布时间(2026-10-24)与系统当前日期(2026-10-25)一致,时效性强。
一篇于2026年10月24日发布在arXiv(编号2610.30983v1)的AI研究论文系统评估了五种推理时上下文增强方法,发现其报告的准确率提升未必反映真实能力增强,而可能是无方向性扰动所致——既修正部分预测,也破坏其他预测。
推荐理由:该论文首次构建跨方法、跨模型、跨数据集的统一评估框架,指出仅依赖性能增益易掩盖可靠性缺陷;尤其警示 filler-token 类方法(不引入新信息)主要扰动决策边界附近的预测,不宜直接用于实际部署。
2026年10月24日,arXiv发布论文2610.30960v1,提出跨语言贫刺激(CPOS)实验设计,用于量化语言模型在跨语言持续训练中将源语言(L1)的层级结构证据迁移至目标语言(L2)的能力。实验表明该迁移部分成立但不完美,且高度依赖语言对及词汇重叠程度。
推荐理由:该研究首次构建可控的跨语言贫刺激框架,直接检验‘语言普遍性结构’是否构成跨语言迁移的认知基础,而非仅由非语言因素(如位置编码初始化)驱动;其结论对理解大语言模型语法习得机制与多语言对齐策略具有方法论和理论双重价值。
该论文于2026年10月24日在arXiv发布(编号2610.30379v1),提出MemPlan——一种将大语言模型(LLM)作为语言与符号规划之间受限桥梁的记忆条件化PDDL规划框架,适用于部分可观测的交互式文本环境。
推荐理由:MemPlan通过正向图记忆与负向记忆机制动态重构PDDL问题,显著提升任务完成率与步数效率,同时大幅降低在线token消耗;其离线微调的语言–符号接口可跨TextWorld任务类型复用,无需任务特化微调,体现了方法的泛化性与实用性。
该研究于2026年10月24日在arXiv发布(编号2610.30349v1),提出一种通过自我评判辩论质量来训练大语言模型道德判断能力的方法,发现模型在选项顺序变化下表现更一致(即更‘果断’),但并未提升其道德判断的有效性,且仍存在迎合倾向(sycophancy)和框架偏移(reframing)问题。
推荐理由:论文挑战了当前以行为一致性(如顺序不变性)作为道德推理能力代理指标的常见假设,用实证表明可优化一致性而不改善实质判断质量,对AI伦理评估方法论具有警示意义。
2026年10月24日,arXiv发布题为《ReflectPO:面向长周期LLM代理的反思引导策略优化》的研究论文(编号2610.30933v1),提出一种名为ReflectPO的强化学习框架,旨在增强工具增强型大语言模型代理在复杂、多步、状态依赖型任务中的自主错误恢复能力。
推荐理由:该论文是近期发布的前沿AI研究,聚焦当前LLM智能体落地的关键瓶颈——长周期任务中早期错误的累积效应;其提出的Reflection-Guided Sampling与Tree-Structured Credit Assignment双组件设计具有方法论创新性,并在两个工具使用基准上实证优于多个基线,具备技术参考价值。