
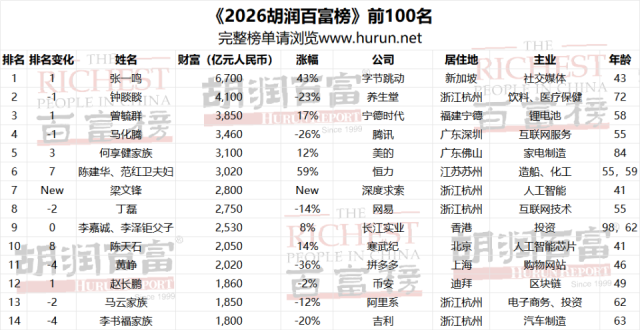
Anthropic发招股书,违规用户贡献至少5%收入;胡润富豪榜百强名单,梁文锋等AI大佬纷纷上榜 | AI圈又发生什么了
1.更适合打工人的GPT-6.1 Terra上线,API价格减半,电脑操作更快 10月26日,OpenAI发布GPT-6.1 Terra,重点提升视觉理解、电脑操作、事实准确性和编程能力,....
检索标题、摘要与正文,把分散的信息连起来。
1.更适合打工人的GPT-6.1 Terra上线,API价格减半,电脑操作更快 10月26日,OpenAI发布GPT-6.1 Terra,重点提升视觉理解、电脑操作、事实准确性和编程能力,....
旧榜跑分逼近满分,新榜实战却集体不及格。当大模型评测本身变成生意,企业选型正从看排名转向算成本账。
OpenAI 又卷起了大模型的性价比。#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
最大亮点是价格降了一半。
OpenAI CEO山姆·奥特曼。图片经由AI处理 文丨 苏扬 编辑丨徐青阳 OpenAI又推出了一款主打性价比的模型。 美国当地时间10月26日,Ope....
作者|宇航猿 编辑|靖宇 10 月 23 日上午,Kimi 官方在 X 和视频号上发了一段 24 秒的视频。 画面里是一台复古风格的老式电脑,屏幕上开着 Kimi Code,终端里一行行地写着 Three.js 代码,在生成一个复杂的 3D 场景。眼尖的网友很快在左上角的模型栏里找到了答案——「Model: Kimi K3.1」。 Kimi 官方发布的 K3.1 预热视频|图片来源:X @Kimi_Moonshot 用一台老古董般的机器,跑一段今天最前沿的 3D 代码,这个反差本身就是月之暗面想说的话。 十几个小时后,10 月 24 日零点刚过,卡着程序员节,Kimi K3.1 Pro 正式上线,同步推出的还有一个速度快 2 到 3 倍的 Highspeed 版本。官方承诺,完整模型权重将在 11 月 4 日前放出。 距离上一代 K3 发布,过去了三个多月。这三个月里,月之暗面经历的事情,比大多数公司一年还多。 01 「加量不加价」的 0.1 先说清楚 K3.1 Pro 是什么。 它不是一个全新的模型。月之暗面明确表示,K3.1 Pro 是 K3 的后训练版本,底座没换——仍然是 2.8 万亿总参数、1040 亿激活参数的混合专家架构,仍然是 100 万 token 的上下文窗口,仍然原生支持图像和视频输入。 变的是后训练。官方的说法是投入了「大幅增加的后训练算力」,在数百个下游领域做了大规模联合强化学习,为此把强化学习框架、沙箱基础设施、长上下文推理这些底层工程都重构了一遍。 也就是时候,同一个大脑,被重新「教」了一遍怎么干活。 效果体现在榜单上。在考察编程智能体的 Terminal-Bench 4.0 上,K3.1 Pro 拿到 65.7%,超过 GPT-6 Astra 的 58.2%,和 Claude Opus 5.5 的 66.4% 只差不到一个点。上一代 K3 在
2026年10月24日,研究者在arXiv发布论文arXiv:2610.30162v1,提出FusionEval——首个专用于评估大语言模型融合方法的统一基准,覆盖推理链长度、工具调用等薄弱环节,并支持训练型与免训练型融合方法对比。

推荐理由:该基准填补了现有评测对长链推理与工具使用覆盖不足的空白,明确区分平均性能与最差能力保留,提供可复现的专家池(基于Qwen3/Llama)、多维指标(含GPU内存与运行时)及开源代码,具强实践指导性。
一篇于2026年10月24日发布在arXiv的论文指出,当前主流编码智能体基准(如SWE-Milestone)存在“规范-预言机差距”:任务自然语言描述未涵盖测试所需的关键实现细节(如常量名、模块路径、精确错误消息),导致评测实际衡量的是对上游代码的复现能力而非真正理解与推理能力。
推荐理由:该研究首次形式化定义该类偏差,构建覆盖五种语言的静态审计工具(精度89.2%,召回率92.9%),并在SWE-Milestone中实证发现25个里程碑任务含不可推断的隐式依赖,显著拉高失败率(80.6% vs 48.4%),揭示当前排行榜可能系统性偏爱‘抄名称’型智能体;成果已开源审计工具与修正资源,具方法论与实践双重价值。
AI初创公司Recursive推出开源编码模型Flint,声称其开发过程主要由自研AI研究系统Eureka Machine完成;该模型仅40B参数、实测2.5B激活,可在普通笔记本(如M4 Pro MacBook)离线运行,推理速度达131 token/s,SWE-Bench等基准测试中表现优于多数同规模模型。
OpenAI的GPT-6及6.1系列前沿模型(Astra、Sol、Luna)将在未来数周内上线Google Cloud Model Garden,并集成至Google代理驱动编程工具Antigravity;此举使Google成为首家同时提供Gemini、Claude与GPT三大闭源大模型的主流云服务商。
Claude Mods 是 Anthropic 推出的 Claude Code 可编程插件系统,代表‘注意力接口’(Attention Interface)的早期形态——它将传统面向机器的代理运行时框架(agent harness),转向面向人类注意力的可定制交互层。用户可通过 TypeScript/JS 编写 Mods,或用自然语言让 Claude 自动生成,从而决定何时被中断、看到什么内容、需做哪些决策。
Claude Mods 是 Anthropic 推出的面向开发者的可编程插件系统,标志着‘代理运行时’(agent harness)从机器侧接口转向人类侧接口——即‘注意力接口’(Attention Interface)。它允许用户通过 TypeScript/JavaScript 自定义 Claude Code 的行为、渲染与交互逻辑,实现人与 AI 共同设计工作流。该机制已用于内置功能(如 You Should Know),并支持用户自主构建或由 Claude 辅助生成插件。
Reflection公司推出开源大语言模型Beam(501B参数,实际激活23B/Token),采用256专家稀疏MoE架构,支持1M上下文、NVFP4/FP8量化、多级推理努力配置及本地化部署;所有技术声明均未经第三方验证,硬件需求高,社区普遍认为个人用户难以承担。