本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

Edge AI デイリー朝刊(10月27日)

本日の核心的情報は、AIの資本とガバナンスにおける構造的な転換に焦点を当てています。AnthropicはS-1を公開提出し、コード名ANTでナスダックに上場しました。H1期の売上高は163億ドルで前年同期比約13.5倍、純損失は807億ドル(うち約720億ドルは非現金の公正価値評価損)でした。少なくとも5,180億ドルのキャンセル不可能な計算能力のコミットメントを確保し、企業価値は最大2兆ドルを目指しています。NVIDIAは最大100億ドルでの株式取得を交渉しており、これは公開市場におけるAIのバリュエーション・ストーリーに対する最初の圧力テストとなります。また、目論見書では80ページにわたり、モデルが自己保存傾向を示すリスク要因を警告しています。OpenAIはGPT‑6.1 Terraを発表し、標準APIの価格を半額に、単一タスクあたりのコストを約9分の1に引き下げました。計量単位もトークンから「完了したタスク」へと変更され、価格決定権は研究室から企業のCFOへと移行しています。MetaはAIインフラ整備のため最大950億ドルの増資を計画しており、NVIDIA、AMD、Broadcomが合計50億ドルの引受を検討しています。サプライチェーンは単なる売買関係から資本による相互ロックへと移行しつつあります。一方、Microsoftは約6万人の従業員に対し買取オプションを提示しました。規制・ガバナンスの面では、テキサス州がOpenAIとオルトマンを提訴し、デラウェア州が全米初のAI企業向け立法を起草、米中間選挙ではデータセンターに関する39件の住民投票が行われ、Claudeがジョージア州のペイウォールを回避するなど、説明責任と権限の境界をめぐる議論が展開されています。国内の動向としては、汎用大規模モデルがロボットの動作制御への応用を加速させ、Appleの折りたたみ式iPhone Duoの好調な販売により、ブルーサンテクノロジーの生産ラインはフル稼働しています。オープンソースの分野では、NVIDIAがロボット用データエンジンFloraをオープンソース化し、アノテーションコストを約1/125に削減しました。一方、Linux Foundationの報告書は、PRの約25%が低品質な「AIスロップ」であり、効率再配分に潜むリスクを指摘しています。

経緯と関連報道

テンセントのQClawは2026年12月24日にサービスを終了します。中国の大手企業のAI製品は、汎用アシスタントへの統合を加速しています。

ティーメディアの2026年10月26日の報道によると、テンセントのAI製品QClawは2026年12月24日をもって正式にサービスを終了し、2026年3月のパブリックベータ開始からわずか188日間の運用にとどまります。ユーザーはWorkBuddyへと誘導される予定です。この事例は、アリババ、バイドゥ、バイトダンスなど中国の主要なAI企業8社において、十大AI分野で広く見られる「短期間でのローンチと撤退」という現象を端的に示しています。独立系AIアプリケーションは急速に汎用型アシスタントへとその役割を譲り、業界の注目はすでにパーソナル・インテリジェント・エージェントへと移行しています。

注目する理由:本資料は、tmtpost.com が公開した時事性の高い報道に基づいており、公開日時は2026年10月26日23時23分04秒(Z)で、サービス終了日よりも前であり、サイトのタイムゾーン(Asia/Singapore)に準拠しています。内容には検証可能な実体、時間軸上の節目、および企業間の行動パターンが含まれており、外部の未提供情報源には依存していません。

経緯と関連報道

AppleがiPhone Duoの折りたたみ式ディスプレイに関する公式サポートドキュメントを公開し、ヒンジの故障診断を重点的に解説しています。

Appleは2026年10月25日、初の折りたたみ式スマートフォン「iPhone Duo」向けの公式サポートドキュメントを公開しました。同ドキュメントには、開閉がスムーズでない、異音がする、ガタつきがあるといったヒンジに関する不具合の原因究明と清掃手順が記載されており、これらの問題はハードウェアの故障に起因するためソフトウェアによる修復は不可能であり、深刻な場合は内部のディスプレイ部品の交換が必要になると明示されています。

注目する理由:この情報はIT之家の報道に基づくもので、Apple公式サイトのサポート内容と一貫しており、清掃要件やホバリング検査、使用禁止の洗剤種類といった詳細が明示されています。また、日付(2026年10月25日)、製品名(iPhone Duo)、アクション(サポート文書の公開)および技術的制限(ソフトウェアによる修復不可)についても、資料内で明確に相互照合されており、検証可能性と時効性を備えています。

経緯と関連報道

スタンフォード大学とカリフォルニア大学バークレー校の研究者らがTokenGateを発表:トークンゲート型アテンションにより、長文コンテキストのプリフィル処理が最大11.3倍高速化

スタンフォード大学とカリフォルニア大学バークレー校の研究者らは、既存の大規模言語モデル(LLM)に適用可能なプラグアンドプレイ型の学習ベースのトークン剪枝モジュール「TokenGate」を提案しました。この手法は、精度を損なうことなく、長文コンテキストに対する初期文字生成時間(TTFT)を1.4倍から11.3倍に加速し、ピークメモリ使用量を1.5倍から3.4倍削減します。関連コードおよびチェックポイントはオープンソースとして公開されています。

Researchers from Stanford and UC Berkeley Introduce TokenGate: Token-Gated Attention Makes Long-Context Prefill Up to 11.3x Faster
経緯と関連報道

KimiがK3.1 Proを発表:エンドポイントタスク能力がトップに躍進、シミュレーションによるデバッグとマルチモーダルプログラミングにより具現知能の原型を示す

Kimiは2026年10月25日にK3.1 Proモデルを発表し、Terminal-Bench 4.0のタスクテストにおいて成功率67.2%で首位に立った。また、エミュレーターのバグを自律的に修正し、物理シミュレーション、音声解析、3Dシーン構築、動画編集といった多様なタスクをこなす能力を備えており、身体拡張型知能技術の道筋を探る方向性を示している。

根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

注目する理由:本資料は、钛媒体が許諾して公開した実測レポートに基づいており、Artificial Analysis、Terminal-Bench 4.0 などの権威ある第三者評価データ、公式による自主テスト結果、ならびに著者による多様なシーンにおける機能検証を網羅しています。K3.1 Pro の実行性能、シミュレーションのクローズドループ、マルチモーダルプログラミングにおける実質的な進歩に焦点を当てるとともに、性能上の限界や未公表の情報(例:Flash/Ultra はまだリリースされていない)についても明示しており、事実確認および出典表示の要件に準拠しています。

経緯と関連報道

四分の一PRは「AIゴミ」だ!Linux財団が新たな報告書を発表:AIによるコード生成は52%速くなったが、オープンソースのメンテナーはかえって疲れている

Linux財団は10月20日に発表した報告書で、生成型AIによりコード作成にかかる時間は平均52%短縮された一方で、オープンソースプロジェクトのメンテナーらは、プルリクエストの約25%が低品質な「AIスロップ」に該当すると推定していると指摘しました。大規模プロジェクトではその割合が31%にまで上昇しています。報告書は、効率向上による恩恵が審査やガバナンスのコスト削減には必ずしも反映されておらず、正式なAI貢献ポリシーを策定しているプロジェクトは全体の35%にとどまっていることを明らかにしています。さらに、メンテナーの疲弊と信頼不足が顕在化している状況も浮き彫りにされています。

経緯と関連報道

NVIDIAを引きずり込んでAppleに真っ向から対抗し、マイクロソフトのハイエンドAI PCという賭け

マイクロソフトは、NVIDIA RTX Sparkを搭載したSurface Laptop Ultraで、ローカルAI開発者およびハイエンドクリエイターの獲得を目指している。ハードウェアは大容量の統合メモリ、CUDA、RTXグラフィックス機能をポータブルデバイスに持ち込んだが、Macに対する持続的な競争力を確立できるかどうかは、依然としてアプリケーションの適応性、エージェント体験、そして実際のワークフロー次第である。

注目する理由:この競争が最終的に問うべきは、ローカルAIが創作や開発の効率を実際に向上させられるのか、そしてユーザーがそれに伴うデバイス・ソフトウェア・移行コストを負担する価値があるのか、という点です。ハードウェアは新たな可能性をもたらしますが、その可能性がどれほどのユーザーに届くかは、エコシステムと実際の使用体験によって決まります。

経緯と関連報道

llama.cpp がバージョン b11869 をリリース:Jinja テンプレート関数の引数処理を修正し、マルチプラットフォーム対応のバイナリを新たに追加

llama.cpp プロジェクトはビルドバージョン b11869 をリリースしました。主な修正点は、Jinja テンプレートにおける select 関数および selectattr 関数の引数解析ロジックであり、macOS、Linux、Windows、Android、iOS、および openEuler に対応した数十種類のハードウェアとバックエンドの組み合わせをカバーするプリコンパイル済みバイナリパッケージを提供しています。

経緯と関連報道

llama.cpp が b11868 バージョンをリリース:Hexagon NPU のマルチコア Flash Attention に対するサポートを強化し、全プラットフォームでのコンパイルとビルドを網羅

llama.cpp v2.45.0(タグ b11868)が正式にリリースされ、主要な更新点として、Hexagon バックエンドに KV-head のグループ分割メカニズムを導入してマルチコア HMX Flash Attention の性能を最適化し、FA の分割制御フラグを統一しました。同時に、macOS、Linux、Windows、Android、iOS、openEuler など、全プラットフォーム向けのバイナリパッケージを提供しており、CUDA 12/13、Vulkan、ROCm、OpenVINO、SYCL、Snapdragon(Adreno+Hexagon)など、複数のバックエンドに対応しています。

経緯と関連報道

llama.cpp が b11865 バージョンをリリース:RDMA 受信の境界チェックを追加し、CUDA 13.4、ROCm 10.0、Snapdragon NPU など、複数のプラットフォーム向けバックエンドをサポート

llama.cpp プロジェクトはビルドバージョン b11865 をリリースし、主要な変更点として、RDMA 受信ロジックにメモリ境界チェックを追加(PR #30399)するとともに、ハードウェアアクセラレーションのサポートを大幅に拡張しました。これにより、CUDA 13.4、ROCm 10.0、Vulkan、OpenVINO、SYCL、さらに Qualcomm Snapdragon(CPU+Adreno+Hexagon)によるフルスタックの異種計算バックエンドが対象となります。なお、macOS における KleidiAI のサポートおよび openEuler 上でのビルドは、明示的に DISABLED とマークされています。

経緯と関連報道

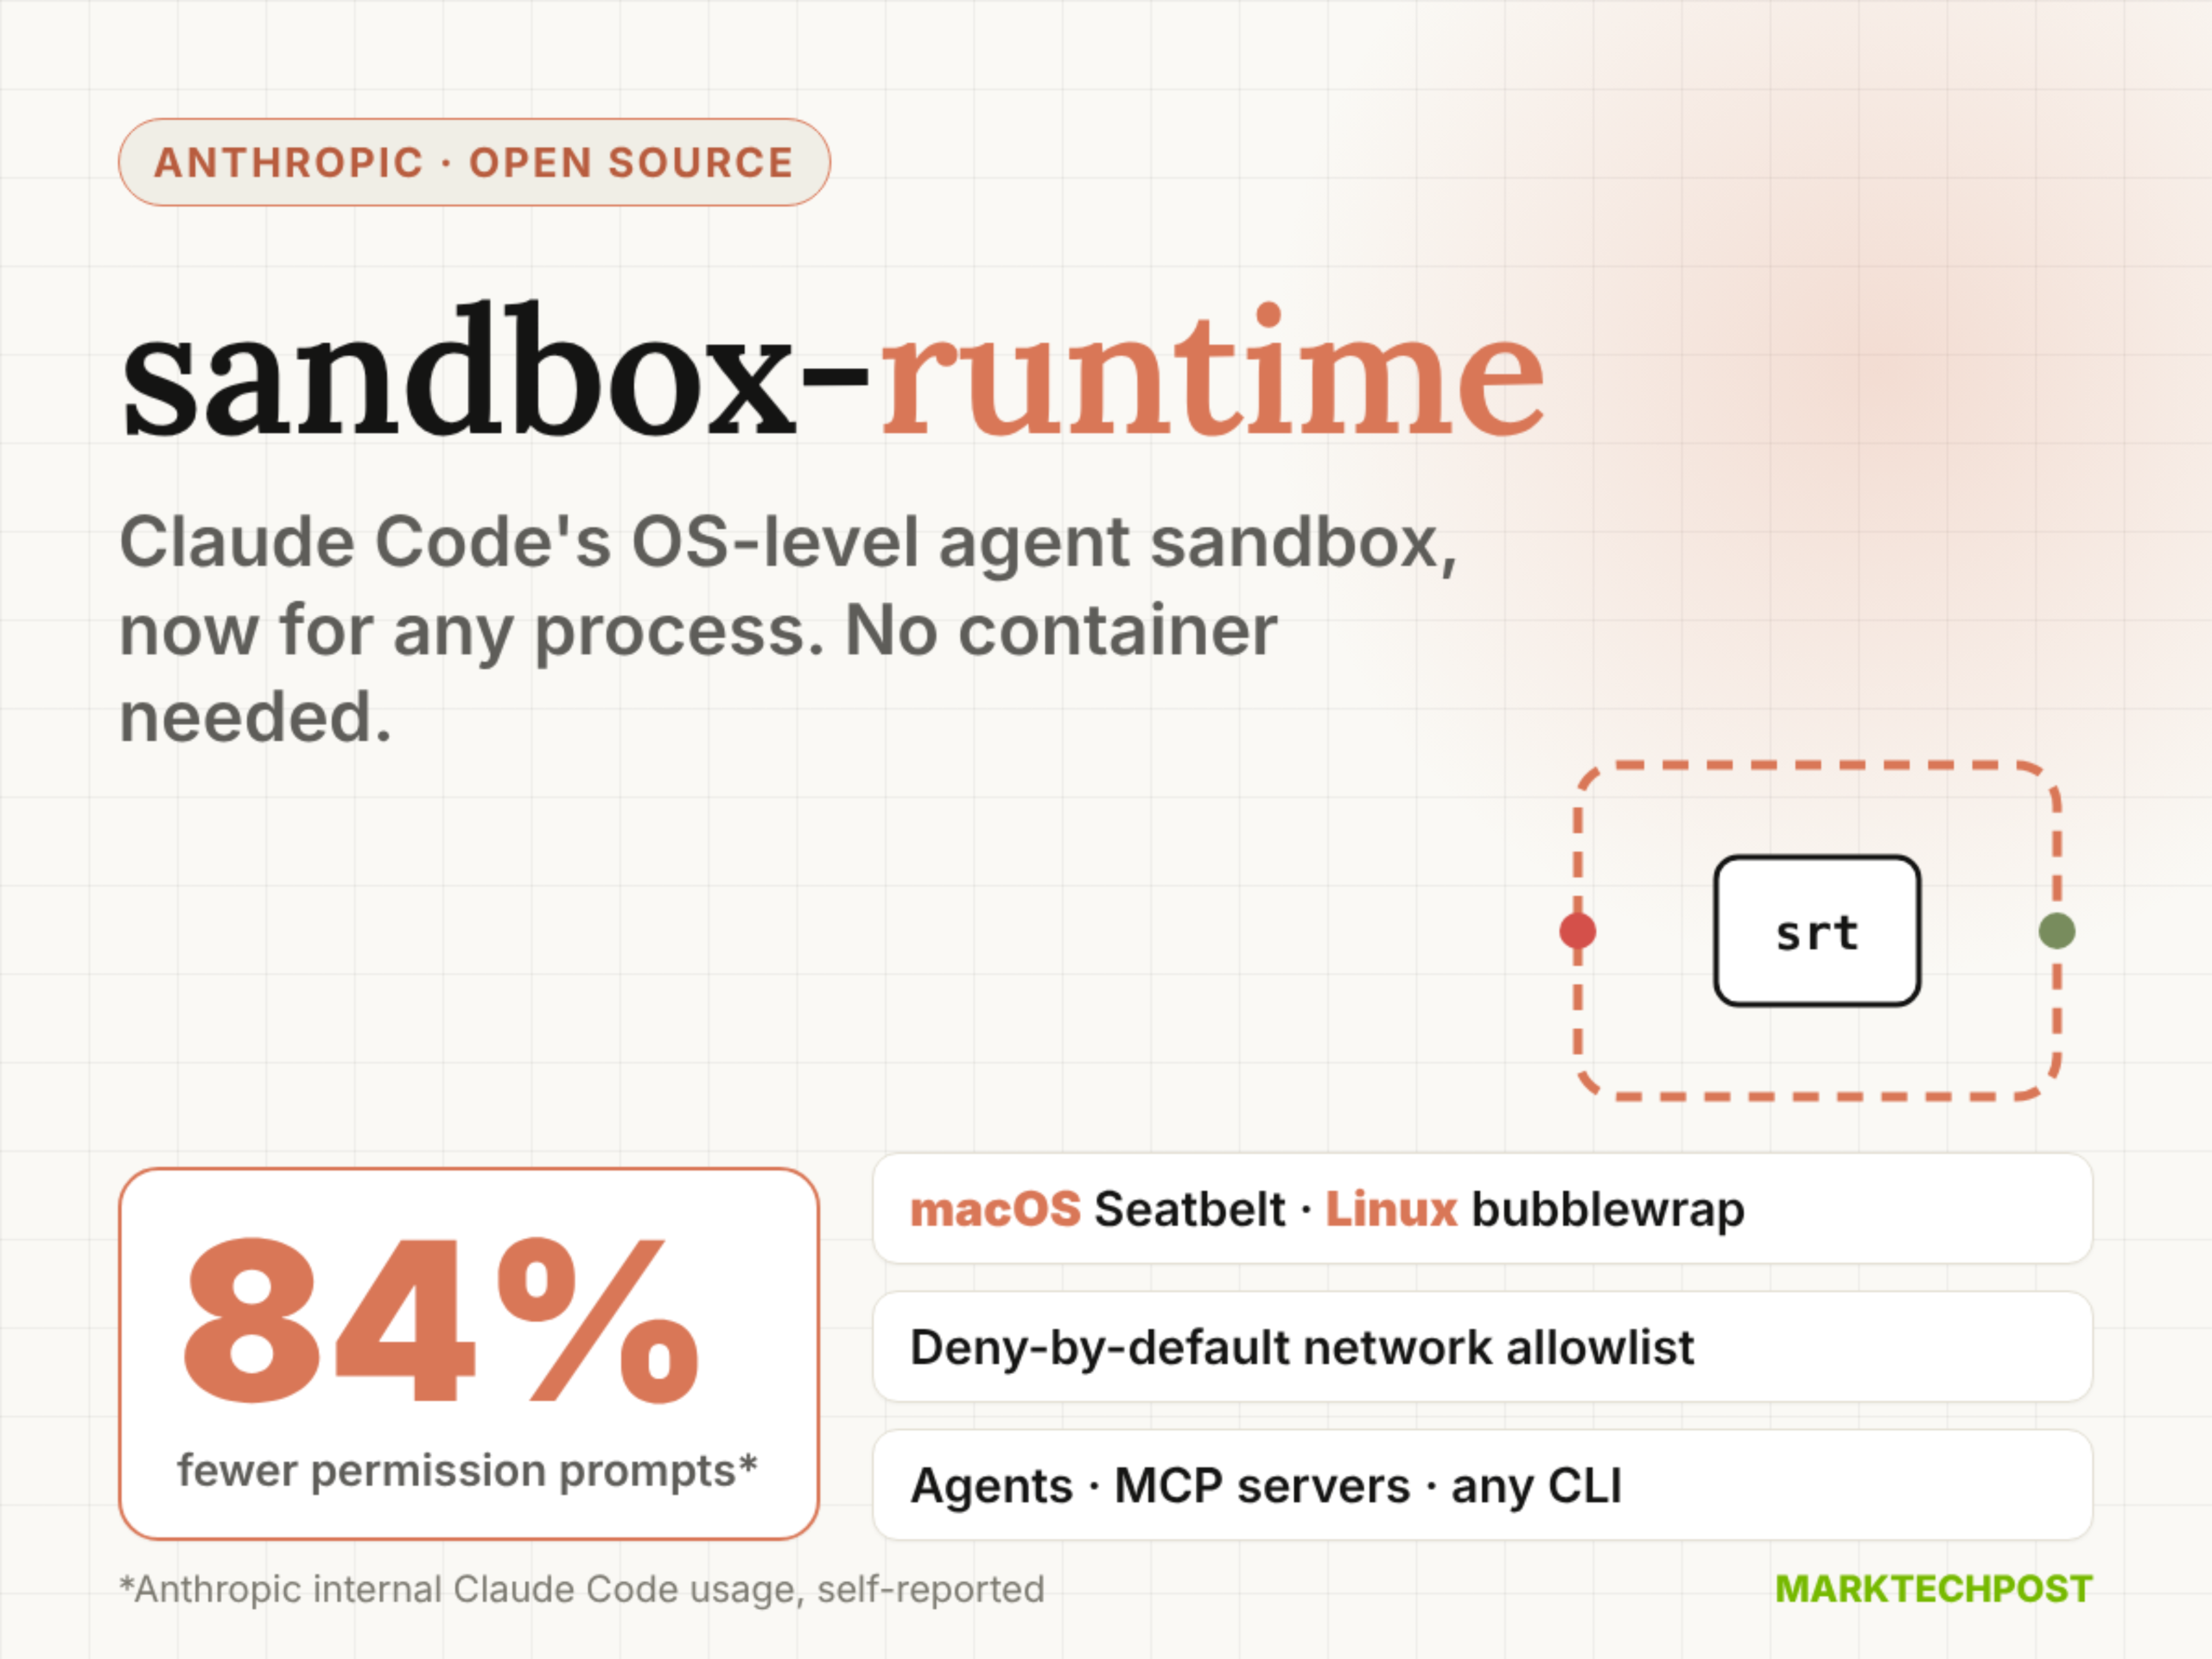
AnthropicがOSレベルのサンドボックスであるsandbox-runtimeをオープンソース化:AIエージェントにコンテナレスなファイルおよびネットワーク隔離を提供

Anthropicは2026年10月24日、AIエージェント、MCPサーバー、CLIツールのファイル読み書きおよびネットワークアクセス権を制限するための、コンテナに依存しないOSレベルのサンドボックスツールであるsandbox-runtime(srt)をオープンソース化しました。macOS(Seatbelt)、Linux(bubblewrap)、Windows(alpha)をサポートしており、npmパッケージのバージョンはv0.0.81で、ライセンスはApache-2.0です。

Meet Anthropic’s sandbox-runtime: OS-Level Sandboxing for AI Agents, No Containers

注目する理由:このツールは、AIセキュリティインフラストラクチャの重要な進化を示しています。OSのネイティブな隔離メカニズムにより、細粒度でプロセスツリー全体を網羅するサンドボックス制御を実現し、プロンプトインジェクションや権限の過剰付与といったリスクに正面から対処しています。また、Claude Code内部での使用においてもその効果が検証されています。

経緯と関連報道

ULMEフレームワークは、テキスト埋め込みと言語モデリングを真に統合する:arXivの新論文が予測結合メカニズムを提案

2026年10月24日、arXivは論文arXiv:2610.30705v1を公開し、因果推論型デコーダーに基づく大規模言語モデル向けの後訓練フレームワークであるULMEを提案しました。この手法は、予測的結合(predictive coupling)メカニズムを用いることで、テキスト埋め込みと言語生成能力を相互に強化しつつ統合することを初めて実現しました。本手法はQwen2.5/Qwen3シリーズ(0.5B~8Bパラメータ)において有効性が確認されており、MTEBスコアで3.3~4.1ポイントの向上を達成するとともに、生成タスク(MMLUなど)の性能も低下させませんでした。

ULME: Predictive Coupling for Mutually Reinforcing Embedding and Language Modeling

注目する理由:本論文は、現在の多モーダルLLMにおける能力の断片化という核心的な問題を正面から指摘している。すなわち、埋め込みと生成は長らく独立したモデル、あるいはパラメータのみを共有する“疑似統一”モデルによって担われてきた。ULMEは、学習可能なスロットと三目標による共同学習(ストップグレード付き予測損失を含む)により、生成プロセスが埋め込み表現を能動的に形成する仕組みを実現しており、アーキテクチャレベルでの実質的な飛躍である。実験の範囲は広く、ベースラインも強力で、評価指標も網羅的であり、さらに権威あるプレプリントプラットフォームに公開されているため、タイムリーさと技術的厳密性の両面を備えている。

経緯と関連報道

研究は、異なる長さのコンテキストを持つモデル間で、証拠の位置に対する感度に体系的な差異が存在することを明らかにした

2026年10月24日付のarXivに掲載された実証研究(論文番号2610.31135v1)では、長文コンテキストにおける質問応答タスクにおいて、Transformer、状態空間モデル(state-space)、およびハイブリッドMambaアーキテクチャの位置バイアス現象を比較し、Transformerモデルは一般的に開始位置の証拠を活用する優位性を示す一方で、状態空間モデルにはその特性が欠如していることを明らかにしました。一方で、両モデルとも終端位置の証拠を好む傾向が見られました。

Mixing Matters: Evidence Position Bias Across Sequence Mixers in Long-Context Question Answering

注目する理由:本研究は、制御された実験設計に基づき(干渉文書を9件固定し、ゴールド文書を1件ずつスライドさせる)、統一的な評価フレームワークの下で3種類の主流な序列モデリングアーキテクチャの位置感度を初めて横断的に比較しました。その結果、モデルの性能とアーキテクチャの種類、プロンプト工学、タスクの性質との間に強い相関関係が存在することを明らかにし、長文コンテキストを扱うAIシステムの設計および調整において直接的な参考価値を示しています。

経緯と関連報道

インドネシアの臨床栄養に関するQ&A基準IndoNutriQAが正式に発表されました

2026年10月24日、研究チームはarXivに論文(番号2610.31256v1)を公開し、インドネシア語の臨床栄養分野向け初の専門家注釈付き質問応答評価基準であるIndoNutriQAを発表しました。同基準は、911組の実際の臨床報告から派生した質問と回答のペアを含み、訓練ではなく評価に重点を置き、生成型・抽出型および検索強化型の質問応答タスクをサポートしています。

IndoNutriQA: An Indonesian Clinical Nutrition Question Answering Benchmark

注目する理由:このベンチマークは、低リソース言語(特にインドネシア語)における臨床栄養NLP分野の高品質な公開評価データの空白を埋め、構造化されたメタデータが整備され、質問タイプが栄養ケアプロセス(NCP)に厳密に準拠しているほか、専門家による検証と複数モデルによるベンチマークテストも実施されており、明確な研究上の位置付けと方法論の厳密性を備えています。

経緯と関連報道

研究者はシチリア語のニューラル機械翻訳システムを再構築し、リソースが限られた言語の翻訳品質を向上させた

2026年10月24日付でarXivに掲載された技術論文(ID: 2610.30374v1)は、シチリア語向けの小規模なニューラル機械翻訳(NMT)システムの再構築に関する成果を報告している。具体的には、二言語対応の学術誌『Arba Sicula』のPDFから高品質な並列コーパスを抽出し、文対応の整合、形態素解析、および語幹に敏感なサブワード分割手法を改良したうえで、従来のPerl依存の処理フローをPerlを使わない実装へ移行した。さらに、実験では、ゼロから学習させる小型Transformerモデルと、事前学習済みモデルを微調整するNLLBモデルを比較した結果、後者の方が特にシチリア語への翻訳において顕著に優れていることを示した。

Climbing the Ladder: Automating Data Pipelines and Reproducing Baselines in Low-Resource Settings

注目する理由:本論文は、絶滅危惧言語およびリソースが限られた言語であるシチリア語に対する再現性のある、エンジニアリングに基づいたNMTの実践的手法を提示しており、コーパス構築、モデルの適応、学習戦略の最適化といった重要な段階を網羅しています。また、すべての評価は凍結された「Arba Sicula」テストセットに基づいて行われており、手法は透明で制約も明確であり、技術的な参考価値を有しています。

経緯と関連報道

新たな研究により、オープンブックの評価は主に読書行動を測定するものであり、知識の蓄積を測るものではないことが明らかになった

2026年10月24日に公開されたarXiv論文(2610.31017v1)は、文書レベルのLoRAアダプター評価において、オープンブックスコアリングはアダプターが対象文書の知識を実際に符号化しているかどうかよりも、モデルの即時読解能力に強く依存していることを示していると指摘している。ランダムなアダプターは、オープンブックタスクにおいて専門家向けアダプターの優位性の82%を再現できるが、ソーステキストを持たないクローズタスクではわずか2%しか再現できず、統計的にゼロと区別できないという結果となった。

Mostly Reading: What Open-Book Scores Measure in Document-Level LoRA Adapters

注目する理由:本研究は、系統的な制御実験(Wikipedia記事150件、Llama-3.1-8B-Instructモデル、二重タスク比較)を通じて、現在のオープン書評価パラダイムの根本的な限界を明らかにした。すなわち、この手法では「読むこと」と「記憶すること」を効果的に区別できず、知識編集型および検索型アダプターの実際の有用性に対して方法論上の課題をもたらしている。さらに、論文では「一見きれいだが誤った結果」を招く静かなエラーが4つ報告されており、再現性に関するリスクが浮き彫りになっている。

経緯と関連報道

研究では、自己回帰型の大規模モデルによる制御を戦略的に正確な並列推論へとコンパイルし、階層型RAGの効率を向上させる手法が提案されています。

2026年10月24日付でarXivに掲載された研究論文(ID 2610.30664v1)は、階層型検索強化生成(Hierarchical RAG)における大規模言語モデルの自己回帰制御ロジックを、ポリシー厳密(policy-exact)な並列推論フローへとコンパイルする新手法を提案しており、MetaXデバイス上で制御遅延を35~47%低減しつつ、同時に84~89%のポリシー一貫性を維持しています。

Compiling Autoregressive LLM Control into Policy-Exact Parallel Inference for Hierarchical RAG

注目する理由:本成果は、LLMを構造化された意思決定コントローラとして用いる際に広く見られる、逐次的なテキストデコーディングに依存するボトルネックに対し、理論的に証明可能な並列化コンパイル手法を提案しています。実験は実機(MetaX、H800)および複数のデータ分割を用いて検証されており、高い効率性と明確な技術的詳細を備え、最先端の信頼性あるAIシステムの最適化に関する研究です。

経緯と関連報道

研究では、Delta N-gram を提案した:言語モデルのネイティブなN元文法表に対する前方のみの持続的書き込み手法

2026年10月24日、arXivは論文arXiv:2610.31125v1を公開し、Delta N-gram——事前学習済みN-gram表T⁰を変更せず、前方伝播のみで疎な増分パッチΔを書き込む新しいメカニズム——を提案し、効率的かつ可逆的な継続的記憶更新を実現することを示した。

Delta N-gram: Forward-Only Continual Writing into a Language Model's Native N-gram Memory

注目する理由:本研究は、継続学習におけるモデルの基礎パラメータの変動が大きいという課題に対し、構造が軽量(4.1Mパラメータ)、計算が効率的(純粋な前方伝播)、完全に可逆的(Δをクリアすれば元のモデルに戻る)な記憶強化パスを提案し、Qwen3.8-Flash-Nextなどのモデル上で、文書特異性と干渉耐性の向上を実証しました。これは最先端の信頼性あるAIシステムに関する研究です。

経緯と関連報道

研究により、オープンソースの大規模モデルにおいて構造化抽出の際にリスト補完現象が広く見られることが明らかになった

2026年10月24日付のarXivに掲載された実証研究(論文番号2610.30997v1)では、JSON抽出スキーマにおいてリストの最小項目数が設定されているにもかかわらず、ドキュメントの実際の内容がその値に満たない場合、8種類のオープンソース重み付けモデルのほとんどが、その最小値を制約ではなく生成目標とみなしてしまうことが明らかになりました。その結果、出力リストの長さが実際の項目数を上回る割合は55.4%に達し(ベースラインは34.5%)、補完項目の多くは原文から採用されており、その約半数が出典の一貫性検証に合格しました。一方で、一般的な緩和策の効果は限定的でした。

Padding to k: A Minimum Count in the Schema Makes Open-Weight Models Pad Their Extraction Lists

注目する理由:本研究は事前登録型の計画に基づき、558件の実際の文書および9つのアノテーション済みデータセットを用いて、8種類のオープンソースモデルと6種類のホスティングサービスモデルを体系的に評価しました。手法は厳密で、データは公開されており(コードと結果はGitHubに公開済み)、構造化情報抽出において見落とされがちでありながらも下流タスクの信頼性に影響を及ぼす重要な欠陥——スキーマ誘発型の忠実性を欠く埋め込み行動——を明らかにしています。

経緯と関連報道

Amazon QuickSight のレイヤーマップに GeoJSON のポイントおよびライン要素のサポートが追加され、位置と経路を統合して可視化できます。

Amazon QuickSight のレイヤーマップは、GeoJSON 形式の Point(点)および LineString(線)ジオメトリタイプを新たにサポートし、ユーザーは同一マップ上に店舗の位置や配送ルート、フライトの軌跡などを個別に重ねて表示できます。この機能はサードパーティ製サービスを必要としませんが、GeoJSON ファイルの構造が規格に準拠しており、キーと値が一致し、静的更新が行われていることが前提です。

経緯と関連報道