
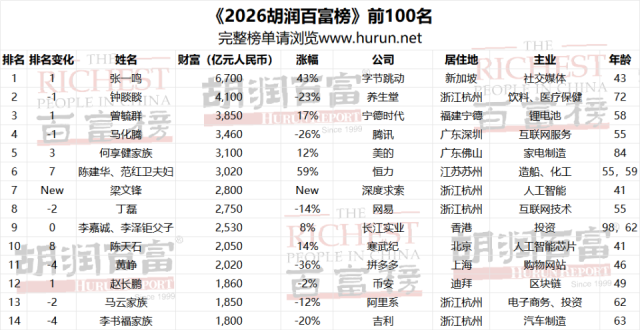
Anthropicが目論見書を提出、違反ユーザーが収益の少なくとも5%を占める;胡潤富豪ランキング上位100人のリストに、梁文鋒らAI界の大物が相次いで名を連ねる|AI業界でまた何が起きたのか
1. 働き手にさらに適したGPT-6.1 Terraがリリースされ、API料金が半額になり、パソコン操作もより速くなりました 10月26日、OpenAIはGPT-6.1 Terraを発表し、視覚理解、パソコン操作、事実の正確性、プログラミング能力の向上に重点を置きました、....
見出し・要約・本文から、情報のつながりを探します。
1. 働き手にさらに適したGPT-6.1 Terraがリリースされ、API料金が半額になり、パソコン操作もより速くなりました 10月26日、OpenAIはGPT-6.1 Terraを発表し、視覚理解、パソコン操作、事実の正確性、プログラミング能力の向上に重点を置きました、....
旧ランキングのスコアは満点に迫るも、新ランキングの実戦評価では軒並み不合格。大規模モデルの評価自体がビジネス化するなか、企業の選定基準はランキングを見る時代から、コスト計算へと移りつつある。
OpenAIがまた、大規模モデルのコストパフォーマンスを大きく引き上げました。#愛範兒の公式WeChatアカウント「愛範兒」(WeChat ID:ifanr)をぜひフォローしてください。さらに詳しいコンテンツをいち早くお届けします。
最大の目玉は価格が半額になったことです。
OpenAIのCEO、サム・アルトマン。画像はAIで処理されています 記者:スー・ヤン 編集:シュウ・チンヤン OpenAIがまた、コストパフォーマンス重視のモデルを発表しました。 米国時間10月26日、Ope....
著者|宇航猿 編集|靖宇 10月23日午前、Kimi公式はXとビデオ番号で24秒の動画を公開した。映像にはレトロな雰囲気の古いパソコンが映り、画面にはKimi Codeが起動し、端末にはThree.jsのコードが一行ずつ表示され、複雑な3Dシーンが生成されていく様子が映っていた。目ざといネットユーザーはすぐに左上隅のモデル欄で答えを見つけた――「Model: Kimi K3.1」だ。 Kimi公式が公開したK3.1の事前告知動画|画像出典:X @Kimi_Moonshot 古い時代の機械で、今日最先端の3Dコードを実行する――このギャップこそが、月之暗面が伝えたいメッセージそのものだった。 それから十数時間後、10月24日零時を過ぎた直後、プログラマーの日に合わせてKimi K3.1 Proが正式にリリースされ、同時に速度が2〜3倍速いHighspeed版も同時に登場した。公式は、完全なモデルの重み付けデータを11月4日までに公開すると約束している。 前世代のK3が発表されてから、すでに3か月以上が経過していた。この3か月間、月之暗面が経験したことは、多くの企業が1年で経験する以上のものだった。 01 「量は増やしても価格は変えない」の0.1 まず、K3.1 Proとは何かを明確にしておこう。これはまったく新しいモデルではない。月之暗面は明確に、K3.1 ProはK3の後学習版であり、基盤は変わっていないと述べている――依然として総パラメータ2.8兆、活性化パラメータ1,040億の混合エキスパートアーキテクチャ、文脈ウィンドウは100万トークン、画像および動画入力にもネイティブに対応している。 変わったのは後学習の部分だ。公式によれば、「大幅に増強された後学習用の計算能力」を投入し、数百の下流分野で大規模な共同強化学習を実施したという。そのため、強化学習フレームワーク、サンドボックスインフラ、長文脈推論といった基盤技術を一から再構築したのだ。つまり、同じ脳が、仕事のやり方を改めて“教え直された”ということになる。 その効果はランキングで明らかだ。プログラミングAIを評価するTerminal-Bench 4.0において、K3.1 Proは65.7%を獲得し、GPT-6 Astraの58.2%やClaude Opusの66.4%をわずか1ポイント弱下回る結果となった。前世代のK3は
2026年10月24日、研究者はarXivに論文arXiv:2610.30162v1を公開し、大規模言語モデルの融合手法の評価に特化した初の統一ベンチマークであるFusionEvalを提案しました。同ベンチマークは、推論チェーンの長さやツール呼び出しといった脆弱な部分を網羅しており、学習型と非学習型の融合手法の比較も可能にしています。

注目する理由:このベンチマークは、既存の評価において長鎖推論とツール利用へのカバーが不十分であった点を補完し、平均性能と最悪時の能力保持を明確に区別するとともに、Qwen3/Llamaに基づく再現可能な専門家プール、GPUメモリや実行時間などの多次元指標、およびオープンソースコードを提供しており、高い実践的指導性を備えています。
2026年10月24日にarXivに掲載された論文は、現在主流のコーディング・インテリジェンス・エージェント向けベンチマーク(たとえばSWE-Milestone)には「仕様–オラクルギャップ」が存在すると指摘している。すなわち、タスクの自然言語による記述には、テストに必要な重要な実装細部(例えば定数名、モジュールパス、正確なエラーメッセージなど)が含まれておらず、その結果、評価では上流のコードを再現する能力が測定されているにすぎず、真の理解力や推論能力が評価されていないという問題がある。
注目する理由:本研究は、この種のバイアスを初めて形式的に定義し、5言語をカバーする静的解析ツール(精度89.2%、再現率92.9%)を構築したうえで、SWE-Milestoneにおいて、25のマイルストーンタスクに推論不可能な暗黙的依存関係が存在することを実証的に明らかにしました。これにより、失敗率が大幅に上昇する(80.6%対48.4%)ことが示され、現在のランキングが「名前を真似る」タイプのエージェントを体系的に優遇している可能性が浮き彫りになりました。研究成果として、オープンソースの解析ツールと修正リソースが公開されており、方法論的価値と実践的価値の両面から貢献しています。
AIスタートアップ企業Recursiveは、オープンソースのコーディングモデル「Flint」を発表し、その開発プロセスは主に自社開発のAI研究システム「Eureka Machine」によって行われたと述べています。このモデルはパラメータ数がわずか400億で、実測では25億の活性化を有しており、M4 Pro MacBookなどの一般的なノートPCでもオフラインで動作し、推論速度は131トークン/秒に達します。また、SWE-Benchなどのベンチマークにおいて、同規模の多くのモデルを上回る性能を示しています。
OpenAIのGPT-6および6.1シリーズの最先端モデル(Astra、Sol、Luna)は、今後数週間以内にGoogle Cloud Model Gardenに導入され、Googleのエージェント駆動型プログラミングツールAntigravityにも統合される予定です。これにより、GoogleはGemini、Claude、GPTという三大クローズドソースの大規模言語モデルを同時に提供する初の主要クラウドサービスプロバイダーとなります。
Claude Mods は、Anthropic が提供する Claude Code のプログラマブルなプラグインシステムで、『Attention Interface』の初期形態を示しています。これは、従来の機械向けエージェント実行時フレームワーク(agent harness)から、人間の注意力に焦点を当てたカスタマイズ可能なインタラクション層へと転換したものです。ユーザーは TypeScript や JS を用いて Mods を作成したり、自然言語で Claude に自動生成を指示したりすることで、いつ中断されるか、どのような内容を閲覧するか、どのような意思決定を行うかを自在に制御できます。
Claude Mods は、Anthropic が提供する開発者向けのプログラマブルなプラグインシステムであり、エージェントハーネスがマシン側のインターフェースから人間側のインターフェース――すなわち「アテンション・インターフェース」(Attention Interface)――へと移行したことを示しています。これにより、ユーザーは TypeScript/JavaScript を用いて Claude Code の動作やレンダリング、インタラクションロジックをカスタマイズし、人間とAIが共同でワークフローを設計できるようになります。この仕組みは、You Should Know などの組み込み機能にもすでに活用されており、ユーザーによる独自の構築や、Claude の支援によるプラグインの生成もサポートしています。
Reflection社は、オープンソースの大規模言語モデル「Beam」(パラメータ数5,010億、実際のアクティベーションは230億/トークン)を発表しました。同モデルは256エキスパートによるスパースMoEアーキテクチャを採用し、100万トークンのコンテキスト長、NVFP4/FP8量化、多段階の推論オプション設定、およびローカルデプロイメントをサポートしています。ただし、すべての技術的主張は第三者による検証を受けておらず、ハードウェア要件も高いため、一般ユーザーには負担が大きいとの見方が広く示されています。