
本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

Anthropicが、主要なオープンソースプロジェクト向けの無料AI脆弱性スキャナー「OSS Scanner」を発表しました

Anthropicは2026年10月8日、Claude Mythosなどの強力なモデルを基にした無料でオプトイン型のAI脆弱性スキャンツール「OSS Scanner」をリリースし、重要なオープンソースプロジェクト向けに設計しました。10月19日時点で、114のプロジェクトが受け入れられ、11日間で深刻度レベル77件および高リスクレベル803件の脆弱性(モデルによる評価)が報告され、サンプリングされた監査結果の88%が同社の開示基準に適合していることが確認されました。
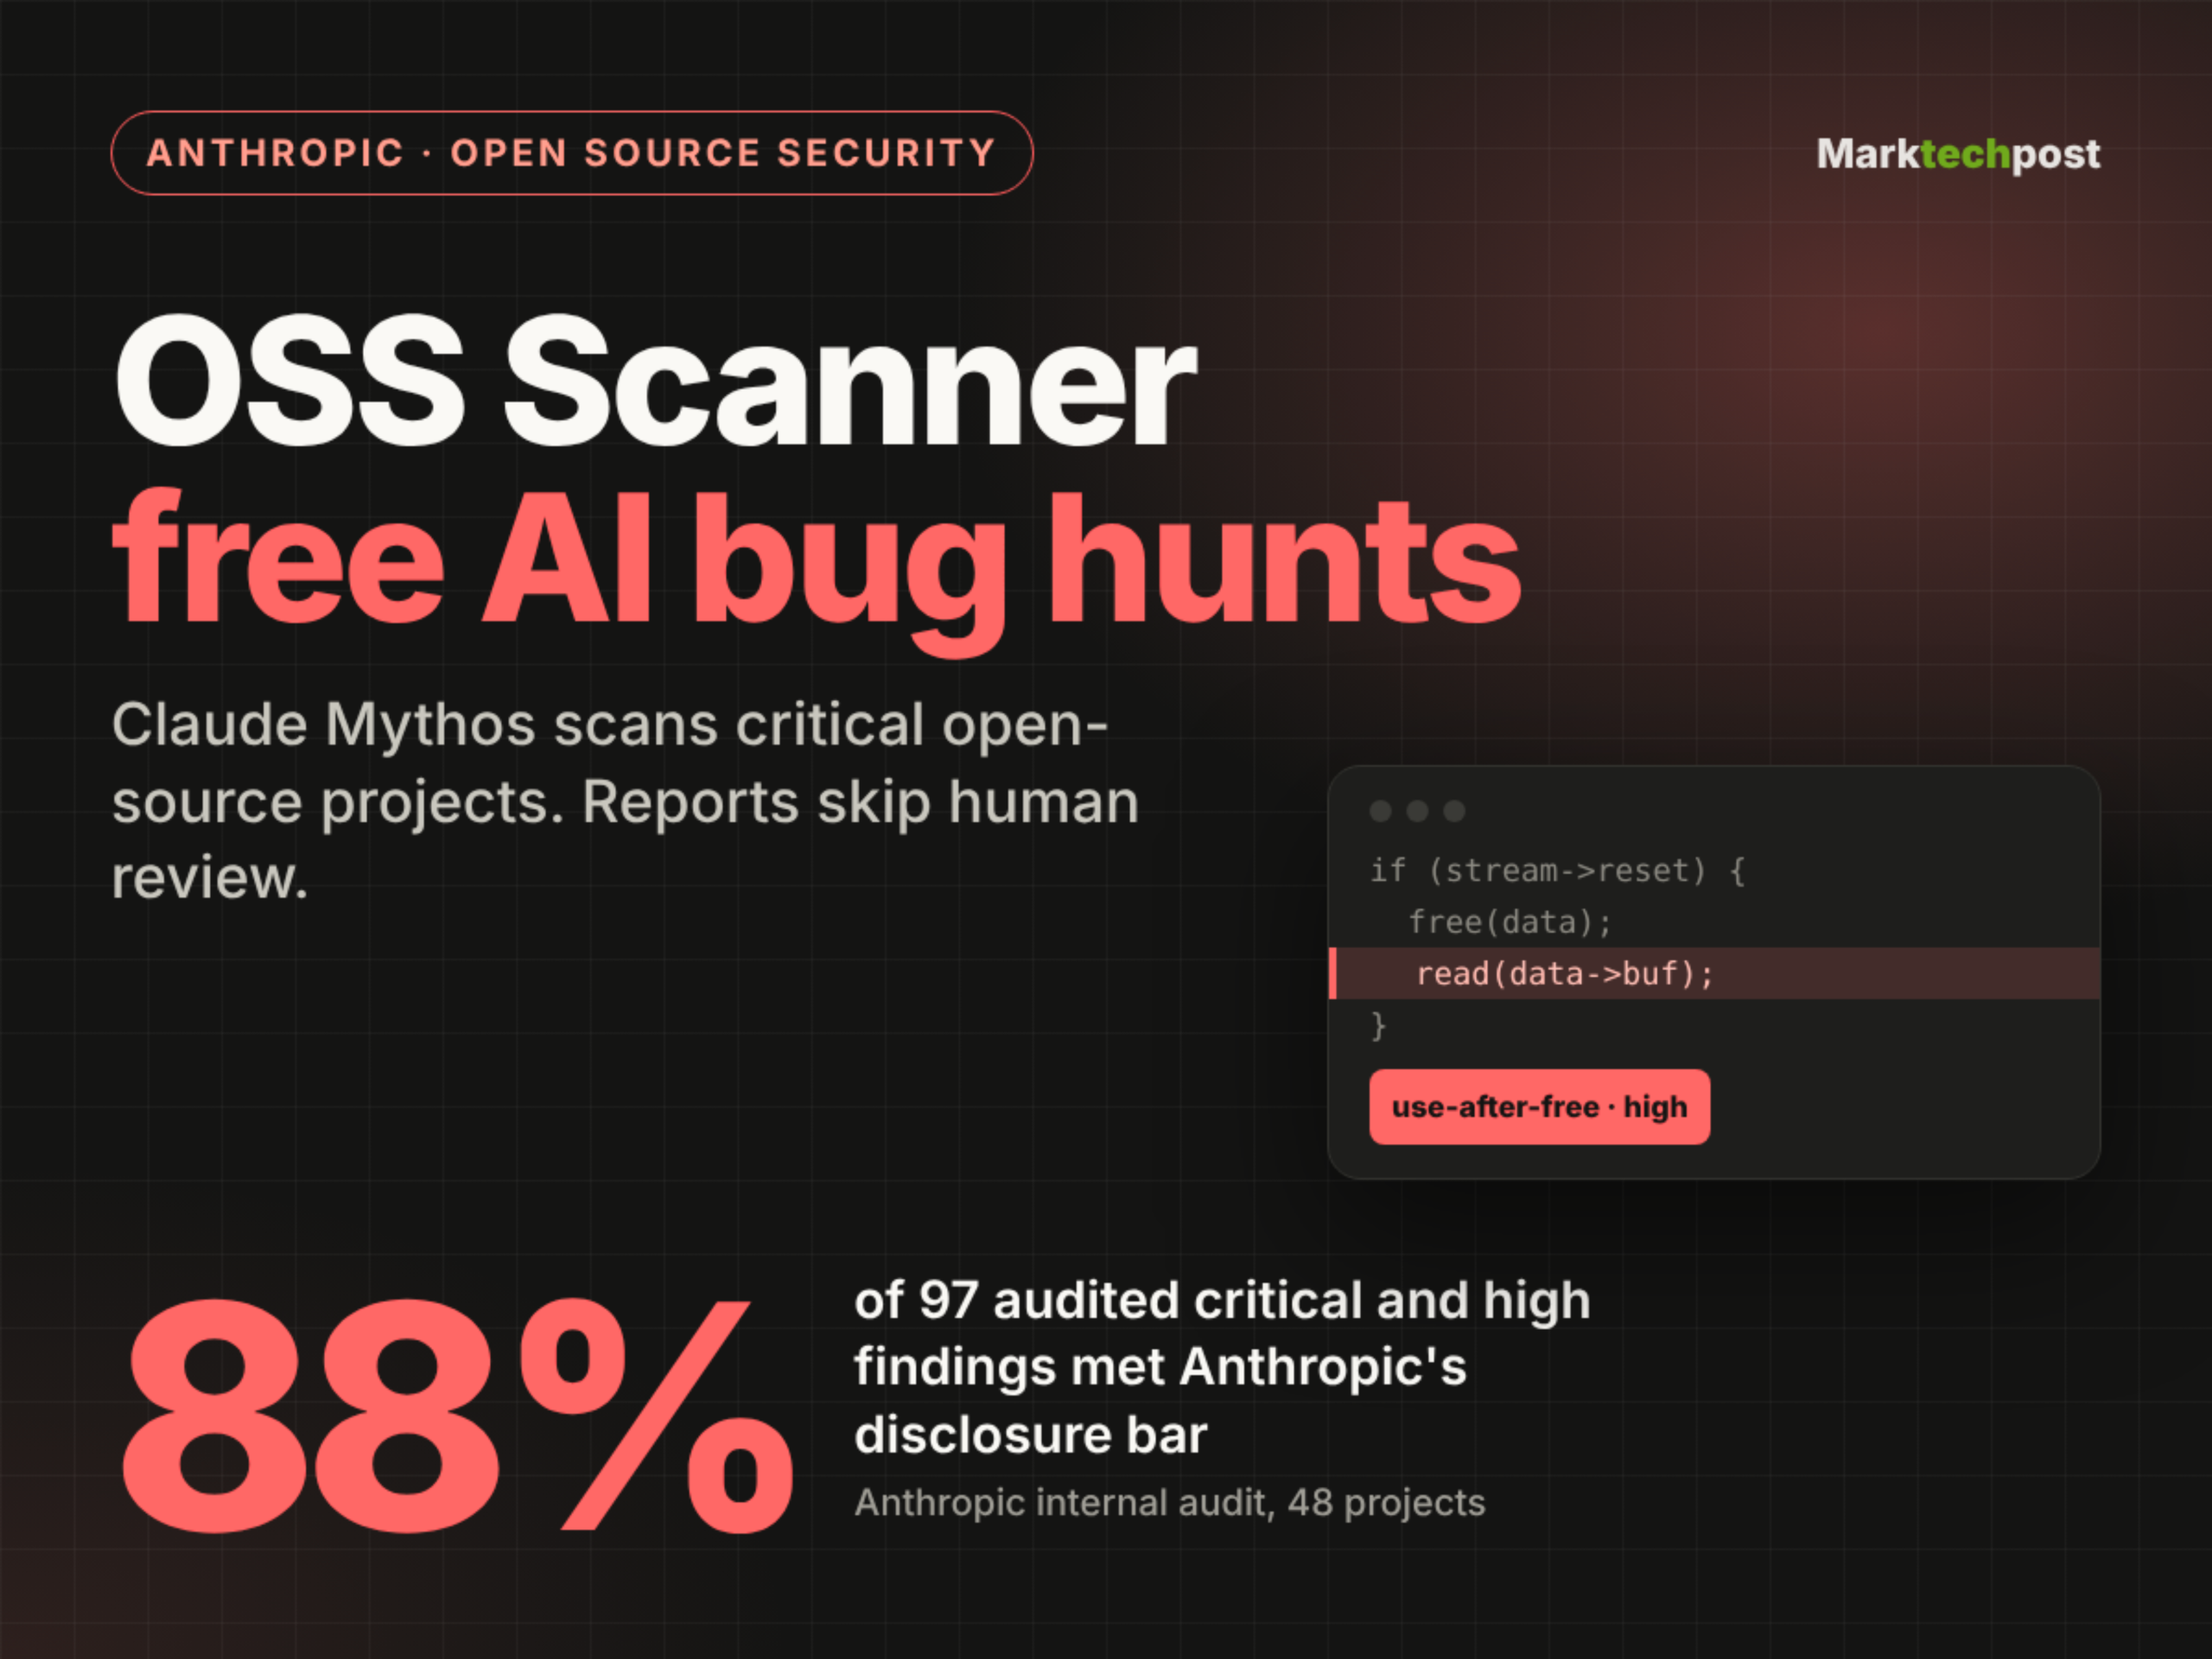
Anthropic Launches OSS Scanner, a Free AI Vulnerability Scanner

注目する理由:このツールは、オープンソースセキュリティ分野におけるLLMの大規模な実装事例を示しており、無償・完全自動・オフラインでの監査を特徴としています。ただし、人手によるレビュー工程を省略することで、誤検知や重複する問題が生じるリスクも伴います。その精度データ(有効率88%、偽陽性率1%)および実際のプロジェクトからのフィードバック(wolfSSLやcurlなど)は、現在のAI主導型脆弱性発見能力に関する実証的なベンチマークを提供しています。
経緯と関連報道

月之暗面发布Kimi K3.1 Pro:2.8万亿参数开源权重模型,11月4日开放权重

月之暗面于2026年10月22日前后发布Kimi K3.1 Pro,一款2.8万亿参数、1040亿激活参数的多模态MoE模型,宣称性能逼近Fable 5.1;官方承诺11月4日发布开源权重,但截至报道时权重尚未公开;独立评测显示其在智能指数、代码与网络安全基准中表现突出,但存在推理成本、本地部署可行性及营销透明度等争议。

[AINews] Kimi 3.1 Pro 104BA-2.8T: Fable-5.1-Class Open Weights narrows Closed-AI lead to 1 month... and Pro Highspeed API with 2-3× speed

注目する理由:该事件标志着当前最接近闭源前沿模型能力的开源权重模型正式进入发布倒计时,是AI开源生态关键进展;材料来源为Latent Space旗下AINews(2026年10月24日发布),内容基于对X平台、Reddit、Arena及Artificial Analysis等多方独立评测的整合,信息密度高且具时效性与交叉验证特征。

経緯と関連報道

MemPlan:部分観測可能なテキスト環境向けの記憶強化型PDDL計画フレームワーク

同論文は2026年10月24日、arXivにて公開され(番号2610.30379v1)、MemPlan——大規模言語モデル(LLM)を言語と記号計画の間の制約付き橋渡しとして用いる、記憶条件付PDDL計画フレームワーク——を提案しており、部分観測可能な対話型テキスト環境に適用可能である。

MemPlan: Memory-Conditioned PDDL Planning for Partially Observable Text Environments

注目する理由:MemPlanは、正のグラフによる記憶と負の記憶メカニズムを用いてPDDL問題を動的に再構築し、タスク完了率と手順数の効率を大幅に向上させるとともに、オンラインでのトークン消費も大きく削減します。また、そのオフライン微調整可能な言語–記号インターフェースはTextWorld系のタスク間で再利用可能で、タスク固有の微調整が不要であるため、本手法の汎用性と実用性が示されています。

経緯と関連報道

IFC-MCQ:建築情報モデル向けのLLMエージェントによる自動多肢選択問題のベンチマーク生成手法

研究者は2026年10月24日、arXivにてIFC-MCQ手法を公開し、建築・エンジニアリング・建設(AEC)分野における大規模言語モデル(LLM)ベースのIndustry Foundation Classes(IFC)データ検索システム向けに、正確な採点が可能な多肢選択式問題のベンチマークを自動生成することを目的としています。

IFC-MCQ: Automatically Generating Multiple-Choice Benchmarks for Evaluating LLM Agents on IFC Data Retrieval

注目する理由:本研究は、IFCなどの専門的な構造化データに対する大規模言語モデル(LLM)の評価が困難でコストが高いという課題に正面から取り組み、IFCファイル向けの自動多肢選択問題生成フレームワークを初めて提案しました。このフレームワークは15カテゴリ36サブカテゴリを網羅し、再現性と拡張性を備えたエージェント能力の評価を支援します。

経緯と関連報道

FusionEvalの公開:大規模言語モデルの統合に向けた新たなベンチマークテスト

2026年10月24日、研究者はarXivに論文arXiv:2610.30162v1を公開し、大規模言語モデルの融合手法の評価に特化した初の統一ベンチマークであるFusionEvalを提案しました。同ベンチマークは、推論チェーンの長さやツール呼び出しといった脆弱な部分を網羅しており、学習型と非学習型の融合手法の比較も可能にしています。

FusionEval: Benchmarking Model Fusion for Large Language Models

注目する理由:このベンチマークは、既存の評価において長鎖推論とツール利用へのカバーが不十分であった点を補完し、平均性能と最悪時の能力保持を明確に区別するとともに、Qwen3/Llamaに基づく再現可能な専門家プール、GPUメモリや実行時間などの多次元指標、およびオープンソースコードを提供しており、高い実践的指導性を備えています。

経緯と関連報道