
NVIDIA DGX SparkにおけるMoE推論を強化する3つの方法
トークンの生成をより高速化するには、まず推論性能を制限している要因を特定することから始まります。NVIDIA上でInclusion AIが実施したLing-3.0-flashのバッチサイズ1による評価では…
見出し・要約・本文から、情報のつながりを探します。
トークンの生成をより高速化するには、まず推論性能を制限している要因を特定することから始まります。NVIDIA上でInclusion AIが実施したLing-3.0-flashのバッチサイズ1による評価では…
Mirendilは、1,000万トークンのコンテキストウィンドウでゼロから事前学習された初のモデルであるFern 0.1をリリースしました。同モデルはエージェント型AIの研究開発を対象としており、1,000万トークン規模でのRULERシングルニードルテストでは100%のスコアを獲得していますが、エージェント型コーディングにおいては最先端モデルには及ばない結果となっています。この記事「Mirendil、1,000万トークンのコンテキストを持つ初のモデルFern 0.1を公開」は、MarkTechPostに最初に掲載されました。
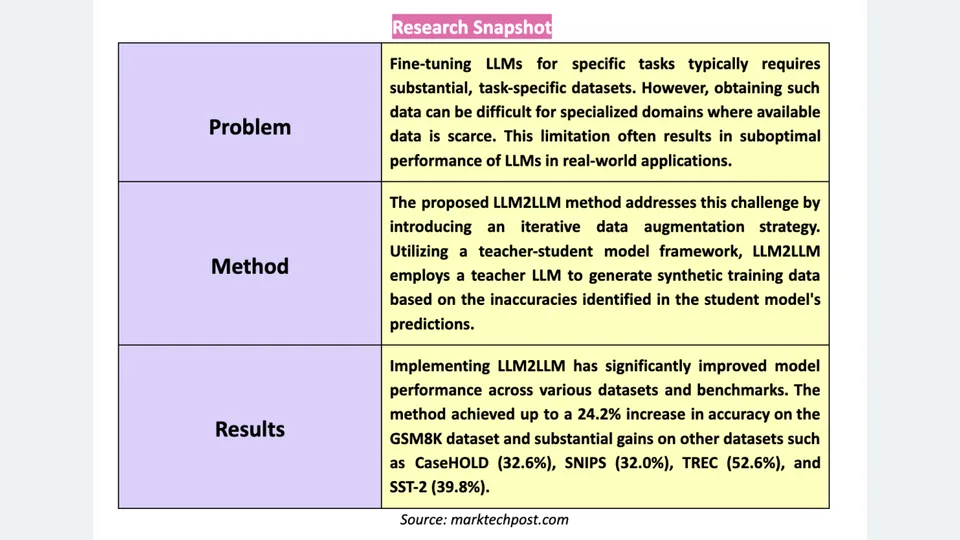
旧ランキングのスコアは満点に迫るも、新ランキングの実戦評価では軒並み不合格。大規模モデルの評価自体がビジネス化するなか、企業の選定基準はランキングを見る時代から、コスト計算へと移りつつある。
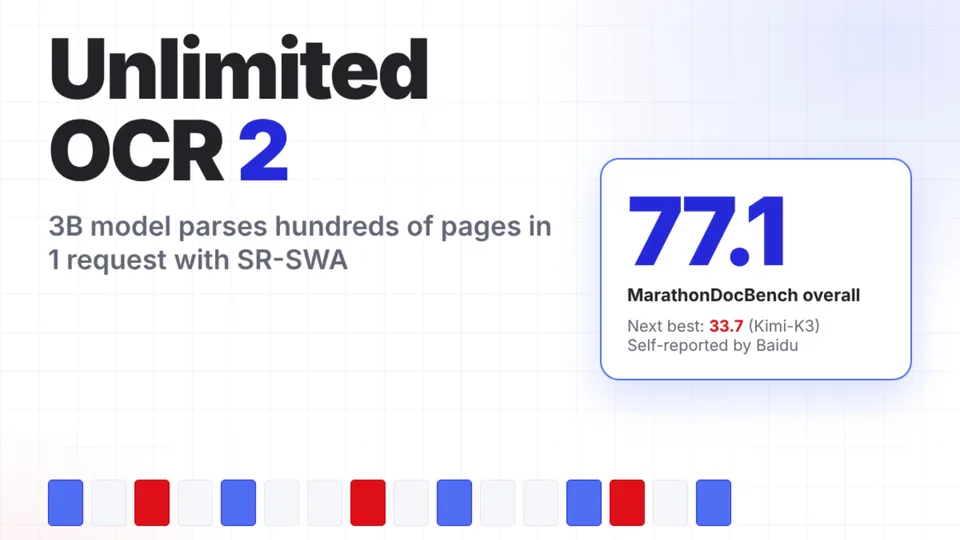
Baiduは、MITライセンスの3B規模のOCRモデルであるUnlimited OCR 2をリリースし、1回のリクエストで数百ページに及ぶ文書を解析できます。同モデルのSR-SWAアテンションにより、各ステップのデコーディングコストはほぼ一定に保たれ、MarathonDocBenchでは77.1点を獲得しています。この記事「Baidu、数百ページの文書解析向けUnlimited OCR 2をオープンソース化」は、MarkTechPostに最初に掲載されました。
arXiv:2610.33014v1 発表タイプ:新規 要旨:交渉支援システムは、相手の反応を正確に予測しなくても良好な取引を成立させることができる。そこで、社会的世界モデルに対する評価がその予測を直接検証しているのかという疑問を提起する。1999年から2026年にかけて発表された113件の研究を調査したところ、9件の主要な評価では、システムまたは実験者が選択した行動に対する実際の人の反応が測定されていた。そのうち、明示的な反応予測と実際の反応を比較しているのはわずか2件であり、しかもそれらの予測手法は行動選択時に利用可能な情報を用いており、評価対象の反応は適合過程から除外されていた上、介入手法もランダム化されていた。さらに、言語モデルに関する25件の研究について全文を個別に確認した結果、これらの条件を満たす実験は見当たらなかった。他の評価は、現状推論やタスク成功、あるいは予測機能の評価を行っているにすぎない。
arXiv:2610.33004v1 発表タイプ:新規 要旨:光学文字認識(OCR)は歴史的アーカイブのデジタル化において不可欠であるが、文字誤り率(CER)などの標準的な評価指標だけでは、氏名や日付、識別子といった有意義な情報が確実に保持されているかどうかを必ずしも反映できない。本研究では、歴史文書におけるOCR品質を評価するための補完的な視点として、OCRエラーのエンティティレベルでの分析を検討する。公開されているBerruttiアーカイブの175件の文書から構成されるベンチマークを用い、受理後に公開予定の手動でアノテーションされた5,209件のエンティティ言及を追加することで、逐次認識型OCRシステム、OCR専用の視覚言語モデル、および汎用の視覚言語モデルを比較する。全体的な転写精度にとどまらず
Data Cultureは、AI分析の導入における精度を0%から94.7%に向上させた3段階の評価フレームワークを構築しました。
Nace AIは、Drex for Searchをリリースし、同社のDrex意思決定モデルをAIエージェント向けのドキュメント検索に導入しました。Naceによると、BrowseComp-Plusでは12.6回の検索呼び出しで92.05%のスコアを達成しており、OfficeQA Proではエージェントの操作回数がさらに減少しています。この記事「Nace AI、AIエージェント向けDrex for Searchをリリース:BrowseComp-Plusで12.6回の検索呼び出しで92.05%」は、MarkTechPostに最初に掲載されました。
著者|宇航猿 編集|靖宇 10月23日午前、Kimi公式はXとビデオ番号で24秒の動画を公開した。映像にはレトロな雰囲気の古いパソコンが映り、画面にはKimi Codeが起動し、端末にはThree.jsのコードが一行ずつ表示され、複雑な3Dシーンが生成されていく様子が映っていた。目ざといネットユーザーはすぐに左上隅のモデル欄で答えを見つけた――「Model: Kimi K3.1」だ。 Kimi公式が公開したK3.1の事前告知動画|画像出典:X @Kimi_Moonshot 古い時代の機械で、今日最先端の3Dコードを実行する――このギャップこそが、月之暗面が伝えたいメッセージそのものだった。 それから十数時間後、10月24日零時を過ぎた直後、プログラマーの日に合わせてKimi K3.1 Proが正式にリリースされ、同時に速度が2〜3倍速いHighspeed版も同時に登場した。公式は、完全なモデルの重み付けデータを11月4日までに公開すると約束している。 前世代のK3が発表されてから、すでに3か月以上が経過していた。この3か月間、月之暗面が経験したことは、多くの企業が1年で経験する以上のものだった。 01 「量は増やしても価格は変えない」の0.1 まず、K3.1 Proとは何かを明確にしておこう。これはまったく新しいモデルではない。月之暗面は明確に、K3.1 ProはK3の後学習版であり、基盤は変わっていないと述べている――依然として総パラメータ2.8兆、活性化パラメータ1,040億の混合エキスパートアーキテクチャ、文脈ウィンドウは100万トークン、画像および動画入力にもネイティブに対応している。 変わったのは後学習の部分だ。公式によれば、「大幅に増強された後学習用の計算能力」を投入し、数百の下流分野で大規模な共同強化学習を実施したという。そのため、強化学習フレームワーク、サンドボックスインフラ、長文脈推論といった基盤技術を一から再構築したのだ。つまり、同じ脳が、仕事のやり方を改めて“教え直された”ということになる。 その効果はランキングで明らかだ。プログラミングAIを評価するTerminal-Bench 4.0において、K3.1 Proは65.7%を獲得し、GPT-6 Astraの58.2%やClaude Opusの66.4%をわずか1ポイント弱下回る結果となった。前世代のK3は
2026年10月26日、arXivは論文arXiv:2610.31838v1を公開し、Sense-Aligned Grounding Evaluation(SAGE)——統一された10候補画像選択基準——を提案するとともに、名詞・動詞・実体中心の多モーダルなグラウンディング評価を実施するための、学習非依存型のGloss-Augmented Reasoning(GAR)フレームワークも併せて提示した。

注目する理由:本研究は、VWSD、VerSe、WikiDiverseの3種類のタスクを用語中心のグラウンドトゥルース評価プロトコルに統一し、混同行動による難負例の導入とコンテキスト交換による診断メカニズムを提案しました。さらに、定義の強化と制約による推論の誘導が協調して作用することでHits@1指標を大幅に向上させること(65.90→71.22)を実証し、マルチモーダルな意味対応の評価においてより細粒度で解釈可能な新たなパラダイムを提供しています。
2026年10月24日、研究者はarXivに論文arXiv:2610.30162v1を公開し、大規模言語モデルの融合手法の評価に特化した初の統一ベンチマークであるFusionEvalを提案しました。同ベンチマークは、推論チェーンの長さやツール呼び出しといった脆弱な部分を網羅しており、学習型と非学習型の融合手法の比較も可能にしています。

注目する理由:このベンチマークは、既存の評価において長鎖推論とツール利用へのカバーが不十分であった点を補完し、平均性能と最悪時の能力保持を明確に区別するとともに、Qwen3/Llamaに基づく再現可能な専門家プール、GPUメモリや実行時間などの多次元指標、およびオープンソースコードを提供しており、高い実践的指導性を備えています。
2026年10月24日、arXivは論文arXiv:2610.30970v1を公開し、パラメータ数が1,700万から10億の範囲にあるコンパクトなエンコーダーについて、閉じた集合における意思決定タスク(例:ツール選択)において、すべての選択肢を同時に評価する方式と、個々に独立してスコアリングする方式の設計選択を体系的に評価した。研究結果によると、3,200万のパラメータ規模では、個別選択肢スコアリングの方がスキル指標において統合スコアリングを有意に上回る一方で、計算負荷が高く、遅延のばらつきも大きいことが示された。さらに、複数のSystem1-Arenaベンチマークにおいて、6,800万および1億5,000万のパラメータを持つ統合型エンコーダーが、4億3,500万のパラメータを持つDeBERTa-v3のゼロショット分類器を上回ることが明らかになった。
注目する理由:本論文は、現行の大規模モデルにおける下流の意思決定モジュールの軽量化設計に関する重要な実証比較を提示しており、アーキテクチャの選定、初期化への依存性、遅延と精度のトレードオフ、入力順序に対するロバスト性といった工学上の重要課題を網羅しています。データは3つのランダムシードによる実験および公開・非公開のベンチマークに基づいて検証されており、公開日時(2026年10月24日)は現在のUTC日付(2026年10月25日)と一致しており、最新かつ信頼性の高い研究進展に該当します。
AIスタートアップ企業Recursiveは、オープンソースのコーディングモデル「Flint」を発表し、その開発プロセスは主に自社開発のAI研究システム「Eureka Machine」によって行われたと述べています。このモデルはパラメータ数がわずか400億で、実測では25億の活性化を有しており、M4 Pro MacBookなどの一般的なノートPCでもオフラインで動作し、推論速度は131トークン/秒に達します。また、SWE-Benchなどのベンチマークにおいて、同規模の多くのモデルを上回る性能を示しています。
NVIDIAは、企業向けリレーショナルデータベース上で離職予測、不正検知、需要予測などの予測タスクを直接実行できる、事前学習済みのリレーショナル基礎モデル「Kumo Relational」を発表しました。タスクの微調整や特徴量エンジニアリング、テーブルの平坦化は不要です。15のデータベースにまたがる41のベンチマークにおいて、XGBoostなどの教師ありモデルを総合的に上回り、SAP SALTの企業向けベンチマークではMRR指標でAutoGluonを8%上回りました。また、最大5,000億行規模のデータベースに対応し、Predictive Query Language(PQL)によりコードゼロで予測呼び出しを実現します。
IBM研究所はALTK-Evolve手法を提案し、GPT-4.1を用いて自らのタスク履歴から構造化された行動ガイドライン(認証や返金確認など)を自動的に抽出し、純粋なプロンプト工学の手法でReActエージェントシステムに組み込むことで、モデルの重みを更新せず、人手によるラベル付けにも依存せずに、カスタマーサポートタスクの精度と信頼性を大幅に向上させました。同手法の小売分野における評価結果はPass⁴スコア67.5%で、τ²-bench 2026年10月12日版のランキング首位となり、最先端のモデルおよび微調整済みシステムをすべて上回りました。
MentalHealthBenchは、現実的な精神的な健康会話を横断して、有用で安全なAI応答を評価するための専門家の知名度の高いベンチマークです.
英国AISI と EvalEval が Benchmark の結果を再現可能な方法
OpenAIは、グローバルなAI基準の共有経路を概説し、評価、報告、ガバナンスの調整を行い、安全性の向上を図っています.