
本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

インフィニオンとWolfspeedが契約を更新:200mmシリコンカーバイドウェハの供給契約が成立

インフィニオンとWolfspeedは2026年10月15日、炭化ケイ素ウェハの供給契約を拡大・延長すると発表し、協力を150mmから200mm規格へと拡張する。これにより、インフィニオンの200mm製造への移行を支援し、サプライチェーンの弾力性を強化する。一方、Wolfspeedはこの取り組みを通じて、主要顧客における200mm材料の長期的な活用を拡大するが、同社の材料事業は依然として売上高の減少とマイナスの粗利益率という圧力に直面している。


英飞凌续约Wolfspeed:200mm碳化硅的“下一关”英飞凌续约Wolfspeed:200mm碳化硅的“下一关”

注目する理由:この事件は、世界的な炭化ケイ素産業における競争の重心が正式に大サイズ基板および製造工程へと移行したことを示しており、サプライチェーンの上流・下流が協調して200mmウェーハの量産を推進するための重要なシグナルである。材料の出所は明確であり(ティーメディア、2026年10月25日掲載)、すべての事実は原文に記載された時間・主体・データおよび制約条件に厳密に照らし合わせており、推論や補完、拡張は一切行っていない。
経緯と関連報道

パネルメーカー各社は、AIによる上流コストの圧迫に対応するため一斉に価格を引き上げているが、下流の受け入れ度は低く、端末製品の品質管理にも圧力がかかっている

2026年9月以降、TCL華星、京東方、惠科などのパネルメーカーが相次いで値上げ通知を発表しています。その主な要因は、AI大規模モデルの発展に伴うHBM需要の急増により、成熟プロセス向け半導体の生産キャパシティが逼迫し、ドライバIC、PCB、ガラス基板など主要部材の価格が上昇していることです。同時に、コーニングをはじめとする上流サプライヤーも一斉に価格を引き上げています。コスト面での圧力は明確ですが、下流のテレビ/ディスプレイブランドによる調達価格は広く値上がりしておらず、端末ユーザーからは過熱やブラックスポットといった品質管理上の問題が頻発しているとの不満が寄せられています。そのため、値上げはまだ実際の取引価格の上昇や体験の向上には反映されていません。

AI大模型狂飙,面板行业也扛不住了

注目する理由:材料システムは、AI産業が直接的な関連性のないハードウェア業界に及ぼすクロスチェーンによる伝播メカニズムを明らかにした——AIによるパネル需要の押し上げではなく、ウェハ生産能力の再配分を通じて全チェーンにわたるコストの再設定が引き起こされているのだ。同時に、価格上昇の動きと市場の実際の反応(価格の硬直化、出荷の減少、ユーザーからの苦情)との間に顕著な乖離が存在することも示しており、産業における交渉力と製品力の不一致という深い矛盾を浮き彫りにしている。

経緯と関連報道

米国のデータセンター反対運動が参考にできる世界的な経験:アイルランドの電力網危機からニュージーランドの地域コミュニティにおけるAI活用事例まで

パリス・マークスは『超大規模』において、世界のデータセンターをめぐる抗争の歴史を整理し、アイルランドでは送電網の容量が飽和したため規制が導入され、企業が代わりに自家用のガス火力発電所を建設する事例を指摘している。一方、ニュージーランドでは、地元クラウドを活用してマオリ語の音声認識を支援する、搾取的でないAIの道筋が模索されている。さらに、現在米国で広がっている反対の波は、実は以前から予兆されていた世界的な矛盾の再現にすぎない。

経緯と関連報道

llama.cpp 发布 b11871 版本:新增 JSON 嵌套深度限制以防止服务崩溃

llama.cpp 在 b11871 版本中引入关键安全修复,对请求中 JSON 嵌套层级实施 128 层硬性限制,避免因深度递归解析导致 HTTP 线程栈溢出、服务崩溃(macOS 触发 SIGBUS,Linux 触发 SIGSEGV)。该策略覆盖 chat 接口多类输入场景,并统一返回 HTTP 400 错误。

注目する理由:按信源设置仅收录,不参与自动精选

経緯と関連報道

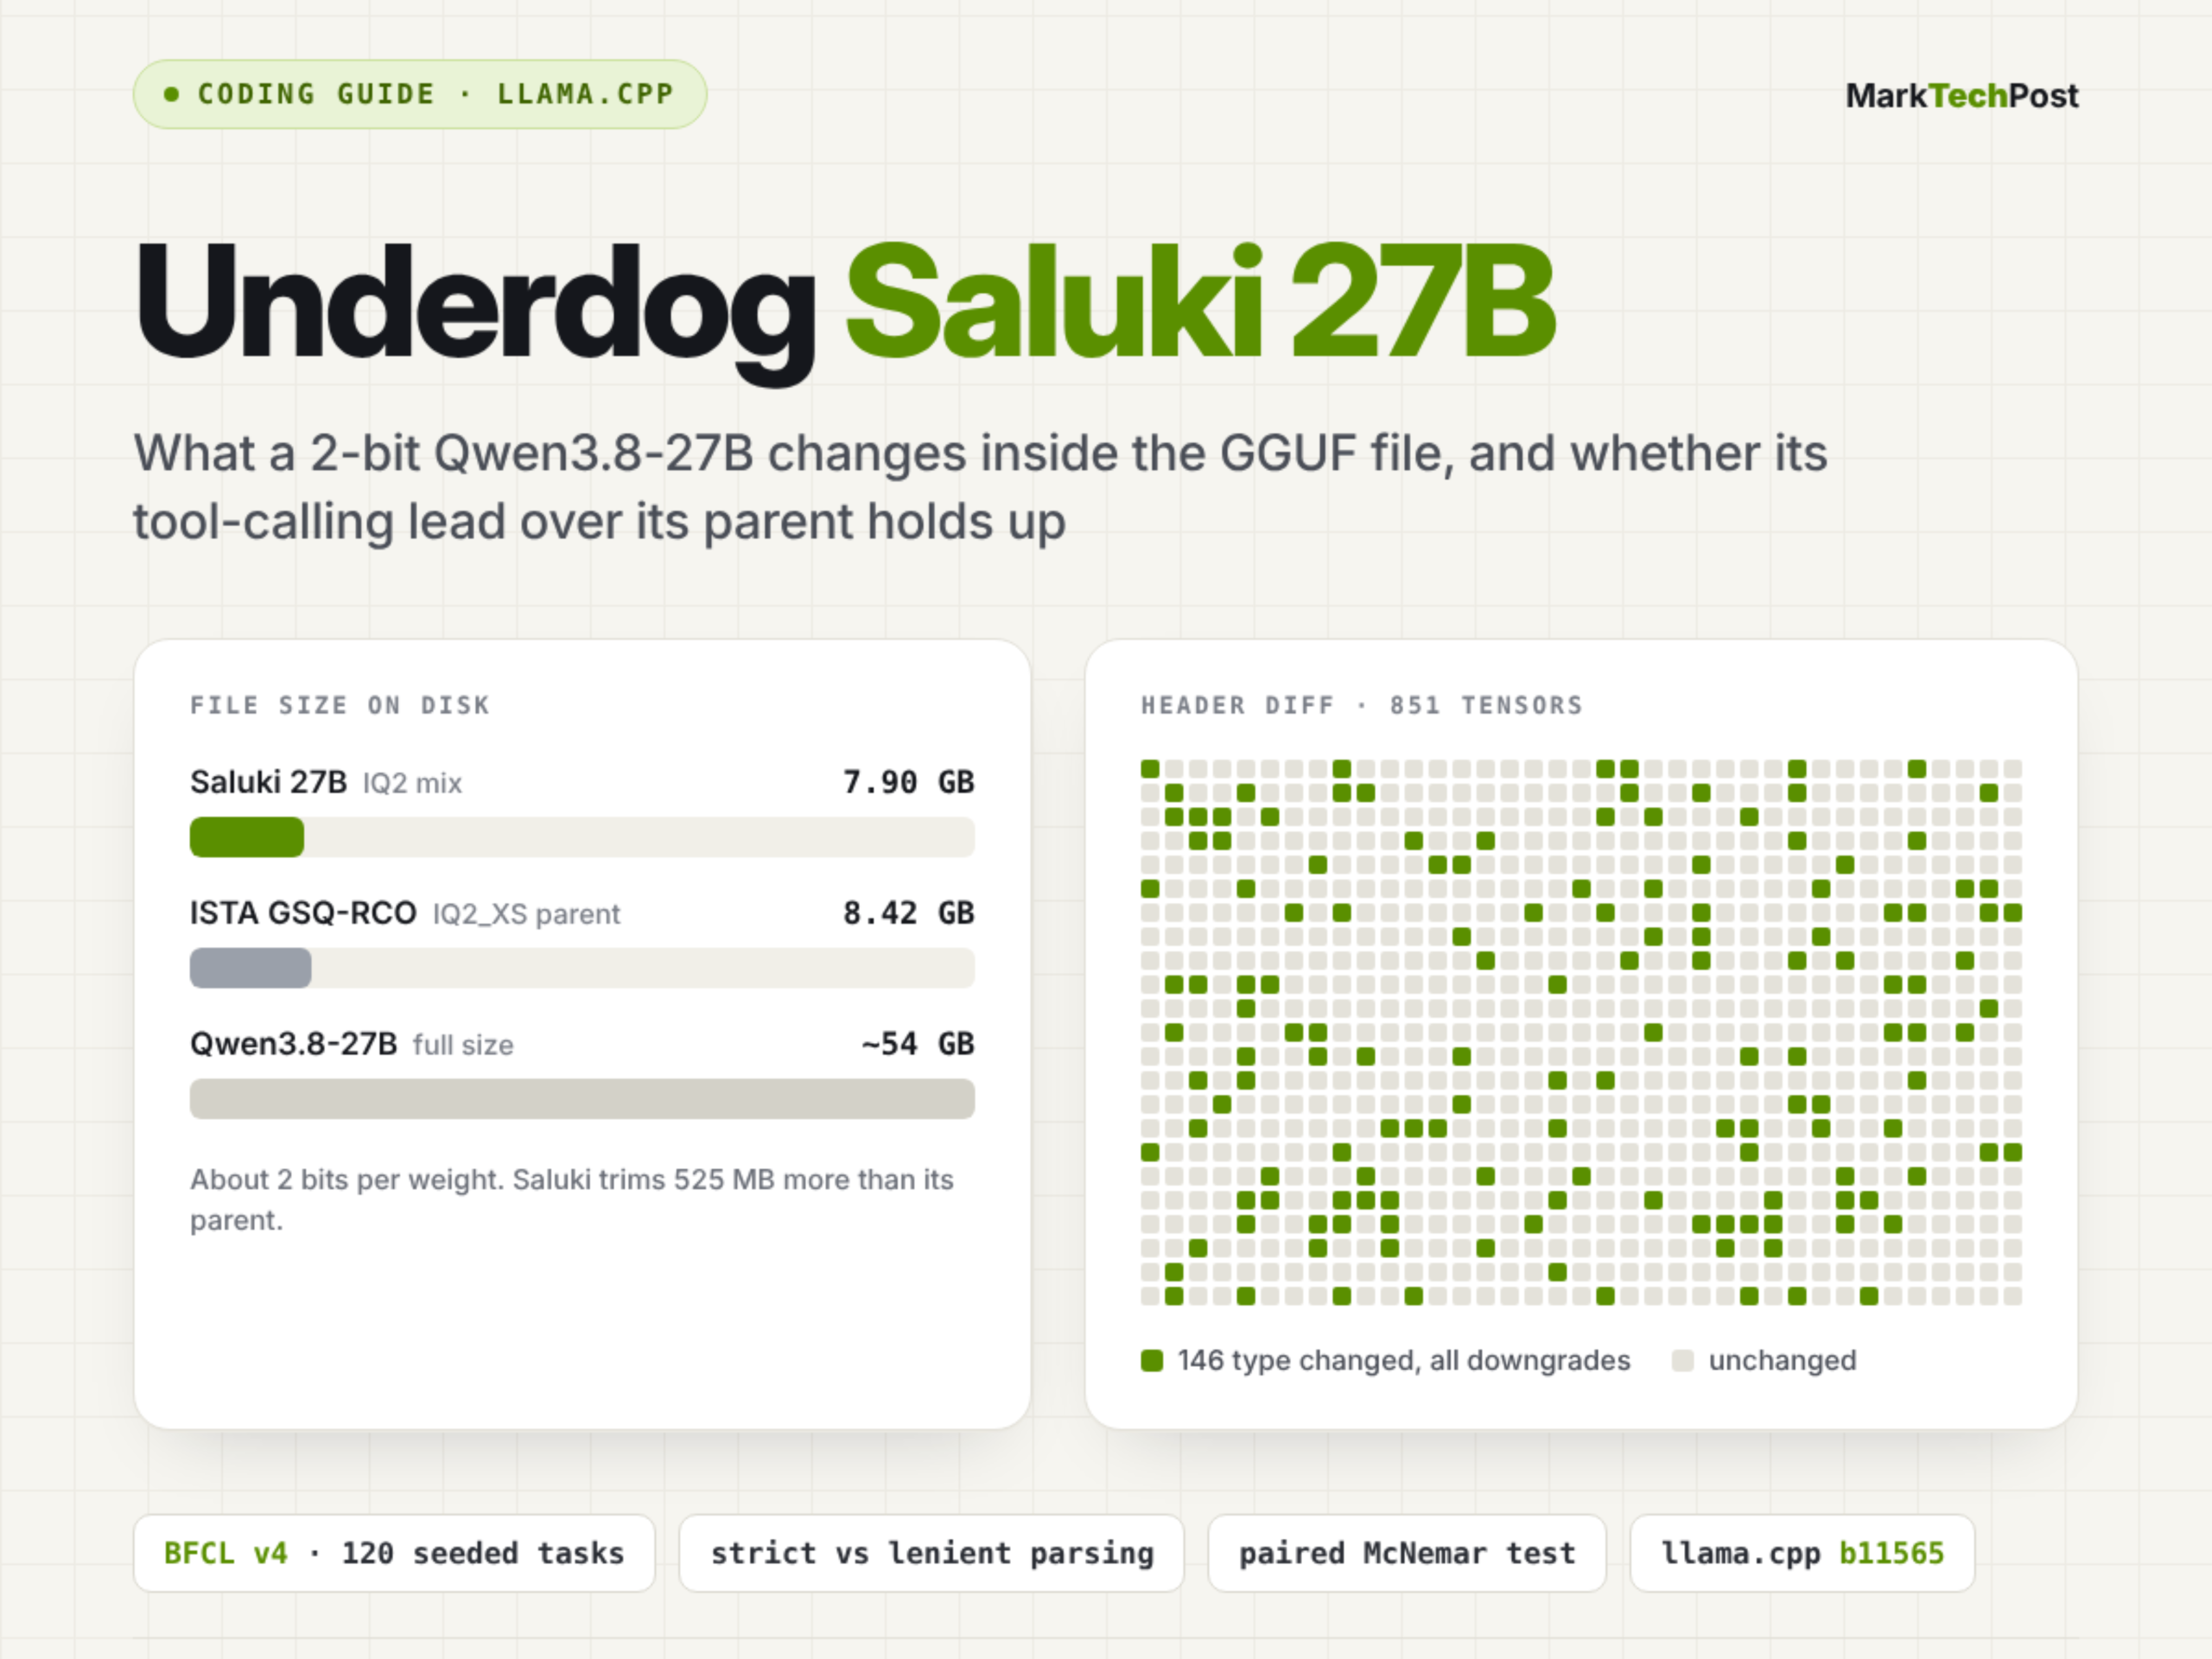
アンダードッグ・サルキ27B:GSQ-RCOをベースとした2ビットQwen3.8-27Bのツール呼び出しモデルに関する技術解説

本記事では、Underdogが公開したSaluki 27Bモデル——7.9 GBの2ビット量子化を採用したQwen3.8-27Bの変種——について紹介します。同モデルはISTA-DASLabのGSQ-RCO手法を用いて構築されており、120タスクにおけるBFCL v4ツール呼び出しベンチマークにおいて、元の54 GBのフル精度モデルを上回るとされています。ただし、すべての性能に関する結論は開発者による声明に基づくものであり、独立した検証は行われていません。

How to Run Underdog Saluki 27B: 2-Bit Qwen3.8-27B Tool-Calling Guide
経緯と関連報道

llama.cpp 发布 b11870 版本,正式支持 DeepSeek-V4.1-Flash 模型

llama.cpp 在版本 b11870 中新增对 DeepSeek-V4.1-Flash(deepseek41)模型的支持,并针对其 Engram 架构进行多项底层优化,包括 KV 缓存计算简化、BF16 精度替代 MXFP8、in-graph 行 gather 等;同步提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的多平台二进制构建。

注目する理由:按信源设置仅收录,不参与自动精选

経緯と関連報道

llama.cpp 发布 b11868 版本:增强 Hexagon NPU 多核 Flash Attention 支持,覆盖全平台编译构建

llama.cpp v2.45.0(标签 b11868)正式发布,核心更新为 Hexagon 后端引入 KV-head 团队拆分机制以优化多核 HMX Flash Attention 性能,并统一 FA 拆分控制标志;同步提供 macOS、Linux、Windows、Android、iOS 及 openEuler 等全平台二进制包,含 CUDA 12/13、Vulkan、ROCm、OpenVINO、SYCL、Snapdragon(Adreno+Hexagon)等多后端支持。

注目する理由:按信源设置仅收录,不参与自动精选

経緯と関連報道

llama.cpp 发布 b11867 版本:服务端入口重构,全面支持多平台与异构加速后端

llama.cpp 于 GitHub 正式发布 b11867 版本,核心变更包括服务端(server)入口点重构(PR #31113),新增 server_role 机制;同时提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的 40+ 预编译二进制包,支持 CPU、CUDA(12.4/12.8/13.4)、Vulkan、ROCm 10.0、OpenVINO、SYCL(FP16/FP32)、Snapdragon(Adreno+Hexagon)等多元硬件后端。

注目する理由:按信源设置仅收录,不参与自动精选

経緯と関連報道

llama.cpp 发布 b11866 版本:移除 Metal 后端冗余 AMAX 缩放逻辑,精简 MoE 计算路径

llama.cpp v.b11866 移除了 Metal 后端中已过时的 src1 power-of-two AMAX 缩放机制,转而依赖计算图内更精细的 per expert-token amax 缩放,确保 MoE 下投影激活值在 f16 表示范围内;同步删除相关两阶段归约核、F32 精度调度及越界测试用例。

注目する理由:按信源设置仅收录,不参与自动精选

経緯と関連報道